Best Buy商品数据提取:用Python解析JSON-LD并导出CSV
2026年9月24日 · 教程 · 20 分钟阅读
使用Best Buy爬虫整理商品数据时,首先要确认抓到的是哪件商品、哪位卖家的报价。商品页上的售价、月供和保护计划费用往往挨得很近;如果把月供当成售价,后续比价就会失去意义。
本文从核对商品信息开始,介绍如何用Python读取已获授权保存的HTML或JSON-LD文件,提取商品及报价信息,并导出CSV。示例运行在本地,适合先验证字段解析的开发者;自动请求网页和批量翻页不在本示例的实现范围内。
核心要点: 核对SKU、卖家和商品成色后,再提取价格与货币。脚本只处理指定SKU,每条独立报价保存一行;必填字段不完整时停止导出,可选字段留空。导出的文件还会记录来源文件、数据采集时间、地区和导出时间,方便以后核对。
采集Best Buy商品数据,可以从哪里入手?
如果只是验证几个字段,可以先保存获准使用的页面数据,在本地调试解析代码。需要持续采集或批量整理商品信息时,可先评估官方的Best Buy Products API。截至2026年9月24日,官方开发者页面仍列有该接口;使用前需要申请有效的API Key,并确认数据使用范围、请求限额和存储要求。该接口返回的数据需要按API字段另行处理,不能直接套用下文的JSON-LD解析脚本。
这几类工具的用途不同:官方API直接返回结构化数据;第三方采集API通常负责请求或渲染网页;Python代理接入则用于设置网络出口。Rola IP提供代理服务,商品字段仍需要由程序解析。
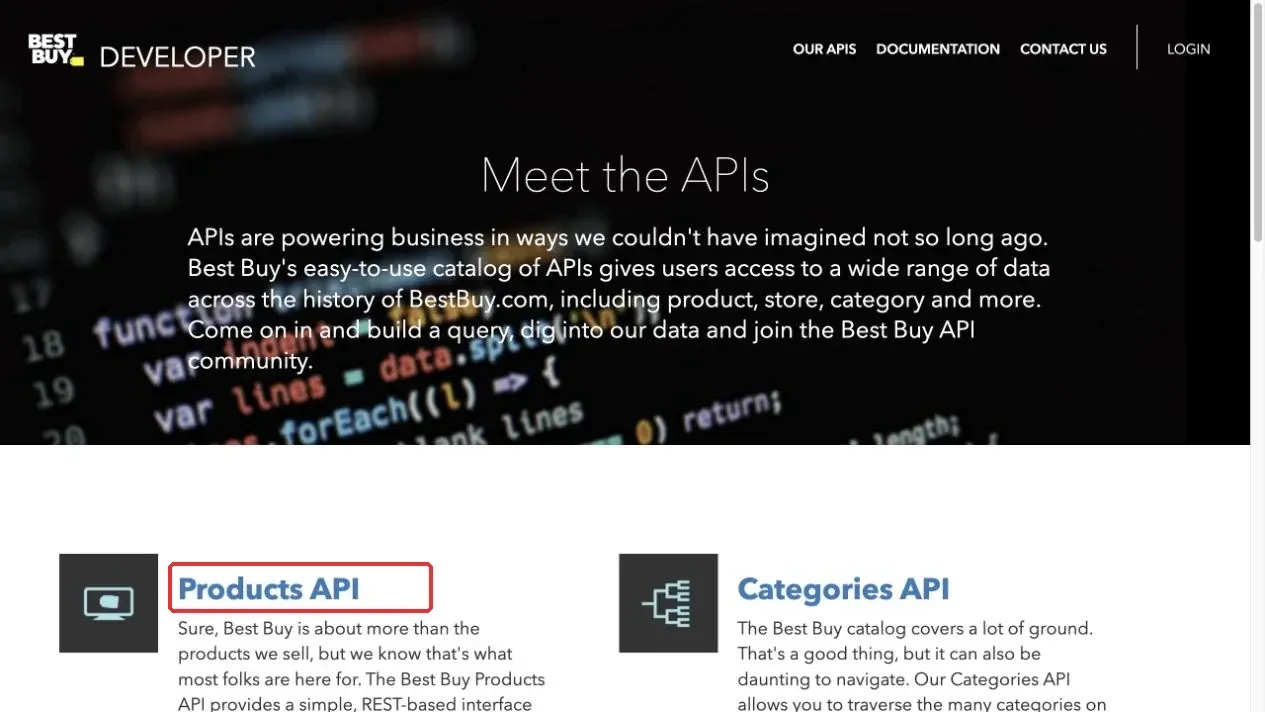
图1:Best Buy官方开发者页面中的Products API入口。
开始采集前,请确认Best Buy的网站条款、robots规则及数据使用要求。页面可以打开,并不意味着可以任意批量采集。本文仅讨论获准使用的商品信息,不涉及账户、订单或支付数据。
先在商品页核对关键字段
第一步:确认SKU和商品版本
搜索同一型号时,结果中可能混有广告、不同颜色、套装和翻新商品。打开详情页后,先核对商品名称、型号、SKU、颜色、卖家和成色,不要直接把第一条搜索结果当作目标商品。
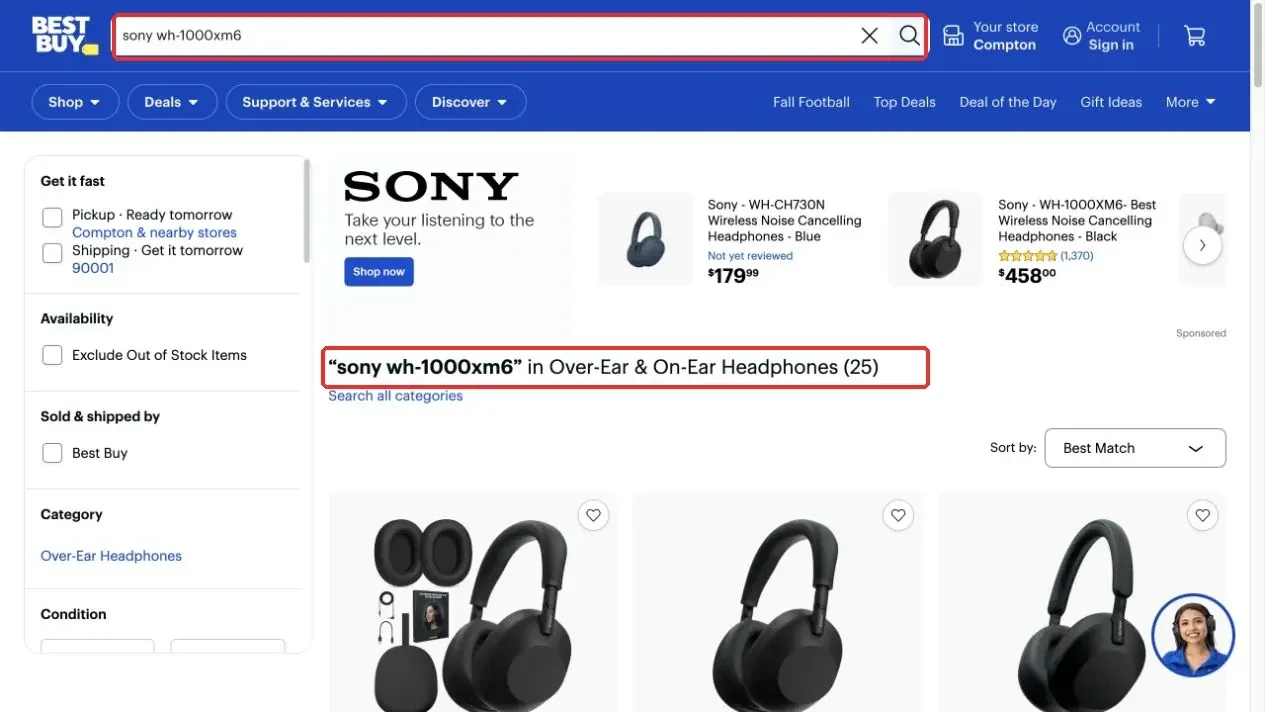
图2:Best Buy搜索结果中的关键词和商品列表。
第二步:分清商品信息和卖家报价
在JSON-LD中,Product记录商品信息,Offer记录卖家对该商品的报价。SKU用于识别商品;比较两条报价时,还要核对卖家、成色、货币和采集时间。如果同一Product下确实列出了多个Offer,应分别保存,避免后一条报价覆盖前一条。不同成色是否共用SKU,要以实际数据为准。
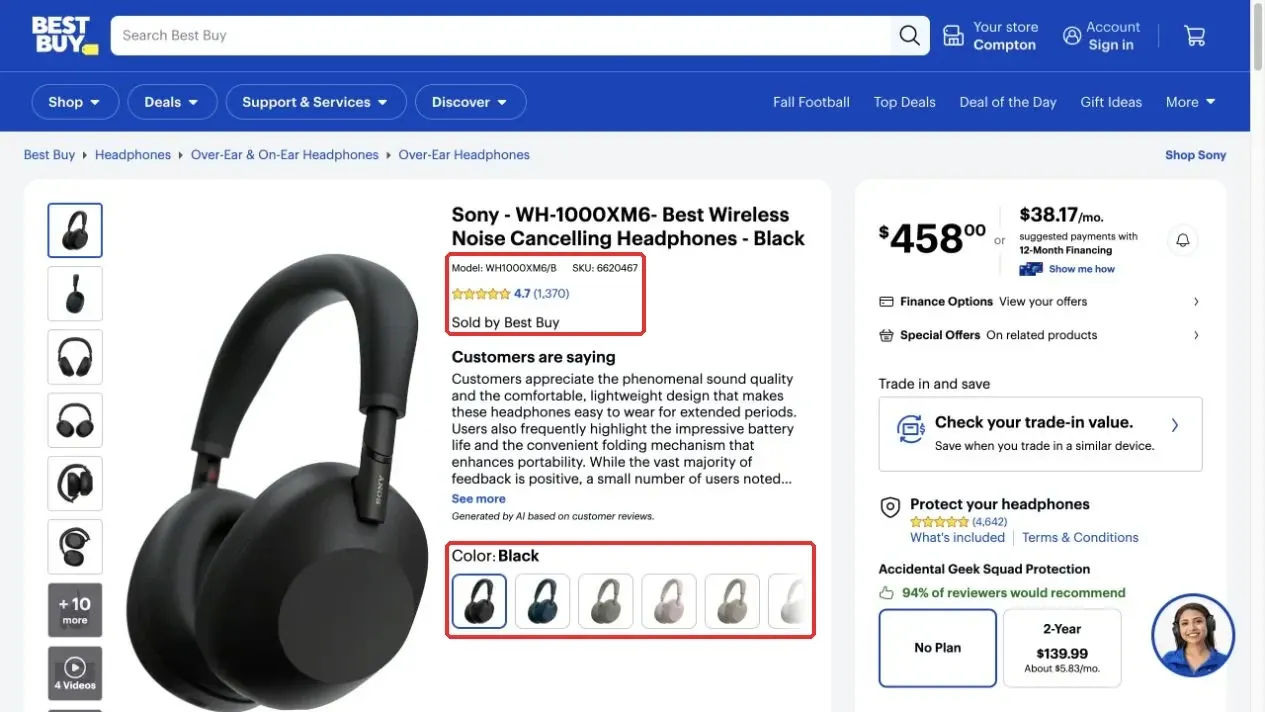
图3:商品详情页中的型号、SKU、卖家和颜色。
第三步:区分售价、月供和附加费用
商品售价附近可能同时显示分期月供、保护计划费用、会员优惠和配送信息。脚本读取Offer的price作为价格,将priceCurrency写入CSV的currency列作为货币。税费和运费是否已包含在价格中,需要单独确认,不能直接把页面上的几个金额相加后当作最终成交价。
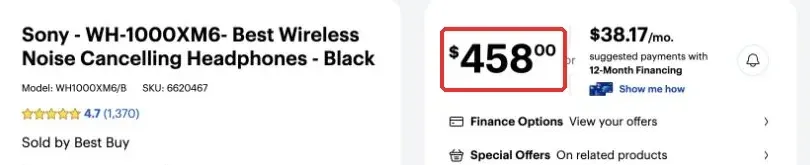
图4:商品售价与页面上的其他金额。
第四步:核对评分、评价数量和规格
aggregateRating.ratingValue表示汇总评分,reviewCount表示评价数量。这两个字段不包含逐条评价正文,页面上的AI评价摘要也不是某位用户的原始评价。
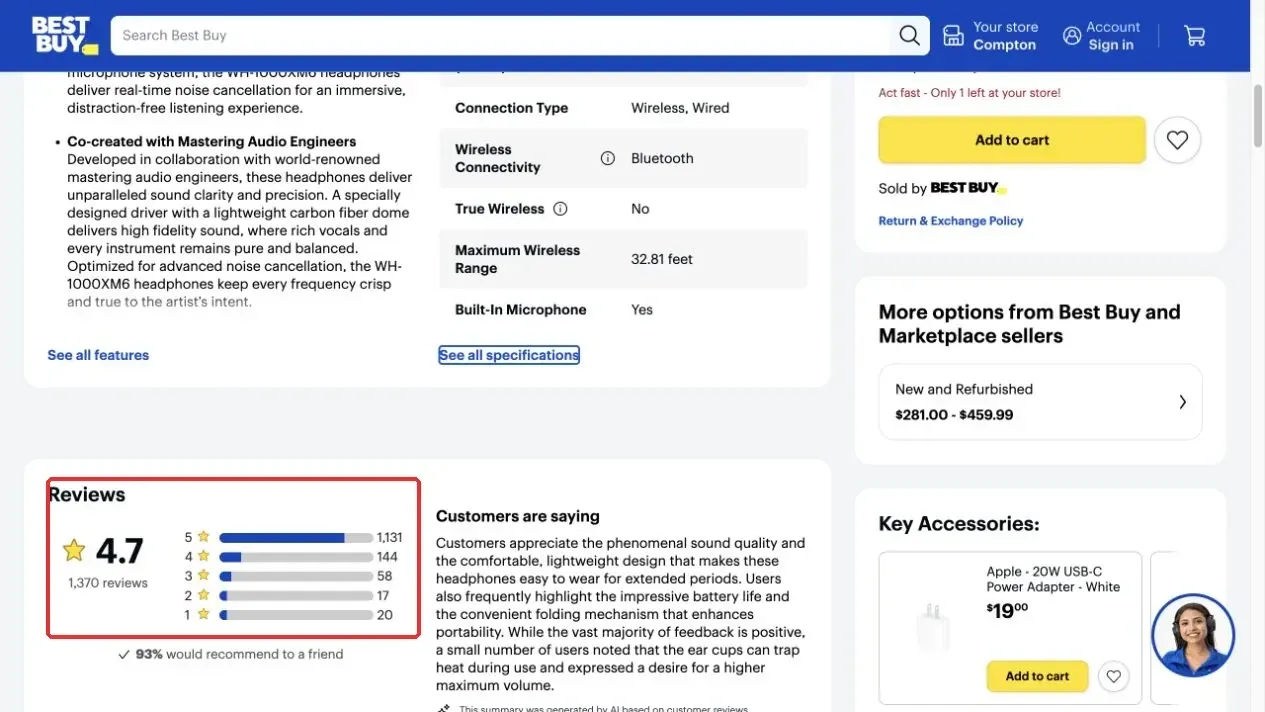
图5:评价区域中的评分和评价数量。
商品规格弹窗可以帮助核对型号、连接方式等属性。不过,页面上能看到的字段,不一定都出现在JSON-LD中;最终能导出哪些数据,要以保存的输入文件为准。
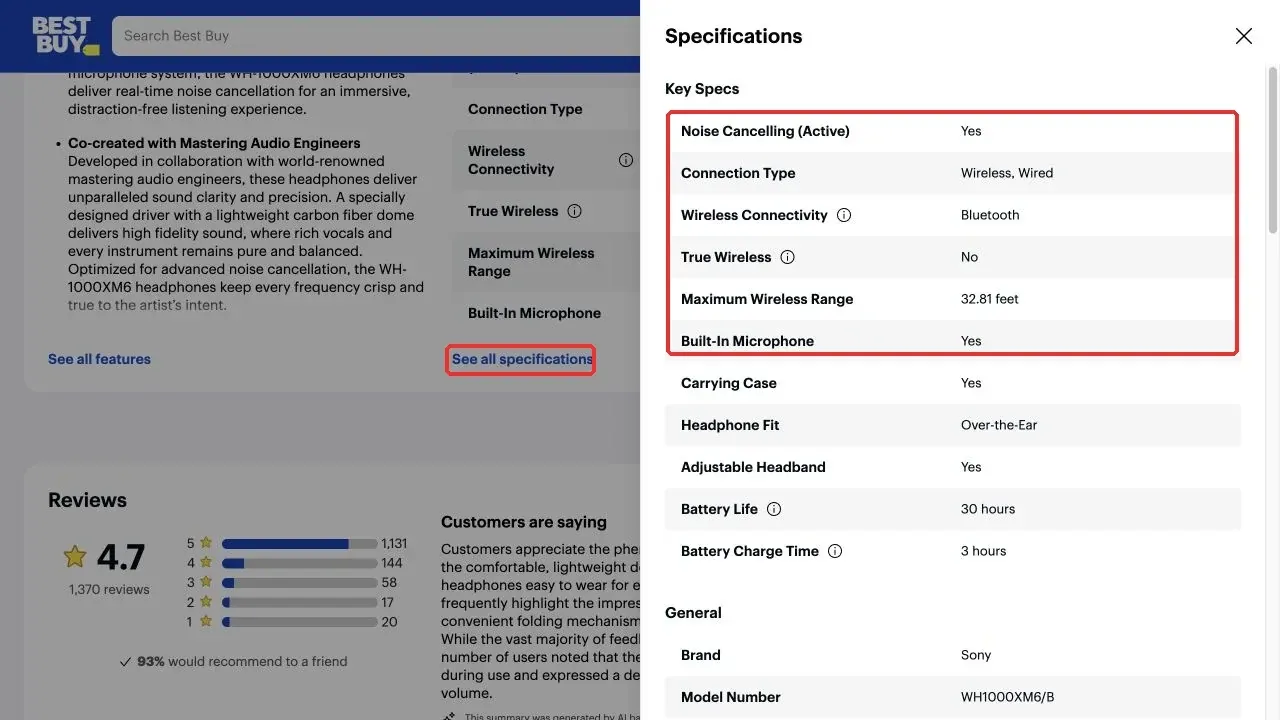
图6:展开后的商品规格弹窗。
在开发者工具中找到Product JSON-LD
第一步:搜索JSON-LD脚本
在商品页空白处右键,选择检查(Inspect)。Windows也可以按Ctrl + Shift + I,macOS按Command + Option + I。进入元素(Elements)面板后,按Ctrl + F或Command + F搜索application/ld+json。
Elements显示的是浏览器当前的DOM。它可能已经被JavaScript修改,因此不一定与Python Requests收到的原始HTML相同。
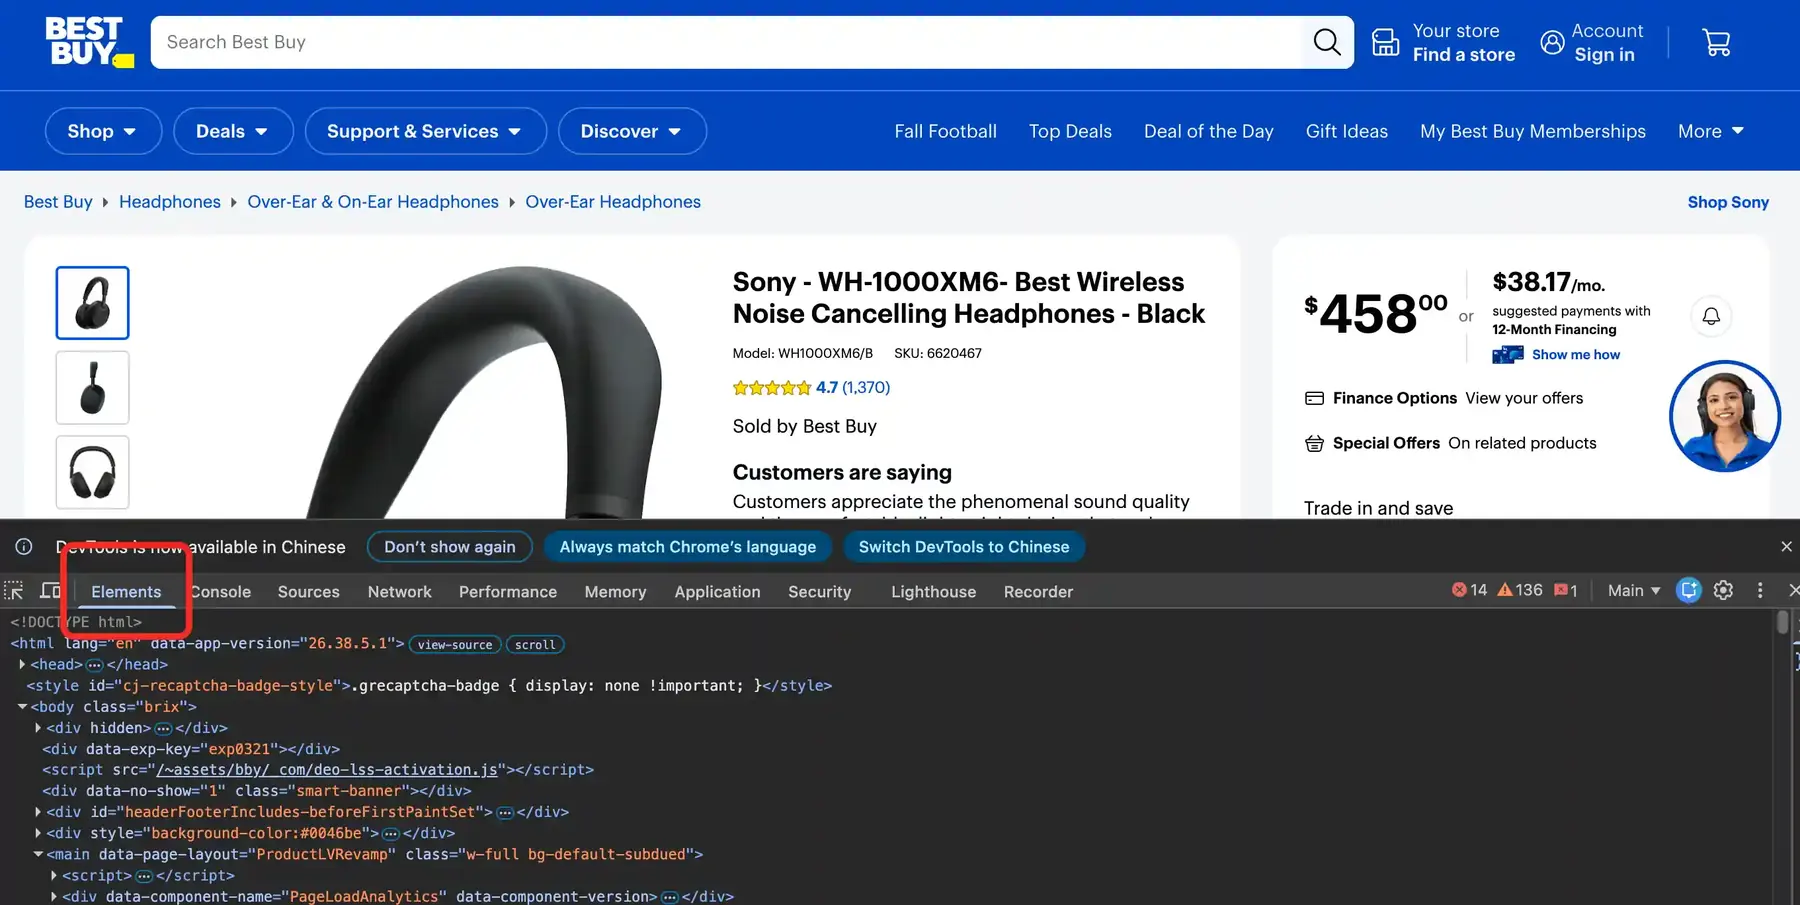
图7:Chrome开发者工具的Elements面板。
第二步:确认找到的是Product
一个页面可能有多个JSON-LD脚本。BreadcrumbList描述面包屑导航,ItemList描述列表;这里需要的是@type包含Product的对象。找到后,再核对其中的sku是否与目标商品一致。
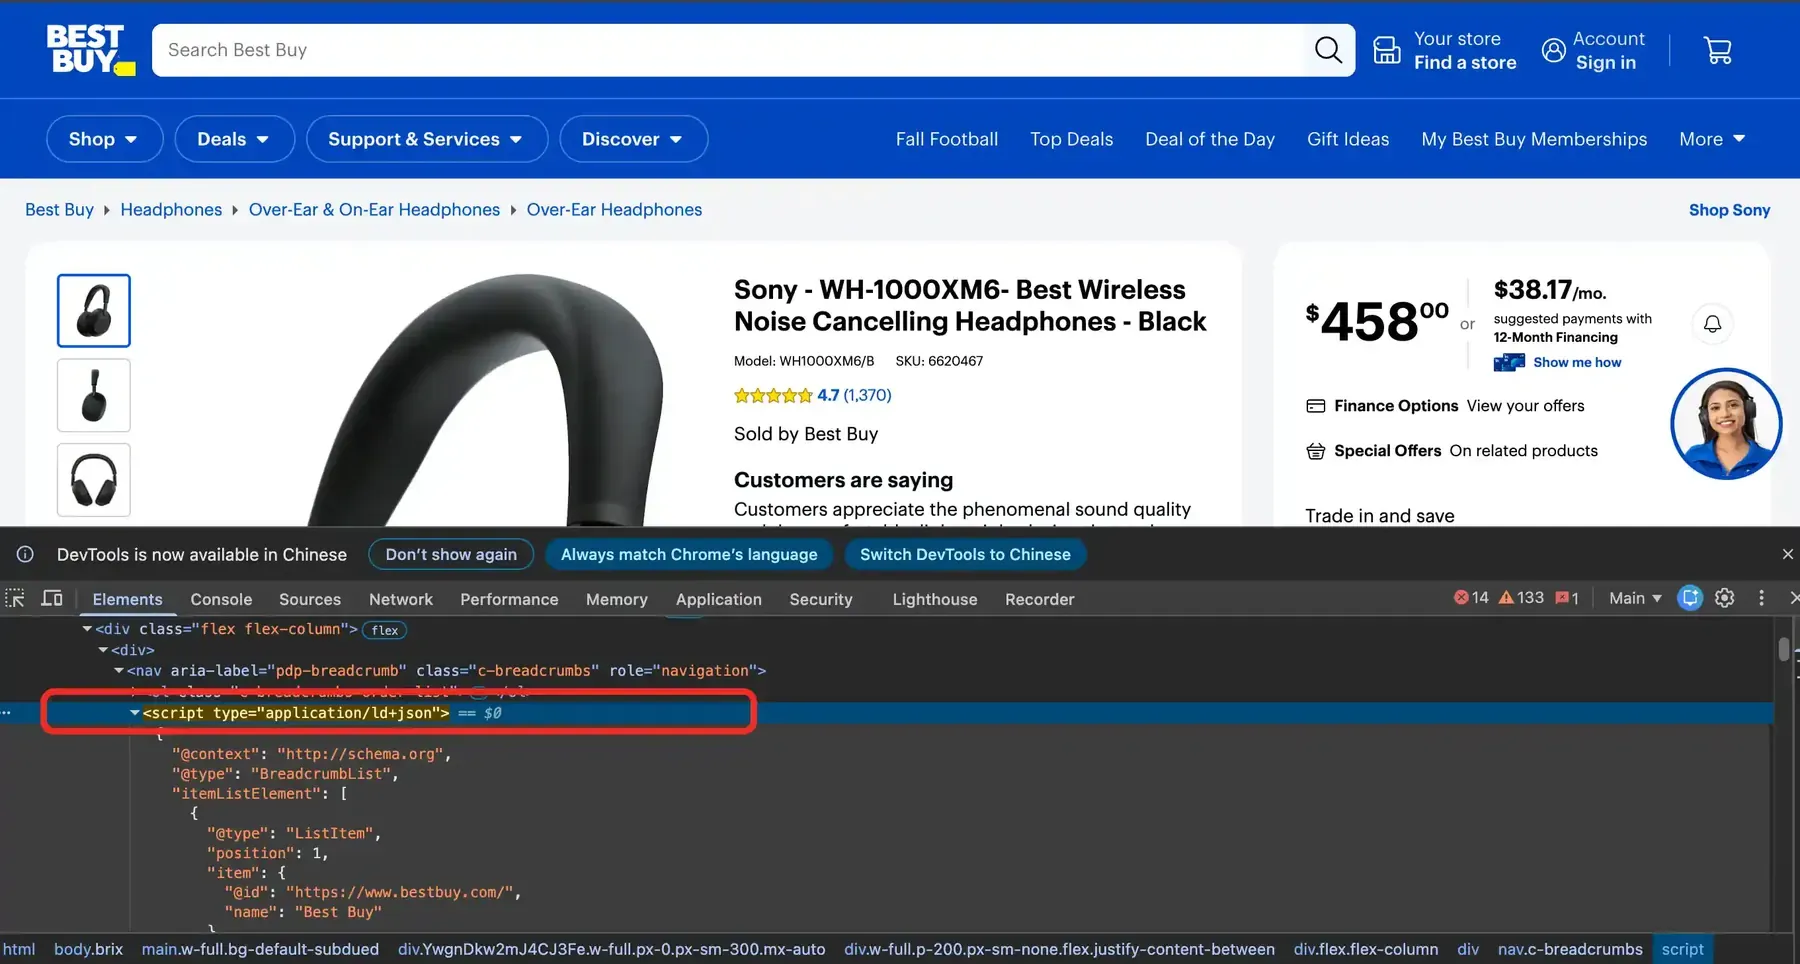
图8:开发者工具中的BreadcrumbList导航数据。
图8中的类型是BreadcrumbList,只能用来说明如何识别导航数据,不能作为商品解析的输入。本文没有提供与该截图对应的真实Product数据,后面的演示使用明确标注的虚构样本。如果实际页面没有Product JSON-LD,就无法直接使用本文脚本提取商品报价,应改用获准使用的其他数据来源。
第三步:保存输入文件
选中确认过的Product脚本,右键选择Copy → Copy outerHTML,粘贴到纯文本编辑器,以UTF-8编码保存为product-jsonld.html。脚本也支持纯JSON文件:如果只复制了JSON内容,可保存为product.json。
如需比较浏览器DOM和原始响应,可打开Network → Doc,刷新页面后选择商品文档请求,在Response中搜索application/ld+json。
用Python解析商品数据并导出CSV
第一步:准备运行环境
下面的解析脚本仅使用Python标准库,不需要安装Requests或pandas。本次离线验证使用Windows 10和Python 3.12.10,验证日期为2026年9月24日。先在终端确认Python版本:
python --version
macOS或Linux若使用python3命令,将后文命令中的python替换为python3即可。只有后续需要测试代理连接时,才需要安装Requests。
第二步:保存完整脚本
将下面的代码保存为bestbuy_parser.py,与输入文件放在同一目录。它支持HTML中的多个JSON-LD脚本、纯JSON、@graph和数组形式的@type,并从中选择指定SKU的Product。
本例只导出Product下直接列出的独立Offer。AggregateOffer中的最低价属于汇总数据,不能当作某位卖家的具体报价;仅有聚合报价时,脚本会停止。脚本也不会自动解析通过@id引用到其他位置的Offer。
import argparse
import csv
import json
from datetime import datetime, timezone
from decimal import Decimal, InvalidOperation
from html.parser import HTMLParser
from pathlib import Path


class JsonLdParser(HTMLParser):
    def __init__(self):
        super().__init__()
        self.inside = False
        self.buffer = []
        self.blocks = []

    def handle_starttag(self, tag, attrs):
        if tag == 'script' and dict(attrs).get('type', '').lower() == 'application/ld+json':
            self.inside = True
            self.buffer = []

    def handle_data(self, data):
        if self.inside:
            self.buffer.append(data)

    def handle_endtag(self, tag):
        if tag == 'script' and self.inside:
            self.blocks.append(''.join(self.buffer))
            self.inside = False


def walk(value):
    if isinstance(value, dict):
        yield value
        for child in value.values():
            yield from walk(child)
    elif isinstance(value, list):
        for child in value:
            yield from walk(child)


def has_type(obj, kind):
    types = obj.get('@type', [])
    return kind == types if isinstance(types, str) else isinstance(types, list) and kind in types


def text(value):
    return '' if value is None else str(value)


def named(value):
    return text(value.get('name')) if isinstance(value, dict) else text(value)


def money(value):
    if value is None or value == '' or isinstance(value, bool):
        raise ValueError('Missing or invalid price')
    try:
        amount = Decimal(str(value))
    except InvalidOperation as error:
        raise ValueError('Invalid price') from error
    if not amount.is_finite() or amount < 0:
        raise ValueError('Invalid price')
    return format(amount, 'f')


def parse_rows(source, expected_sku, observed_at, region):
    observed = datetime.fromisoformat(observed_at.replace('Z', '+00:00'))
    if observed.tzinfo is None:
        raise ValueError('observed-at must include a timezone')
    if not expected_sku.strip() or not region.strip():
        raise ValueError('sku and region must not be empty')
    source = Path(source)
    raw = source.read_text(encoding='utf-8-sig')
    if raw.lstrip().startswith(('{', '[')):
        blocks = [raw]
    else:
        parser = JsonLdParser()
        parser.feed(raw)
        blocks = parser.blocks
    products = [obj for block in blocks for obj in walk(json.loads(block))
                if has_type(obj, 'Product')]
    if not products:
        raise ValueError('No Product JSON-LD found')
    matches = [p for p in products if text(p.get('sku')) == expected_sku]
    if not matches:
        raise ValueError(f'SKU mismatch: expected {expected_sku}')
    rows = []
    for product in matches:
        rating = product.get('aggregateRating') or {}
        if not isinstance(rating, dict):
            raise ValueError('aggregateRating must be an object')
        offers = product.get('offers', [])
        offers = offers if isinstance(offers, list) else [offers]
        for offer in offers:
            if not isinstance(offer, dict) or not has_type(offer, 'Offer'):
                continue
            row = {
                'sku': expected_sku,
                'name': text(product.get('name')),
                'model': named(product.get('model')),
                'brand': named(product.get('brand')),
                'color': text(product.get('color')),
                'seller': named(offer.get('seller')),
                'condition': text(offer.get('itemCondition')),
                'price': money(offer.get('price')),
                'currency': text(offer.get('priceCurrency')),
                'availability': text(offer.get('availability')),
                'rating': text(rating.get('ratingValue')),
                'review_count': text(rating.get('reviewCount')),
                'input_file': source.name,
                'observed_at': observed.isoformat(),
                'region': region,
            }
            for key in ('seller', 'currency'):
                if not row[key].strip():
                    raise ValueError(f'Missing required field: {key}')
            rows.append(row)
    if not rows:
        raise ValueError('No individual Offer found for target SKU')
    return rows


def safe_cell(value):
    value = text(value)
    candidate = value.lstrip(' \t\r\n')
    return "'" + value if candidate[:1] in {'=', '+', '-', '@'} or value[:1] in {'\t', '\r', '\n'} else value


def export_csv(rows, output):
    if not rows:
        raise ValueError('No rows to export')
    exported_at = datetime.now(timezone.utc).isoformat()
    with Path(output).open('x', newline='', encoding='utf-8-sig') as handle:
        writer = csv.DictWriter(handle, fieldnames=[*rows[0], 'exported_at'])
        writer.writeheader()
        for row in rows:
            writer.writerow({key: safe_cell(value) for key, value in
                             {**row, 'exported_at': exported_at}.items()})


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument('input')
    parser.add_argument('--sku', required=True)
    parser.add_argument('--observed-at', required=True)
    parser.add_argument('--region', required=True)
    parser.add_argument('--output', default='bestbuy.csv')
    args = parser.parse_args()
    try:
        rows = parse_rows(args.input, args.sku, args.observed_at, args.region)
        export_csv(rows, args.output)
    except (ValueError, OSError) as error:
        parser.exit(1, f'ERROR: {error}\n')
    print(f'PASS: {len(rows)} Offers exported to {args.output}')


if __name__ == '__main__':
    main()
第三步:保存样本并运行脚本
先用下面的样本验证程序。复制JSON代码块中的全部内容,以UTF-8编码保存为product.json,与bestbuy_parser.py放在同一文件夹。使用记事本时,保存类型选择“所有文件”,避免文件名变成product.json.txt。样本中的品牌、SKU和卖家均为虚构内容,不是从前面的商品截图中提取的数据。
{
  "@context": "https://schema.org",
  "@type": "Product",
  "sku": "DEMO-SKU-001",
  "name": "Demo headphones",
  "brand": {"@type": "Brand", "name": "Demo Brand"},
  "aggregateRating": {
    "@type": "AggregateRating",
    "ratingValue": "4.5",
    "reviewCount": 12
  },
  "offers": [
    {
      "@type": "Offer",
      "seller": {"name": "Demo Seller"},
      "itemCondition": "https://schema.org/NewCondition",
      "price": "199.99",
      "priceCurrency": "USD"
    },
    {
      "@type": "Offer",
      "seller": {"name": "Demo Refurbished Seller"},
      "itemCondition": "https://schema.org/RefurbishedCondition",
      "price": "149.99",
      "priceCurrency": "USD"
    }
  ]
}
在这个文件夹中打开终端。Windows用户可以在文件资源管理器地址栏输入powershell后按回车。然后执行:
python bestbuy_parser.py product.json --sku DEMO-SKU-001 --observed-at 2026-09-24T00:00:00+00:00 --region DEMO --output bestbuy-demo.csv
命令中的时间和地区也是演示参数。处理自己的文件时,将输入文件名、--sku、--observed-at和--region替换为实际值。采集时间必须带时区;地区可记录国家、邮编或门店信息。不要用运行脚本的时间代替原始数据的采集时间。exported_at由脚本自动生成,表示CSV的导出时间。
模拟样本包含两条报价,运行后终端输出:
PASS: 2 Offers exported to bestbuy-demo.csv
生成的CSV中,两条报价各占一行。以下只展示部分列,实际文件还包含其他商品字段以及来源、地区和时间:
| sku | seller | price | currency | review_count |
|---|---|---|---|---|
| DEMO-SKU-001 | Demo Seller | 199.99 | USD | 12 |
| DEMO-SKU-001 | Demo Refurbished Seller | 149.99 | USD | 12 |
样本未填写的型号、颜色等可选字段会留空。脚本不会覆盖已有文件,再次运行时请为--output指定一个新文件名。
第四步:检查导出结果
本例采用严格校验:只要目标商品的一条独立Offer缺少必填字段或价格无效,就停止本次导出,不生成CSV。这样可以避免把不完整的报价当作有效数据继续分析。价格缺失不会被自动填成0;价格确实为0时则会保留。
| 检查项 | 通过条件 | 未通过时的处理 |
|---|---|---|
| 目标SKU | 与--sku完全一致 |
找不到匹配商品时停止 |
| 报价类型 | Product下有直接列出的Offer | 只有AggregateOffer时停止 |
| 价格 | 能解析为有限的非负数 | 缺失、负数或非数值时停止 |
| 卖家和货币 | 字段非空 | 缺失时停止 |
| 评分、评价数量等可选字段 | 有值则保留,包括数值0 | 缺失时留空 |
| 来源和时间 | 包含文件名、带时区的采集时间、地区及导出时间 | 必填参数缺失或时间格式不符时停止 |
这些检查用于发现缺失和格式问题,不能证明源数据本身正确。导出后仍应对照输入文件核对字段,特别是卖家、货币和价格。
还可以在样本副本上检查异常处理:将命令中的SKU改为WRONG-SKU,应提示SKU mismatch;删除第一条Offer的price,应停止导出;把reviewCount改成0,导出的评价数量也应为0。每次测试都使用新的输出文件名,以免触发文件覆盖保护。
在Excel中打开UTF-8 CSV
在Excel中选择数据 → 从文本/CSV,使用UTF-8编码和逗号分隔符。将SKU列按文本导入,避免前导零被删除;价格列按小数导入。然后检查卖家、成色、货币、评分和评价数量。比价时,还要确认两份数据的采集时间是否具有可比性。
CSV是文本文件,不是.xlsx工作簿。脚本会对可能被表格软件识别为公式的单元格加上单引号前缀。文中的网页截图只用于说明字段位置,不能代替输入文件与CSV的逐项核对。
多商品和分页如何处理?
当前脚本每次处理一个文件中的指定SKU,不会自动发现商品链接或点击“显示更多”。处理多个商品时,可以逐个运行,并为每次输出指定不同的文件名。汇总结果时,应同时保留SKU、卖家、成色、地区和采集时间,不能只按SKU去重,否则可能丢掉同一商品的不同报价。
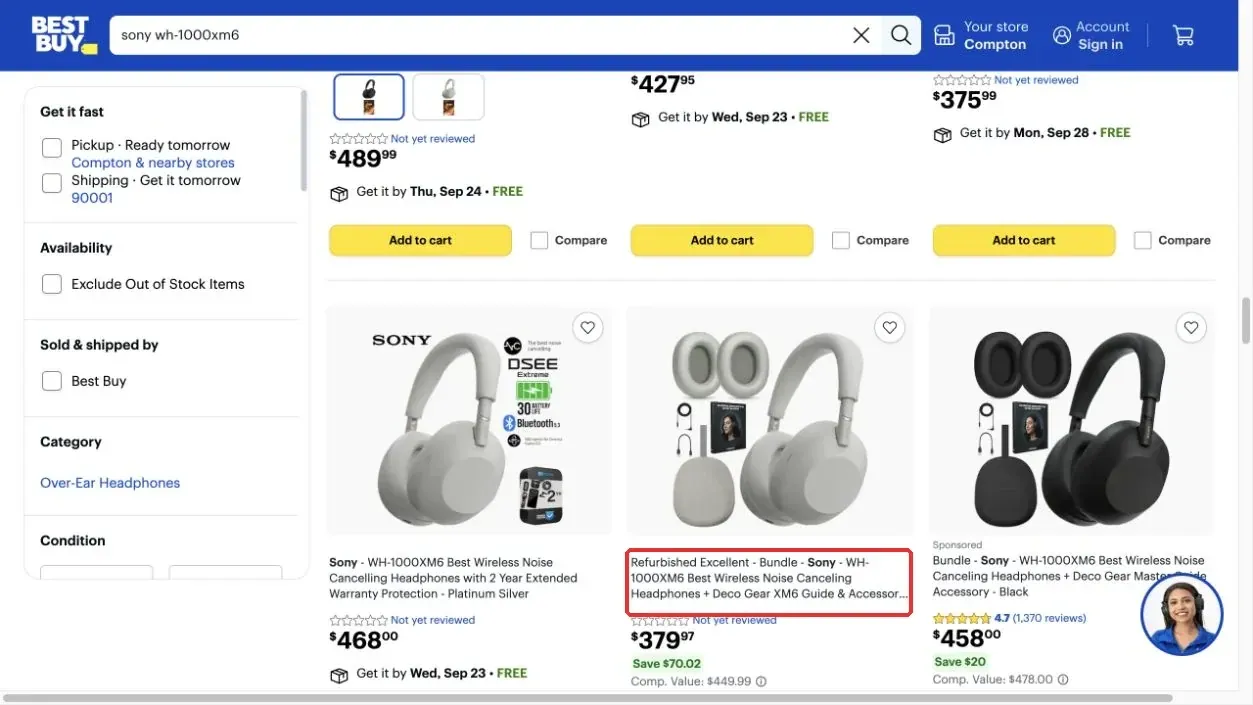
图9:Best Buy搜索结果页中的“显示更多”按钮。
批量采集还需要记录任务进度、限制采集范围、控制请求频率,并保存失败日志。如果使用官方API,应按Best Buy API文档中对应接口的分页规则处理,例如page和pageSize。不要将网页“显示更多”的请求参数直接套用到API上。
如何为采集程序配置Rola IP?
如果获准执行的采集任务需要指定网络出口,可以了解网页抓取代理的适用场景。选择前,先确认任务需要短时保持同一会话,还是长期固定IP。Host、Port、会话和认证字段的具体格式,可查看代理参数文档。
轮换住宅代理和静态住宅代理怎么选?
需要切换出口或在一段时间内保持同一会话时,可考虑轮换住宅代理,并核对套餐支持的会话时长;需要长期固定出口时,可考虑静态住宅代理。
截至2026年9月24日,Rola IP的轮换住宅代理页面介绍了覆盖190多个国家和地区、规模超过8000万的住宅IP池,并提供按流量计费的方案。静态住宅代理页面则列出按IP计费、有效期内不限流量的方案。购买前应核对所需地区、套餐有效期和计费条件;这些产品参数不代表Best Buy采集成功率。
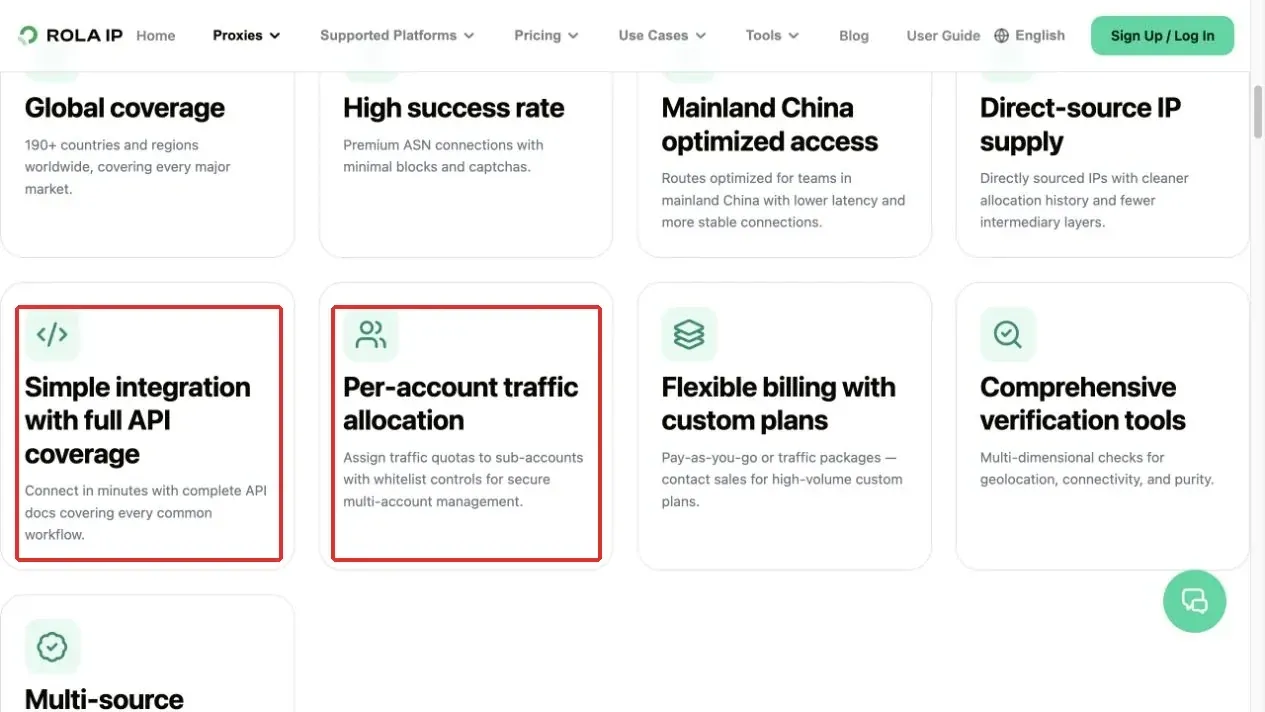
图10:Rola IP产品页中的API接入与账户流量管理说明。
核对代理地址和认证参数
从Rola账户中获取Host、Port、Username和Password,再按所选产品的文档核对协议、端口和用户名格式。不同产品的配置可能不同,不要直接混用其他教程里的参数。
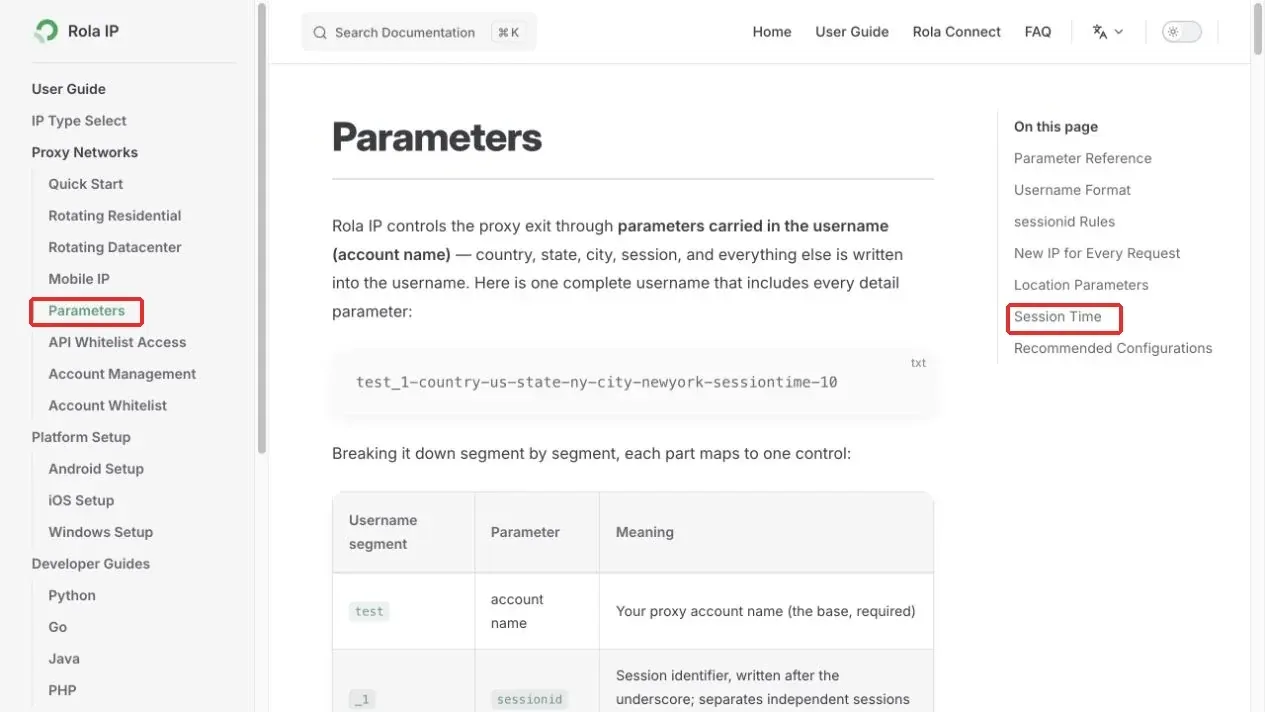
图11:Rola IP参数页中的用户名格式和会话时长。
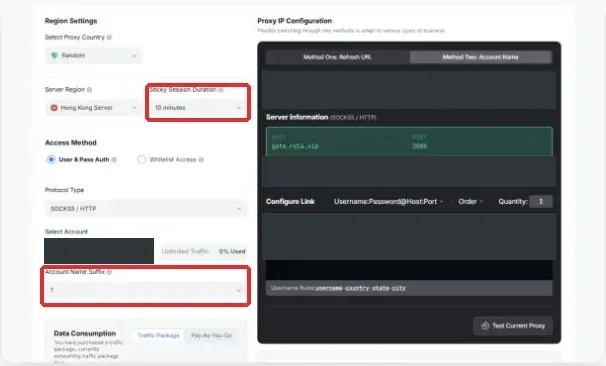
图12:Rola IP配置界面,账户凭据和连接字符串已脱敏。
在Python中测试代理连接
这一段是可选的网络连接示例,与前面的离线解析脚本分开运行。先安装依赖:
python -m pip install "requests==2.32.5"
通过本地终端或任务运行平台设置ROLA_PROXY_USER、ROLA_PROXY_PASSWORD、ROLA_PROXY_HOST和ROLA_PROXY_PORT四个环境变量,分别填写账户提供的用户名、密码、代理地址和端口。不要把真实凭据写进文章、截图或代码仓库。
Windows PowerShell可以使用下面的命令。将提示内容替换为实际参数;密码通过隐藏输入读取,避免直接写入命令历史。
$env:ROLA_PROXY_USER = Read-Host "请输入代理用户名"
$proxySecret = Read-Host "请输入代理密码" -AsSecureString
$env:ROLA_PROXY_PASSWORD = (New-Object System.Net.NetworkCredential('', $proxySecret)).Password
$env:ROLA_PROXY_HOST = Read-Host "请输入代理地址(不含协议和端口)"
$env:ROLA_PROXY_PORT = Read-Host "请输入代理端口"
在同一个终端窗口中运行后面的脚本。这些设置仅对当前终端及其启动的进程生效,关闭窗口后需要重新设置。
将下面的代码保存为check_proxy.py,再执行python check_proxy.py。示例使用HTTP代理连接HTTPS目标,保持TLS证书校验开启,设置20秒超时且不自动重试。
import os
from urllib.parse import quote
import requests

user = quote(os.environ["ROLA_PROXY_USER"], safe="")
password = quote(os.environ["ROLA_PROXY_PASSWORD"], safe="")
host = os.environ["ROLA_PROXY_HOST"]
port = os.environ["ROLA_PROXY_PORT"]
proxy = f"http://{user}:{password}@{host}:{port}"

with requests.Session() as session:
    session.trust_env = False
    session.proxies.update({"http": proxy, "https": proxy})
    try:
        response = session.get("https://ipinfo.io/json", timeout=20)
        response.raise_for_status()
        data = response.json()
        if not data.get("ip"):
            raise ValueError("Diagnostic response has no IP address")
        print({"ip": data["ip"], "country": data.get("country")})
    except requests.exceptions.HTTPError:
        print("Stopped:", response.status_code,
              "Retry-After:", response.headers.get("Retry-After"))
        raise
    except (requests.exceptions.RequestException, ValueError):
        print("Proxy diagnostic failed; check connection and response.")
        raise
运行后,将返回的IP和国家信息与预期出口核对。这个检查只针对诊断网站,不能证明Best Buy页面可访问。如果遇到403、429或验证码,应先停止请求,查明限制原因;恢复请求前还需遵守接口规则及Retry-After要求,不要自动换IP反复尝试。
常见问题怎么排查?
| 现象 | 可能原因 | 排查与处理 |
|---|---|---|
SKU mismatch |
输入文件不含指定商品 | 核对页面SKU、文件内容和--sku |
No Product JSON-LD found |
只保存了导航数据,或页面没有Product | 检查@type;必要时更换获准使用的数据来源 |
Missing or invalid price |
Offer缺少价格或价格类型不符 | 核对输入,不要用0补齐缺失价格 |
No individual Offer found |
仅有聚合报价或引用式Offer | 检查结构;本示例不展开这些报价 |
FileExistsError或文件已存在 |
输出文件名重复 | 指定新的--output文件名 |
| CSV中文乱码 | Excel使用了错误编码 | 通过“从文本/CSV”选择UTF-8导入 |
| HTTP 407或代理认证失败 | 用户名、密码或认证配置不正确 | 检查认证方式、凭据编码及账户状态 |
| HTTP 403 | 目标服务拒绝访问 | 停止请求,检查访问权限和允许使用的接口 |
| HTTP 429 | 请求触发限流 | 停止当前请求,记录Retry-After并按规则调整频率 |
| 连接超时、DNS解析失败或连接被拒 | 网络、代理地址或端口异常 | 分别检查域名解析、端口和网络连通性 |
修正输入文件后,使用新的输出文件名复测;处理网络错误时,应在确认允许恢复访问后再测试。HTTP 200也需要继续检查响应内容,不能单凭状态码认定商品数据有效。
总结
做好Best Buy商品数据提取,关键是先找对商品,再保存完整、可核对的报价。本文脚本从本地文件中选择目标SKU,将独立Offer逐行导出,并校验必填字段、保留数值0、记录来源和时间。完成这一步后,再根据实际需求接入获准使用的数据接口和代理服务。