使用Python进行Shopify网页抓取:商品、变体与CSV导出
2026年9月23日 · 教程 · 26 分钟阅读
抓取Shopify商品时,第一步是先弄清楚页面上的数据来自哪里。同一个“价格”可能是商品起售价、当前颜色对应的价格,也可能是另一个市场显示的金额;一个商品还可能包含多个SKU和不同的可购买状态。本文以Dawn主题的在线演示商店为例,从Puff商品页找到公开的商品JSON,提取颜色变体,导出CSV,再扩展到两页商品目录、HTML中的结构化数据和产品Sitemap。
先给结论:Shopify网页抓取应该怎么做
对于获得授权的Shopify网页抓取项目,优先检查商品Ajax JSON或HTML中的JSON-LD。导出时按“一个变体一行”保存,并把价格单位、货币和可购买状态与页面上的当前选择进行核对。本文把范围限制为一个商品、两页目录和一个产品子Sitemap;示例结果不是完整商店导出,available也不是精确库存数量。
如果任务需要特定地区的出口IP或长期稳定的出站网络,可以使用网络爬虫代理。但出口IP本身不会决定货币,也不会自动获得访问权限;域名、语言路径、Cookie、国家选择器、税规则和商品变体都可能影响最终页面。
Shopify爬虫能提取哪些字段
本文使用Dawn演示商店的Puff商品页。
一个商品不等于一条记录
页面上可以看到Puff、CAD 465.00、多个颜色和购买按钮。选择Emerald时可以购买;选择Olive Leaf时,该选项显示不可用,购买按钮也会禁用。它们属于同一个商品,却对应不同的变体和SKU,因此导出时不能把一个商品简单压缩成一行。
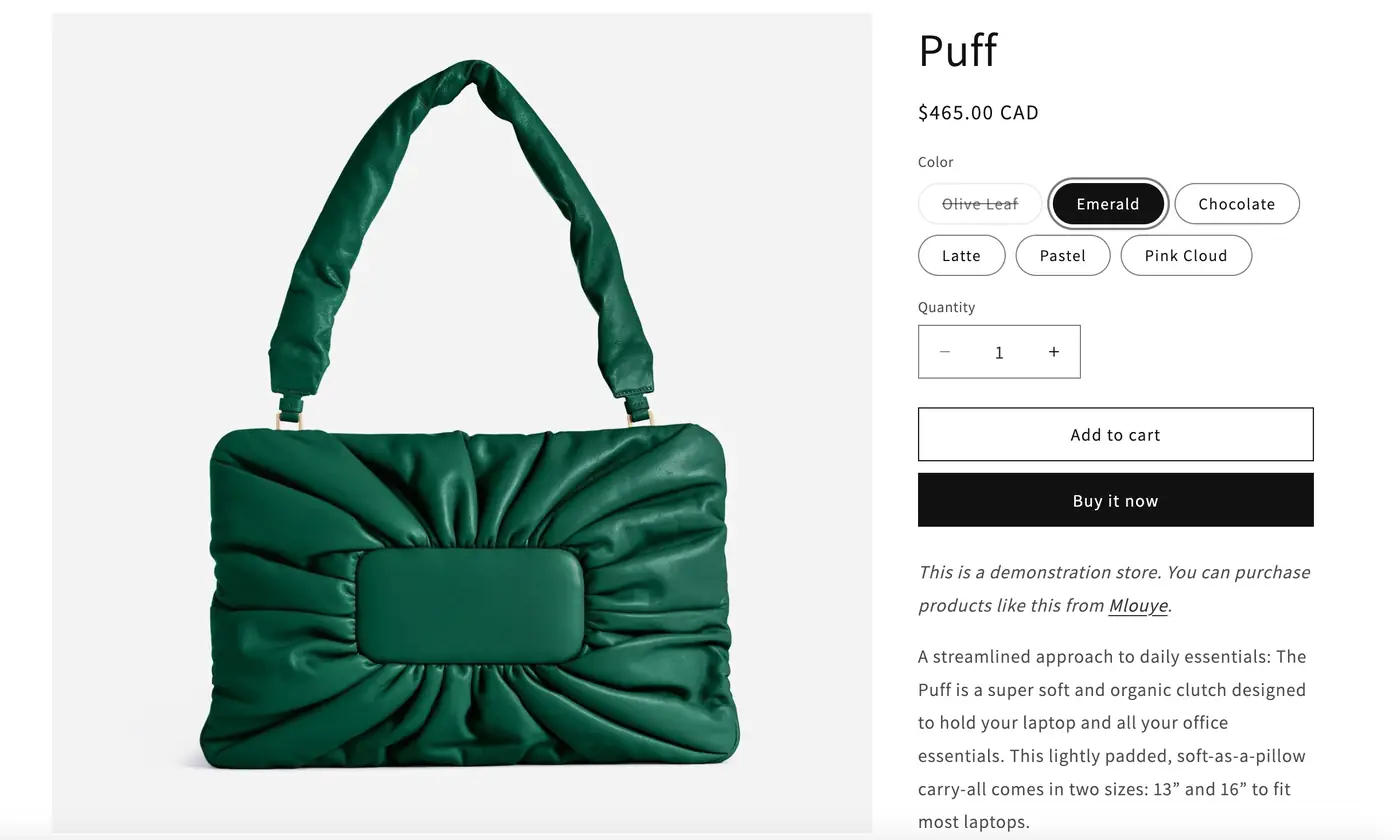
图1:Puff的Emerald选项及页面购买状态。
| 页面信息 | 对应字段或位置 | 导出处理 |
|---|---|---|
| Puff商品名称 | title |
保留商品标题,不要用颜色覆盖标题 |
| Emerald等颜色 | variants[].title |
每个变体单独导出一行 |
| 商品价格 | variants[].price |
Ajax示例中将46500转为CAD 465.00 |
| CAD货币 | 页面显示值和JSON-LD的priceCurrency |
与价格一起保存,不要只保存$ |
| 商品SKU | variants[].sku |
按字符串保存,允许为空 |
| 可购买状态 | variants[].available |
保存布尔值,不要当成库存数量 |
| 商品图片 | images或featured_image |
通常保存URL,无需下载所有大图 |
| 商品描述 | description或body_html |
这是HTML内容,需要时再去除标签 |
available=true只表示当前响应中的变体可以购买,并不等于“库存大于零且已知具体数量”。预售、超卖策略和其他销售规则都可能影响这个状态;数量输入框默认的1是本次购买数量,也不是仓库库存。
Ajax JSON、JSON-LD和Merchant API怎么选
| 数据来源 | 适合场景 | 主要限制 |
|---|---|---|
| 单商品Ajax JSON | 已知商品URL,提取价格、选项和变体 | 路径和主题结构会变化,不能假定所有商店都暴露同一端点 |
products.json |
小规模发现商品、测试分页 | 并非所有商店都支持,不能当作完整Admin API |
| HTML中的JSON-LD | 读取价格、货币、Offer和结构化变体 | 可能只有摘要、缺失,或与可见页面不同步 |
| 渲染后的页面 | 核对当前选项、弹窗和延迟内容 | 比HTTP请求更耗资源,选择器需要维护 |
| 获授权的Merchant API | 自有商店的完整库存、订单和后台数据 | 需要相应权限,不是匿名公开页面抓取 |
Shopify网页抓取的环境准备
安装Python和依赖
示例环境使用Python 3.12、Requests 2.34.2和Beautiful Soup 4.15.0,并使用Python内置的html.parser,所以不需要ChromeDriver、Selenium或额外解析器。版本可从PyPI获取,但不代表你的目标商店一定能直接运行成功;运行时请记录操作系统和确切依赖版本。
新建shopify-tutorial文件夹,在终端执行:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requests==2.34.2 beautifulsoup4==4.15.0
Windows PowerShell:
py -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install requests==2.34.2 beautifulsoup4==4.15.0
如果企业策略不允许激活脚本,可以直接使用虚拟环境解释器:
.\.venv\Scripts\python.exe -m pip install requests==2.34.2 beautifulsoup4==4.15.0
保存shopify_scraper.py后,用同一个解释器运行:
.\.venv\Scripts\python.exe shopify_scraper.py
不要为了运行示例修改系统执行策略。完整脚本放在同一目录时,其他文件才能导入shopify_scraper.py。
明确采集范围
本文只读取单商品JSON、商品HTML、两页商品目录和一个产品Sitemap。切换到其他商店时,还要核对域名、语言路径、货币、字段结构和授权范围;不能只替换商品名称。遇到访问拒绝页或验证页,应先停止并检查真实响应,不要靠反复请求“试出”结果。
第一步:从商品页定位公开数据
先记录页面上需要核对的值
打开Puff商品页,记下商品名称、货币和当前颜色,再切换到Olive Leaf。观察颜色状态和按钮变化,但不要点击购买。这个可见结果将作为脚本中available字段的参照。
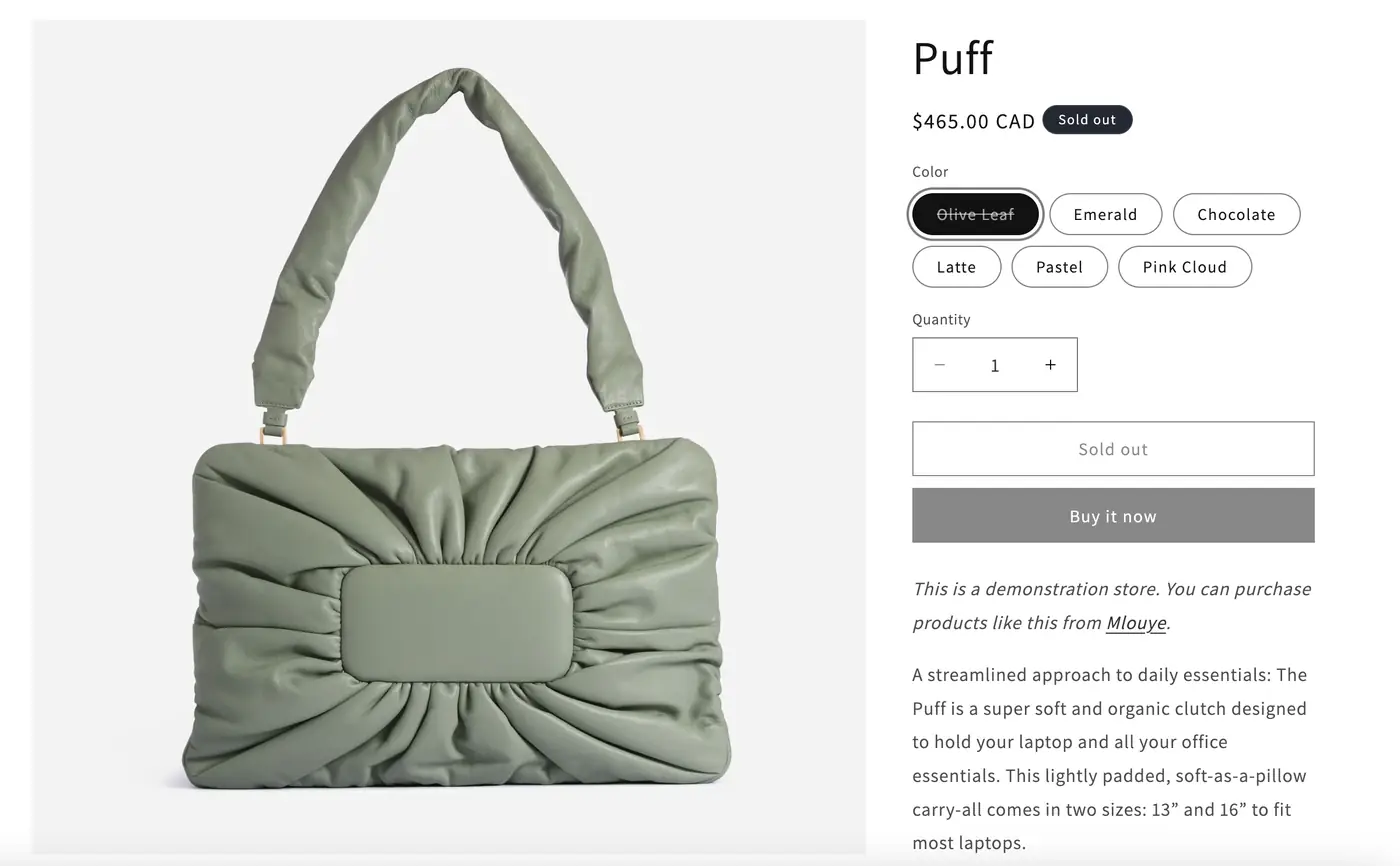
图2:Olive Leaf选项显示缺货。
用开发者工具查看HTML和网络响应
在Chrome商品页空白处右键选择“检查”;Windows也可以按Ctrl + Shift + I,Mac按Command + Option + I。打开DevTools后进入Elements,查看当前页面的HTML。
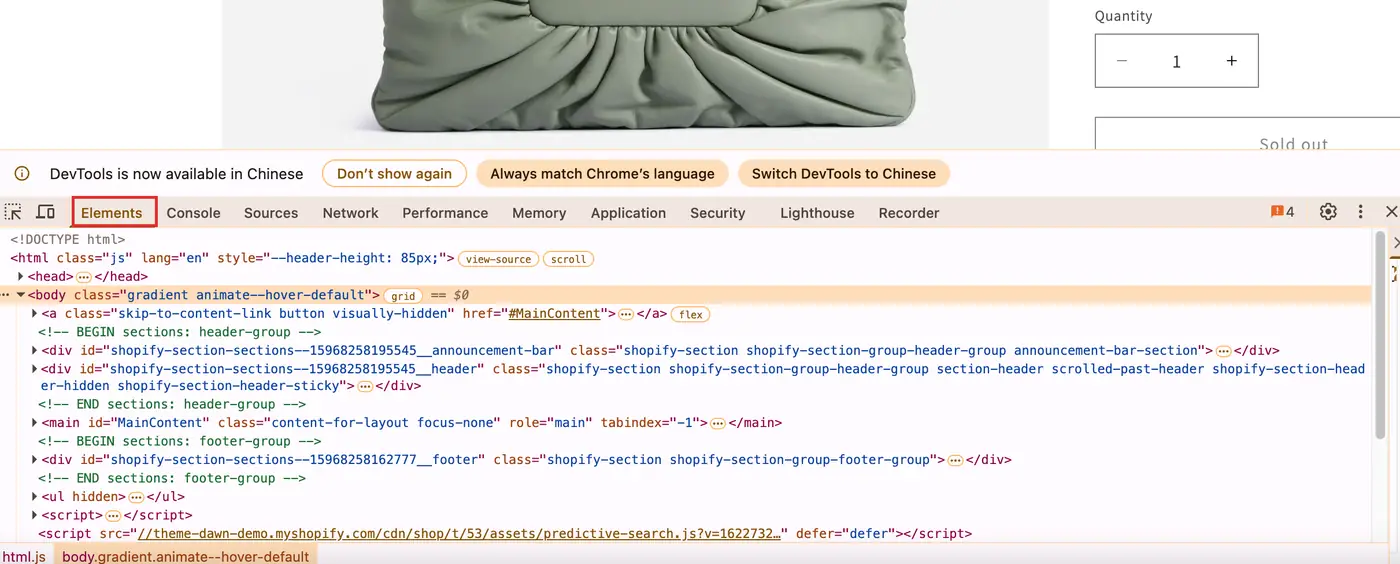
图3:在Elements面板查看页面元素。
点击Elements中任意一行,按Ctrl + F(Mac为Command + F),搜索application/ld+json。找到<script type="application/ld+json">后,展开左侧小三角。一个页面可能有多个JSON-LD,只有看到ProductGroup和商品名Puff,才说明定位到了商品数据,而不是组织或网站信息。
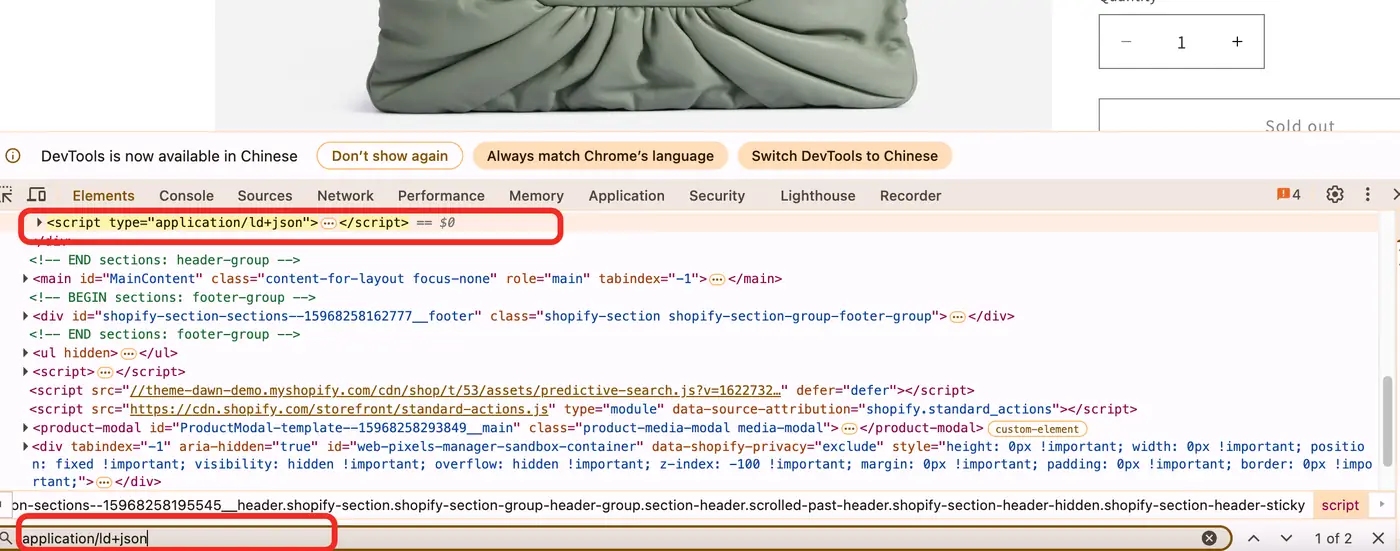
图4:搜索JSON-LD脚本。
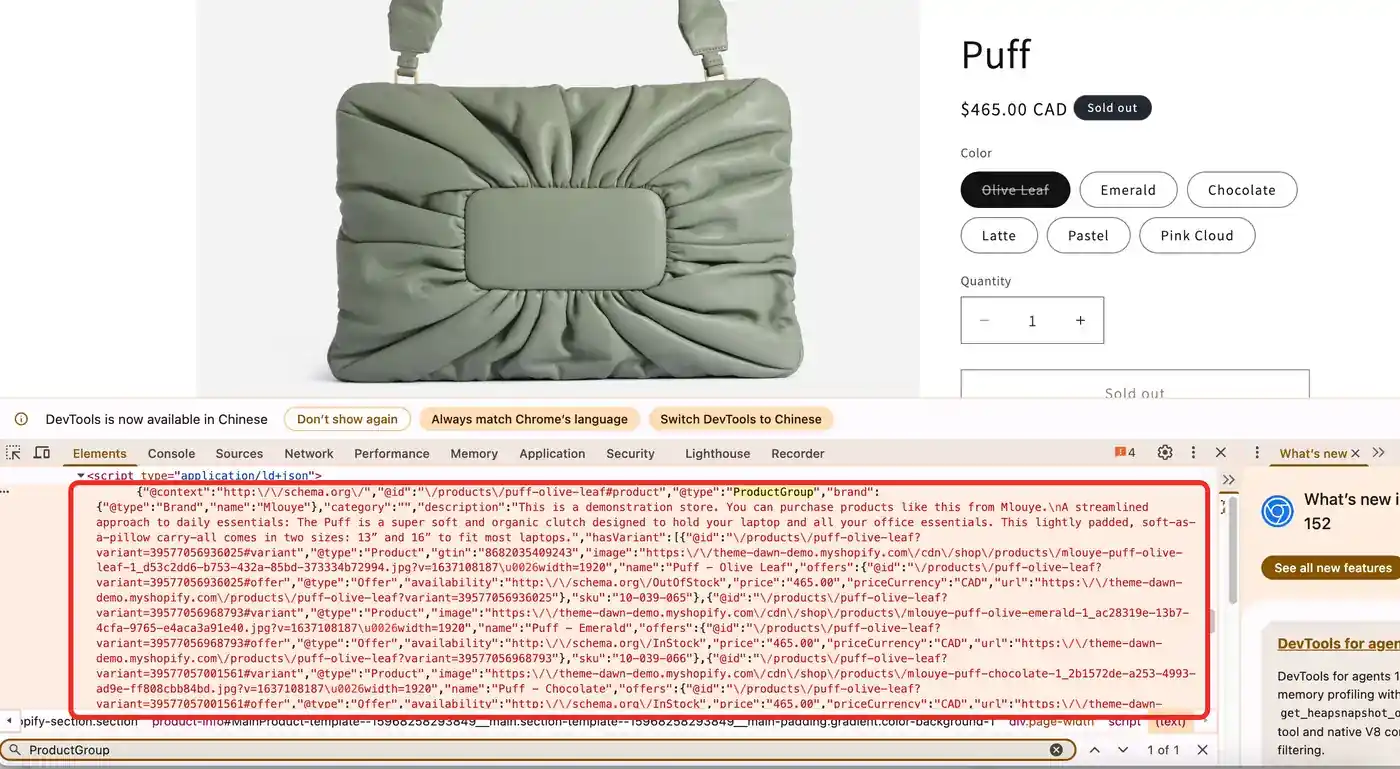
图5:ProductGroup及其变体Offer。
沿着hasVariant数组查看每个变体,再检查其offers。示例中,Olive Leaf的Offer是price: "465.00"、priceCurrency: "CAD"、OutOfStock,SKU为10-039-065;Emerald为InStock,SKU为10-039-066。JSON-LD已经返回小数形式的价格,不要再次除以100。
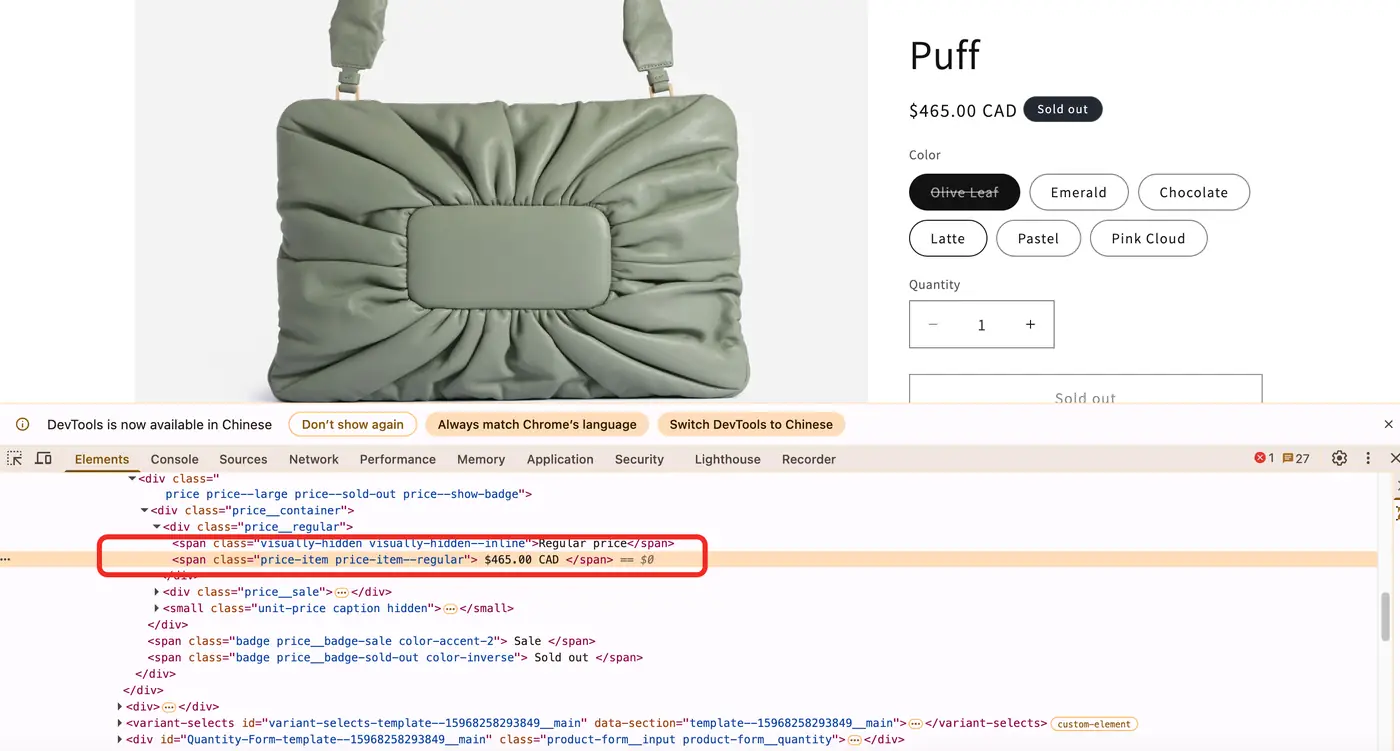
图6:HTML DOM中的可见价格,它不是JSON-LD Offer。
这里看到的是浏览器收到并展示的数据,不是Shopify Admin源码或数据库。Elements显示的是当前DOM;后续脚本还会直接请求HTML,检查Offer是否已经存在于服务器响应中。
切换颜色,找出真正的商品请求
打开Network,刷新页面,选择Fetch/XHR,再切换到Pink Cloud。查看新出现的请求,不要看到200就认定它是商品数据;metrics、collect等请求可能只是统计。
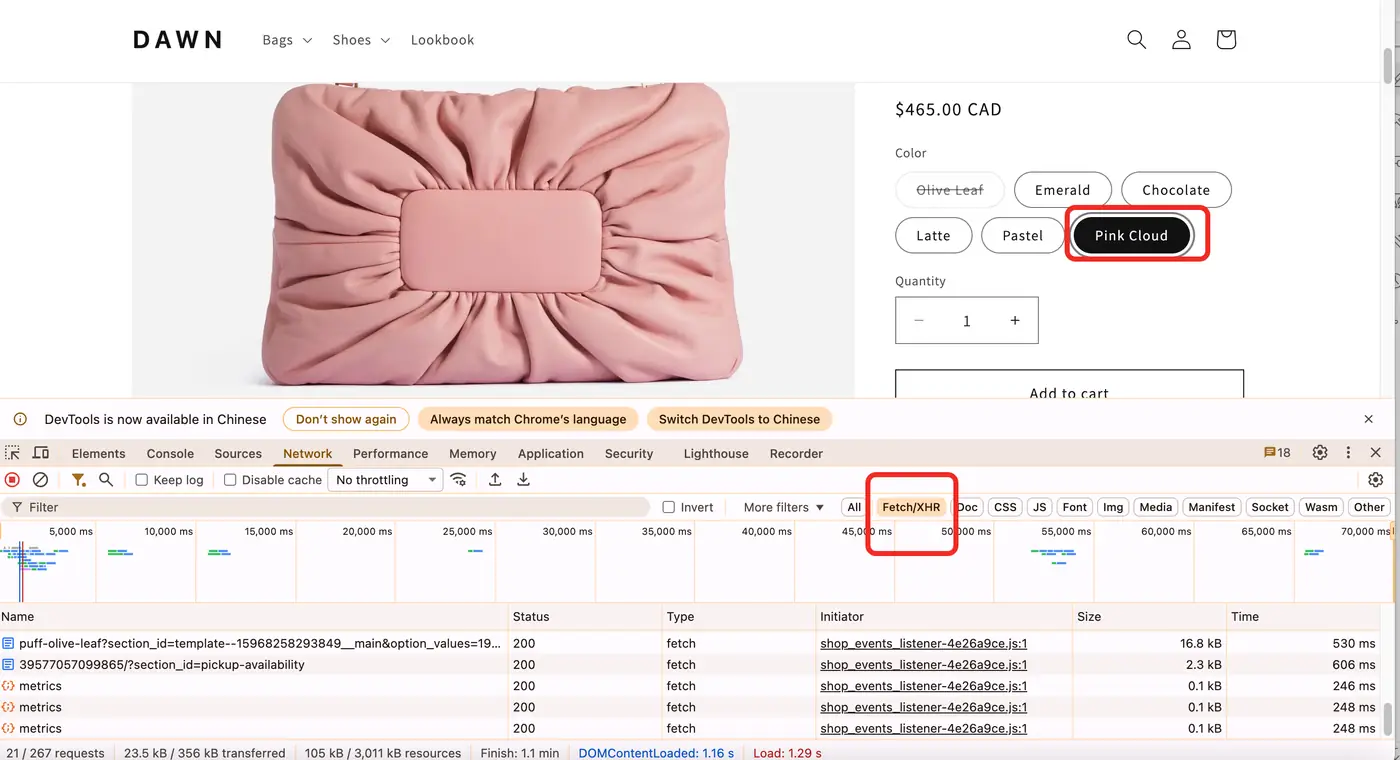
图7:切换变体时检查Fetch/XHR。
示例中,一个请求以puff-olive-leaf?section_id=...开头,另一个包含section_id=pickup-availability。前者关联商品页区块,后者关联取货可用性;两者都不能自动当成完整商品JSON或精确库存。Fetch/XHR只描述请求类型,并不保证响应一定是JSON。
点击目标请求,在Headers中确认Request URL,再到Response查看实际内容。如果响应是HTML,就按HTML解析;如果是JSON,就先检查字段结构。没有独立JSON请求时,继续使用JSON-LD。也可以选择Doc查看商品文档响应,但这不是本例必需步骤。
使用单商品端点建立字段映射
本例Online Store页面公开的商品请求是:
根据Shopify Ajax Product API,单商品端点使用商品handle,并应考虑带语言区域的路径。响应中的金额与面向顾客的货币有关,最多返回250个变体,因此不能把它当成超过250个变体商品的完整导出。相关官方文档核对日期为2026年9月18日,复用前请检查最新版本。
本例第一个变体Olive Leaf的price为46500、available为false、SKU为10-039-065,换算成CAD 465.00后与页面一致。JSON-LD则直接返回字符串"465.00",不能使用同一套除以100的规则。
第二步:用Python提取价格和变体
编写请求和字段转换代码
新建shopify_scraper.py,按下面顺序把三个代码块放入同一个文件。第一部分负责请求和错误处理:
import csv
import json
from datetime import datetime, timezone
from email.utils import parsedate_to_datetime
from decimal import Decimal
from pathlib import Path

import requests

BASE = "https://theme-dawn-demo.myshopify.com"
HANDLE = "puff-olive-leaf"
OUT = Path("results")


def make_session():
    session = requests.Session()
    session.trust_env = False
    session.headers["User-Agent"] = "ShopifyTutorial/1.0"
    return session


def retry_after_message(value):
    if value:
        try:
            if value.strip().isdigit():
                seconds = int(value.strip())
            else:
                deadline = parsedate_to_datetime(value)
                if deadline.tzinfo is None:
                    raise ValueError("Retry-After date must include a timezone")
                seconds = max(0, int((deadline - datetime.now(timezone.utc)).total_seconds()) + 1)
            return f"Wait at least {seconds} seconds before considering a rerun."
        except (TypeError, ValueError, OverflowError):
            pass
    return "Pause collection and confirm the permitted rate before rerunning."


def get_response(session, url, **kwargs):
    try:
        response = session.get(url, timeout=(10, 30), allow_redirects=False, **kwargs)
    except requests.exceptions.ProxyError:
        raise RuntimeError("Proxy connection failed; check gateway and authentication.") from None
    except requests.exceptions.SSLError:
        raise RuntimeError("TLS verification failed; check the certificate and trust configuration.") from None
    except requests.exceptions.Timeout:
        raise RuntimeError("Request timed out; check connectivity before rerunning.") from None
    except requests.exceptions.ConnectionError:
        raise RuntimeError("Connection failed; check DNS, host, port, and network access.") from None
    except requests.exceptions.RequestException:
        raise RuntimeError("Request failed; inspect sanitized diagnostics.") from None

    status = response.status_code
    if 300 <= status < 400:
        raise RuntimeError("Redirect received; verify the destination before changing the URL.")
    if status == 429:
        raise RuntimeError("HTTP 429: " + retry_after_message(response.headers.get("Retry-After")))
    messages = {
        403: "Access denied; stop and confirm the permitted access method.",
        407: "Proxy authentication failed; check the supported authentication mode.",
        404: "Not found; verify the handle, locale, and endpoint.",
    }
    if status >= 400:
        raise RuntimeError(f"HTTP {status}: " + messages.get(status, "Stop and review the response."))
    return response


def get_json(session, url, **kwargs):
    response = get_response(session, url, **kwargs)
    if response.text.lstrip().startswith("<"):
        raise ValueError("Received HTML instead of product JSON")
    try:
        data = response.json()
    except ValueError:
        raise ValueError("Invalid JSON; inspect the response format") from None
    if not isinstance(data, dict):
        raise ValueError("Expected a JSON object")
    return data
不要只检查Content-Type是否含有json。本例.js请求虽然返回JSON,响应类型却可能是JavaScript;代码先排除HTML,再解码JSON并检查对象类型。示例每个请求只尝试一次,遇到错误就停止,不会无限重试。收到429时读取Retry-After的秒数或HTTP日期;缺失或无效时应暂停并确认允许的请求频率。403、407和重定向也必须先解决访问或认证问题。
第二部分把每个变体转成一行。示例只对CAD的整数金额执行除以100,并用Decimal避免浮点误差:
def variant_rows(product, currency="CAD"):
    if currency != "CAD":
        raise ValueError("Verify price scaling before adding another currency")

    variants = product.get("variants")
    if not product.get("id") or not isinstance(variants, list) or not variants:
        raise ValueError("Missing product ID or variants")

    captured = datetime.now(timezone.utc).isoformat()
    rows = []
    for variant in variants:
        raw_price = variant["price"]
        if type(raw_price) is not int:
            raise ValueError("Ajax price must be an integer")
        price = Decimal(raw_price) / Decimal(100)

        compare = variant.get("compare_at_price")
        if compare is not None and type(compare) is not int:
            raise ValueError("Ajax comparison price must be an integer or null")
        if type(variant.get("available")) is not bool:
            raise ValueError("Variant availability must be a Boolean")
        compare_price = None if compare is None else Decimal(compare) / 100

        rows.append({
            "product_id": str(product["id"]),
            "title": product["title"],
            "variant_id": str(variant["id"]),
            "variant": variant["title"],
            "sku": variant.get("sku") or "",
            "price": format(price, ".2f"),
            "currency": currency,
            "available": variant["available"],
            "compare_at_price": "" if compare_price is None else format(compare_price, ".2f"),
            "is_discounted": compare_price is not None and compare_price > price,
            "url": f"{BASE}/products/{product['handle']}?variant={variant['id']}",
            "captured_at": captured,
        })

    if len({row["variant_id"] for row in rows}) != len(rows):
        raise ValueError("Duplicate variant IDs")
    return rows
compare_at_price为空时保持空值,不要写成0;is_discounted=true只代表比较价高于当前价,并不能证明结账时一定应用了折扣。换用其他货币前必须重新核对金额单位,不能沿用CAD标签。
导出CSV和JSON并运行脚本
def save_rows(rows, stem):
    if not rows:
        raise ValueError("No rows to export")
    OUT.mkdir(exist_ok=True)
    (OUT / f"{stem}.json").write_text(
        json.dumps(rows, ensure_ascii=False, indent=2), encoding="utf-8"
    )
    with (OUT / f"{stem}.csv").open("w", newline="", encoding="utf-8-sig") as file:
        writer = csv.DictWriter(file, fieldnames=list(rows[0]))
        writer.writeheader()
        writer.writerows(rows)


def main():
    OUT.mkdir(exist_ok=True)
    with make_session() as session:
        product = get_json(session, f"{BASE}/products/{HANDLE}.js")
        (OUT / "product_raw.json").write_text(
            json.dumps(product, ensure_ascii=False, indent=2), encoding="utf-8"
        )
        rows = variant_rows(product)
        save_rows(rows, "puff_variants")
        print(f"Product: {product['title']}")
        print(f"Variants: {len(rows)} | Currency: CAD")
        for row in rows:
            print(row["variant"], row["sku"], row["price"], row["available"])
        print("Saved: results/puff_variants.csv and results/puff_variants.json")


if __name__ == "__main__":
    main()
运行:
python shopify_scraper.py
程序会创建results文件夹:product_raw.json保存原始端点响应,puff_variants.json和puff_variants.csv保存规范化结果。配图中的历史导出视图显示六个颜色变体、CAD 465.00和Olive Leaf的false状态,但它只是撰写时的视觉参考,不保证你重新运行时完全相同。
检查导出结果是否可用
先核对Olive Leaf和Emerald两行。商品ID应相同,变体ID和SKU应不同;货币应为CAD,可购买状态应与对应颜色一致。Excel可能把长ID转成科学计数法,导入时将product_id、variant_id和SKU列设置为文本。后续程序处理优先使用JSON,因为其中的ID保持字符串格式。每次运行都保留captured_at,这样价格变化时才能区分页面真实变化和抓取错误。
在Excel中查看CSV
脚本生成的是CSV和JSON,不是Excel工作簿。将CSV导入Excel后,把ID、SKU、价格和布尔列逐项检查;保留url与captured_at,方便追溯。
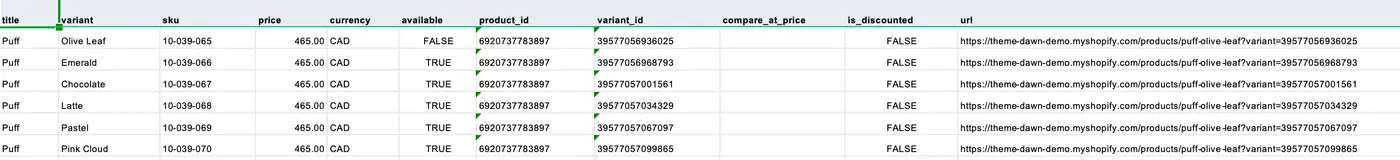
图8:六个Puff变体的示例导出视图;截图裁剪区域未显示采集时间。
第三步:分页抓取Shopify商品目录
先用两页验证分页,不要直接抓完整商店
已知商品handle时可以只抓一个商品。发现更多商品前,先测试目标商店的products.json。下面的示例使用limit=2&page=1和limit=2&page=2,每页只取两个商品,以便确认第二页确实返回新记录。
新建catalog.py,与shopify_scraper.py放在同一目录:
import json
import time
from shopify_scraper import BASE, OUT, get_json, make_session


def collect(session, max_pages=2, limit=2):
    products, seen = [], set()
    for page in range(1, max_pages + 1):
        data = get_json(session, f"{BASE}/products.json",
                        params={"limit": limit, "page": page})
        batch = data.get("products")
        if not isinstance(batch, list):
            raise ValueError("Missing products list")
        if not batch:
            break
        fresh = [p for p in batch if p["id"] not in seen]
        if not fresh:
            raise ValueError("Repeated page; stop and inspect pagination")
        for product in fresh:
            seen.add(product["id"])
            products.append(product)
        print(f"Page {page}: {len(batch)} products | Unique total: {len(seen)}")
        if page < max_pages:
            time.sleep(2)
    if not products:
        raise ValueError("No products returned; inspect the catalog response")
    return products


if __name__ == "__main__":
    with make_session() as session:
        products = collect(session)
        OUT.mkdir(exist_ok=True)
        (OUT / "catalog_sample.json").write_text(
            json.dumps(products, ensure_ascii=False, indent=2), encoding="utf-8"
        )
        print("Saved: results/catalog_sample.json")
        print("Bounded sample only; not a complete store inventory")
运行python catalog.py后检查唯一商品数和保存的ID。两页各返回两个不同商品时,样本应有四个唯一商品;这是成功判据,不是本文已经记录的运行结果。脚本在请求间等待两秒,遇到空页停止,遇到重复页报错,并且最多读取设定的页数。商品可能在采集期间新增或删除,ID去重可以去掉重复项,却不能保证没有遗漏,因此扩大范围前要先定义授权、请求预算、失败日志和检查点。
不要把不同端点的字段当成同一种数据
本例中,目录端点的variants[].price是类似"465.00"的金额字符串,而单商品.js端点返回46500。两者都可能正确,但不能一起传入“除以100”的函数。目录描述常用body_html,Ajax示例使用description。建议目录阶段主要用于取得handle和ID;若要统一格式,应为每种来源编写独立转换层,并保存source_url或来源类型。
第四步:用JSON-LD和Sitemap补充采集
解析ProductGroup中的商品Offer
当目录端点不可用、但公开商品页仍能正常打开时,可以解析HTML中的JSON-LD。新建inspect_html.py,保存实际HTML,并递归查找Offer:
import json
from pathlib import Path
from bs4 import BeautifulSoup
from shopify_scraper import BASE, HANDLE, get_response, make_session


def walk(value):
    if isinstance(value, dict):
        yield value
        for child in value.values():
            yield from walk(child)
    elif isinstance(value, list):
        for child in value:
            yield from walk(child)


def extract_offers(html):
    soup = BeautifulSoup(html, "html.parser")
    offers = []
    for script in soup.find_all("script", type="application/ld+json"):
        try:
            data = json.loads(script.string or script.decode_contents())
        except json.JSONDecodeError:
            continue
        for item in walk(data):
            if item.get("@type") == "Offer" and "price" in item:
                offers.append(item)
    if not offers:
        raise ValueError("No price offers found; inspect this theme")
    return offers


if __name__ == "__main__":
    with make_session() as session:
        response = get_response(session, f"{BASE}/products/{HANDLE}")
        Path("results").mkdir(exist_ok=True)
        Path("results/product.html").write_text(response.text, encoding="utf-8")
        offers = extract_offers(response.text)
        Path("results/offers.json").write_text(
            json.dumps(offers, indent=2), encoding="utf-8"
        )
        print(f"HTML status: {response.status_code} | Offers: {len(offers)}")
        for offer in offers:
            print(offer["price"], offer.get("priceCurrency"), offer.get("availability"))
运行python inspect_html.py,再按URL、价格、货币和可用状态把每个Offer与Ajax变体逐一核对。Offer数量相同不代表匹配成功;没有Offer时脚本应明确失败,而不是写出“成功但为空”的文件。这个递归解析器只提取实际存在的Offer,不推断库存,也不保留父级Product上下文。页面包含推荐商品、多卖家、AggregateOffer时,应按目标商品和变体URL过滤并去重。ProductGroup和变体的组织方式可参考Google商品变体结构化数据文档。
从Sitemap发现商品URL
Sitemap解决的是“商品链接在哪里”,不是“商品价格是多少”。Shopify商店通常由Sitemap索引指向产品子Sitemap,相关机制可参考Shopify Sitemap文档。新建sitemap_urls.py,这里只读取第一个产品子Sitemap,并保留最多三个同源商品URL:
import xml.etree.ElementTree as ET
from urllib.parse import urlsplit
from shopify_scraper import BASE, OUT, get_response, make_session


def read_xml(session, url):
    target = (urlsplit(url).scheme, urlsplit(url).netloc)
    base = (urlsplit(BASE).scheme, urlsplit(BASE).netloc)
    if target != base:
        raise ValueError("Stop at a cross-domain sitemap")
    return ET.fromstring(get_response(session, url).content)


if __name__ == "__main__":
    ns = {"s": "http://www.sitemaps.org/schemas/sitemap/0.9"}
    with make_session() as session:
        index = read_xml(session, BASE + "/sitemap.xml")
        links = [node.text for node in index.findall("s:sitemap/s:loc", ns)]
        product_map = next((u for u in links if u and "sitemap_products" in u), None)
        if product_map is None:
            raise ValueError("No product sitemap found in this index")
        root = read_xml(session, product_map)
        urls = list(dict.fromkeys(
            node.text for node in root.findall("s:url/s:loc", ns)
            if node.text and "/products/" in urlsplit(node.text).path
            and (urlsplit(node.text).scheme, urlsplit(node.text).netloc)
            == (urlsplit(BASE).scheme, urlsplit(BASE).netloc)
        ))[:3]
        if not urls:
            raise ValueError("No in-scope product URLs found; inspect the sitemap")
        OUT.mkdir(exist_ok=True)
        (OUT / "sitemap_sample.txt").write_text("\n".join(urls), encoding="utf-8")
        print(f"First product sitemap: {len(urls)} sample URLs")
        for url in urls:
            print(url)
运行python sitemap_urls.py。脚本最多保存三个唯一、同源的商品URL;具体handle取决于当前Sitemap。发现链接后,仍需逐页验证可访问性,再选择Ajax或HTML解析。商店可能存在多个产品子Sitemap,返回结果只是有边界的样本。
动态页面和区域价格怎么处理
先检查已有响应,再考虑浏览器自动化
页面看起来动态,并不代表一定要用浏览器。先用inspect_html.py检查当前服务器HTML是否已经包含所需Offer;只有字段确实在JavaScript执行或用户交互后才出现时,才考虑Playwright或Selenium。浏览器操作应等待具体价格元素或数据响应更新,而不是固定睡眠几秒。主题可能同时保留隐藏的原价和促销价,不能把DOM中所有文本都当成当前价格。
区域出口IP不等于切换货币
美国或加拿大市场的展示受IP地区、商店域名、语言路径、国家选择器、Cookie、税规则和当前变体共同影响。切换到美国出口不会自动把金额变成USD;每次都要从实际页面或响应核对货币。比较地区时,为不同区域建立独立Session,记录区域、货币、商品ID、变体ID和采集时间,避免把不同颜色、税制或促销条件造成的差异误判成区域价格差异。
为Shopify网页爬虫配置Rola IP
什么时候值得使用代理
如果任务是获得授权的跨区域商品展示核验、持续价格观察,或团队需要统一出站网络,可以将Rola IP的住宅代理接入Requests。需要长期保持固定出口时,可评估静态住宅代理。Session复用连接和Cookie,但不等于代理产品一定保持同一个出口IP;是否固定取决于产品和会话配置。
价格任务更应关注“每条有效、可比较记录的成本”,而不是原始请求数。只请求必要的HTML和JSON,避免反复下载大图,并根据价格监控代理的业务场景选择出口策略。代理不能保证403、429或站点限制消失。
持续任务开始付费前,应确认计费单位、最低购买量、流量有效期以及失败或重试流量的计费方式。先用一个并发请求、一个地区和一个会话配置验证流程,预先设置请求或流量预算;达到上限或遇到未解决的访问错误就停止。本文不提供生产环境并发额度或套餐报价。
把真实连接参数接入脚本
以下示例使用Rola IP动态住宅代理,通过HTTP代理和用户名/密码认证。连接流程已在文章撰写期间使用Rola IP账号核对,官方文档核对日期为2026年9月18日;产品配置可能更新,实际参数以动态住宅代理配置和控制台当前生成结果为准。
- 在控制台进入账号管理 → 账号列表,新建或选择已启用的代理子账号。这里使用的是代理凭据,不要把网站登录密码当作代理密码。
- 进入住宅设置,选择账号和HTTP连接方式,复制控制台生成的主机、HTTP端口、完整用户名与密码。不要自行写死网关,也不要借用SOCKS5端口。
- 按任务设置地区和会话。文档中的
test_1-country-us-sessiontime-10只是格式示例:test是占位账号名,_1是会话标识,country-us请求美国出口,sessiontime-10请求10分钟会话;文档所示会话时长范围为1至120分钟。请粘贴控制台为你生成的完整用户名,不要照抄占位值。 - 同一批次需要保持地区和会话时,应复用同一个完整用户名,并在业务确实依赖出口连续性时主动验证。此场景不要使用
-f-1,因为它表示每次请求更换IP。美国出口仍不代表页面一定返回USD。 - 如果子账号启用了IP白名单限制且账号白名单已有条目,应把当前机器的公网IP加入白名单。这项设置用于限制凭据的使用来源,不等同于免凭据的API白名单访问。同时确认账号已启用且未超过流量配额。
住宅代理和参数文档使用带下划线的会话ID(如test_1)及sessiontime;Python接入页面的某些示例可能使用另一种-sid-写法。本流程应直接使用“住宅设置”生成的完整用户名,不要混用两种会话格式。脚本会在拼接代理URL前对完整用户名进行编码。
from getpass import getpass
from urllib.parse import quote
from shopify_scraper import BASE, HANDLE, get_json, make_session, variant_rows


def configure_proxy(session, host, port, username, password):
    if not host or any(c.isspace() or c in "/:@" for c in host):
        raise ValueError("Enter a gateway hostname only")
    if not str(port).isdigit() or not 1 <= int(port) <= 65535:
        raise ValueError("Invalid proxy port")
    if not username or not password:
        raise ValueError("Username and password are required for this authentication mode")
    proxy_url = f"http://{quote(username, safe='')}:{quote(password, safe='')}@{host}:{port}"
    session.proxies.update({"http": proxy_url, "https": proxy_url})


if __name__ == "__main__":
    host = input("Rola IP gateway hostname: ").strip()
    port = input("HTTP proxy port: ").strip()
    username = getpass("Full generated residential proxy username, including suffixes (hidden): ")
    password = getpass("Proxy password (hidden): ")
    try:
        with make_session() as session:
            configure_proxy(session, host, port, username, password)
            product = get_json(session, f"{BASE}/products/{HANDLE}.js")
            rows = variant_rows(product)
            print("Product JSON received:", product["title"], "| Validated variants:", len(rows))
    except RuntimeError as error:
        print("Request failed:", str(error))
        raise SystemExit(1)
    except Exception as error:
        print("Request failed:", type(error).__name__)
        raise SystemExit(1)
运行python rola_proxy.py并输入自己的参数。代码会隐藏用户名和密码输入,对@、:、/等认证字符进行URL编码,并避免打印可能含凭据的异常URL。HTTPS目标可以通过HTTP代理建立CONNECT隧道,所以字典中的https键不表示代理URL必须以https://开头。不要使用verify=False绕过证书错误,也不要把HTTP端口当作SOCKS5端口。需要接入其他Python项目时,可在Rola IP使用文档中查看对应示例;Requests的代理行为可参考Requests代理文档。
常见错误与数据质量检查
在区域比较前,先用可信的IP查询确认代理出口地区,并在商品响应或页面中核对真实货币。连接成功且拿到商品标题,并不能证明使用了预期市场或会话。
先区分访问错误和解析错误
| 症状 | 优先检查 | 处理方式 |
|---|---|---|
404 |
商品handle、语言前缀、端点是否存在 | 核对真实页面URL,必要时改用HTML |
403或验证页 |
授权、站点限制和真实响应内容 | 停止重复请求,确认允许的访问方式 |
407 |
代理账号、端口和认证模式 | 修复认证,不要直接当成Shopify封禁 |
429 |
请求频率和Retry-After |
按提示等待,重新检查频率和预算 |
| 超时或连接失败 | DNS、网关、端口、网络和响应延迟 | 先解决连通性,不要直接归因于IP被封 |
| 重定向或空Sitemap | 目标地址、XML结构、同源商品URL | 检查目标或结构,避免导出空成功文件 |
| JSON解码失败 | 响应是HTML、空内容还是JSON | 保存脱敏诊断,确认响应后再改解析器 |
| 价格相差100倍 | Ajax整数金额和目录字符串金额 | 按来源转换,并核对货币 |
| 商品存在但颜色缺失 | 是否只读取了第一个变体或摘要 | 遍历变体数组,并考虑端点上限 |
| 页面和数据不一致 | 变体、市场、Cookie、时间和缓存 | 在相同条件下重新比较,不要立即归咎代理 |
总结
可靠的Shopify网页爬虫,应在扩大规模前让页面、商品响应和导出记录彼此对得上。本文从Puff的六个颜色变体出发,覆盖单商品提取、CSV/JSON导出、去重的两页目录样本、JSON-LD解析和Sitemap链接发现。只有在确实需要区域出口时才加入代理,并同时记录市场、货币和会话条件。这样得到的数据才适合后续商品监控与分析,也更容易在价格变化或请求失败时定位原因。