Amazonの価格スクレイピング:Pythonで取得・検証してExcelに出力する方法
2026年9月29日 · 活用シーン · 約20分で読める
Amazonの価格スクレイピングでは、商品ページから金額を取得するだけでなく、どの商品を、どの出品者・配送条件で、いつ観測したかを残す必要があります。国内ECの価格調査や市場分析では、Amazon.co.jpの円建て価格、選択中のバリエーション、送料、ポイントまで区別しないと、異なる条件を同じ価格として比較してしまいます。
処理が正常終了しても、正しい価格が取得できたとは限りません。別商品の価格、参考価格、CAPTCHA画面を読み込んだまま、空欄を「値下がり」と判定することもあります。ここでは、取得元の選定、Rola IPを使った接続経路の設定、ページと価格候補の検証、Excel出力を一つの流れとして扱います。
要点: 利用目的に合う取得元と利用条件を先に確認し、対象サイト・ASIN・配送先・通貨を固定します。応答とページ種別を確認してから価格候補を抽出し、未確認項目を残したまま確定価格にしない設計が基本です。Rola IPは出口IPとセッションを管理するネットワーク層を担います。価格の正確性は、ページ・出品条件・パーサーの検証で確保します。
Amazonの価格をスクレイピングする前に、取得元を選ぶ
継続運用では、ライブラリより先にデータの取得元を決めます。必要な項目を取得でき、用途に適合する公式APIや契約済みのデータサービスがあれば、HTML変更への追随を減らせます。
| 取得方法 | 適した条件 | 確認する事項 |
|---|---|---|
| 公式API・認められた連携 | 必要な商品情報を、許可された用途で利用できる | 参加資格、対象マーケットプレイス、価格項目、保存・更新・再利用条件 |
| 契約済みのデータサービス | 複数市場を継続監視し、保守負担を抑えたい | データの取得根拠、更新頻度、欠損、再配布条件、費用 |
| RequestsなどによるHTTP取得 | 許可された取得先が必要なHTMLを返す | JavaScript依存、応答検証、アクセス頻度、利用条件 |
| Playwrightによるブラウザー取得 | JavaScriptやブラウザー状態が表示に影響する | メモリ・通信量、セッション、DOM変更、停止条件 |
Amazon.co.jpの現行の利用規約は、Amazon.co.jp公式サイトの案内から確認します。APIを使う場合は、そのAPIの契約も別途確認が必要です。米国サイトを調査する場合はAmazon.comの利用条件が参照先になります。
公開ページであることと、自動取得・保存・商用利用が認められていることは別です。ログイン必須情報、個人情報、継続的な認証要求が関わる場合は、実装を進める前に利用条件と取得範囲を見直します。
最初に起きやすい4つの失敗
1. リクエストが集中し、応答が変わる
短時間に大量のASINへアクセスすると、応答遅延、エラー、認証画面などが発生することがあります。「1分に何件なら必ず安全」という共通の閾値はありません。許可された負荷の範囲で小さく始め、応答・通信量・失敗率を観測します。
ブラウザーで商品ページを1回開く操作も、通信1回ではありません。画像、スクリプト、フォント、背景のAPI呼び出しを含めた件数と転送量で判断します。
2. HTTP 200でもCAPTCHAやログイン画面が返る
HTTP 200は、期待した商品情報を取得できたことを意味しません。商品タイトル、ASIN、最終URL、価格領域とともに、CAPTCHAやログイン画面の要素を確認します。
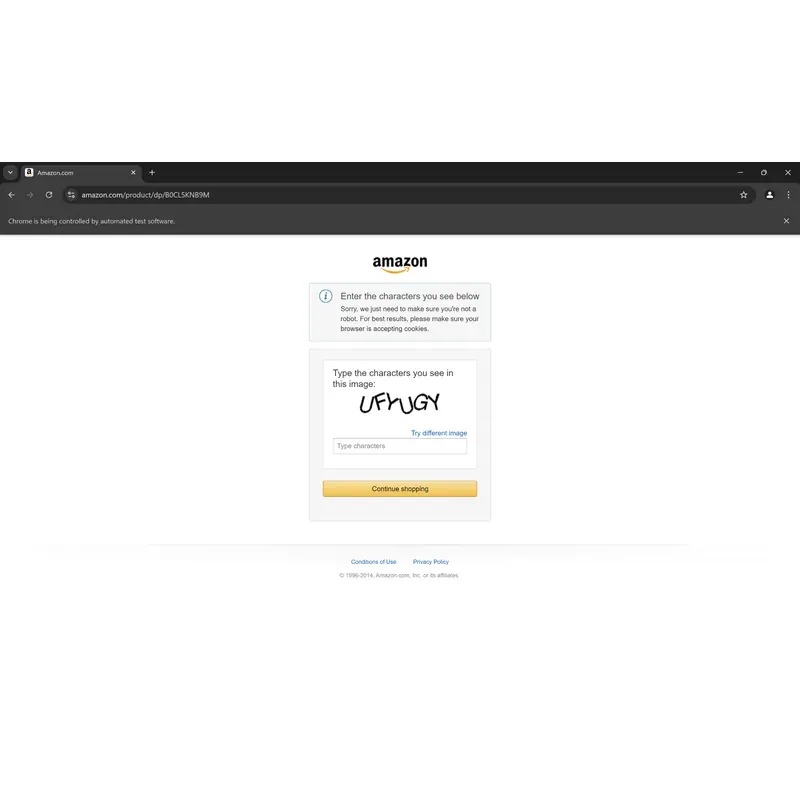
CAPTCHA、403、429、ログイン要求が現れたら、その実行を止めます。自動再試行を繰り返しても、利用許可や取得元の問題は解決しません。認証代行サービスを使うことも、アクセス権限の確認にはなりません。
3. IPの場所と価格の表示条件を混同する
IPアドレスはリクエストの条件の一つです。Cookie、ログイン状態、配送先、ブラウザーの挙動、リクエストの集中も結果に関係し得ます。Amazonが公開していない内部判定を「住宅IPなら必ず通る」と断定することはできません。
日本向けの調査では、Amazon.co.jp、配送先表示、JPY、バリエーション、アカウント状態をそろえます。日本のネットワーク地点を測定条件に含める場合に限り、日本の出口IPも選択・確認します。日本IPだけで国内価格や特定の出品者が確定するわけではありません。
4. 最初に見つかった金額を商品価格として保存する
ページには販売価格、参考価格、送料、分割払い、クーポン、ポイント、別出品者や関連商品の金額が混在します。JavaScriptで更新される領域や、変更されるDOM構造にも注意が必要です。
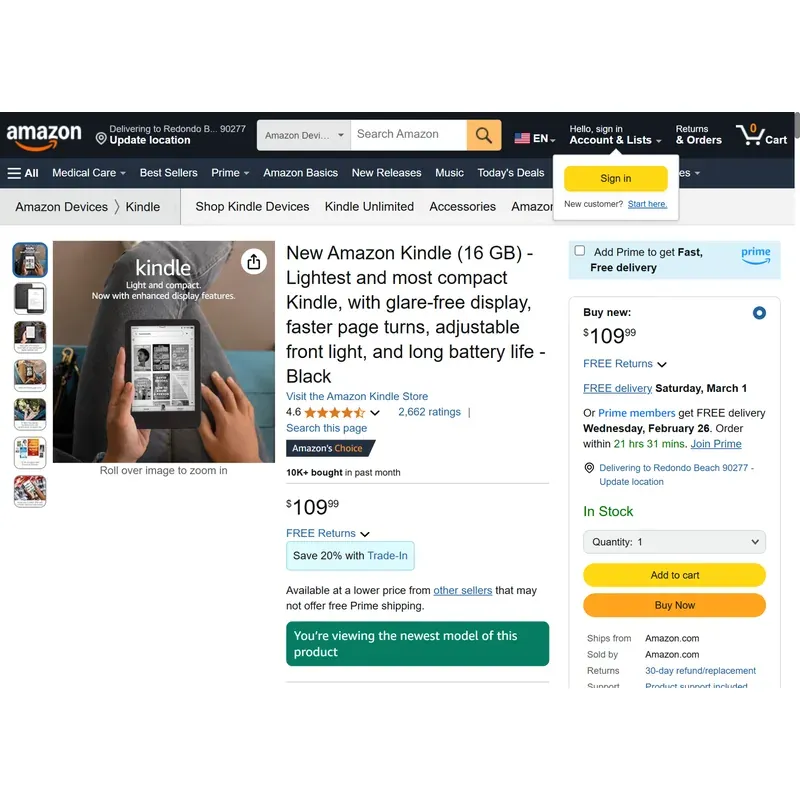
おすすめ出品(Buy Box)を比較するなら、その価格と同じ出品の販売元を記録します。「販売元」と「発送元」は別の項目です。日本向けデータでは、税込・税別の表示状態、送料、適用条件付きクーポン、ポイント数を別欄で扱い、ポイントを無条件に円と同額で差し引かないようにします。
Rola IPで管理するのは、出口IPとセッション
Rola IPの価格監視向けプロキシの案内は、価格観測の接続経路を検討するための資料です。ブラウザーへの接続方法はPlaywrightのプロキシ設定ガイド(英語)も参照できます。
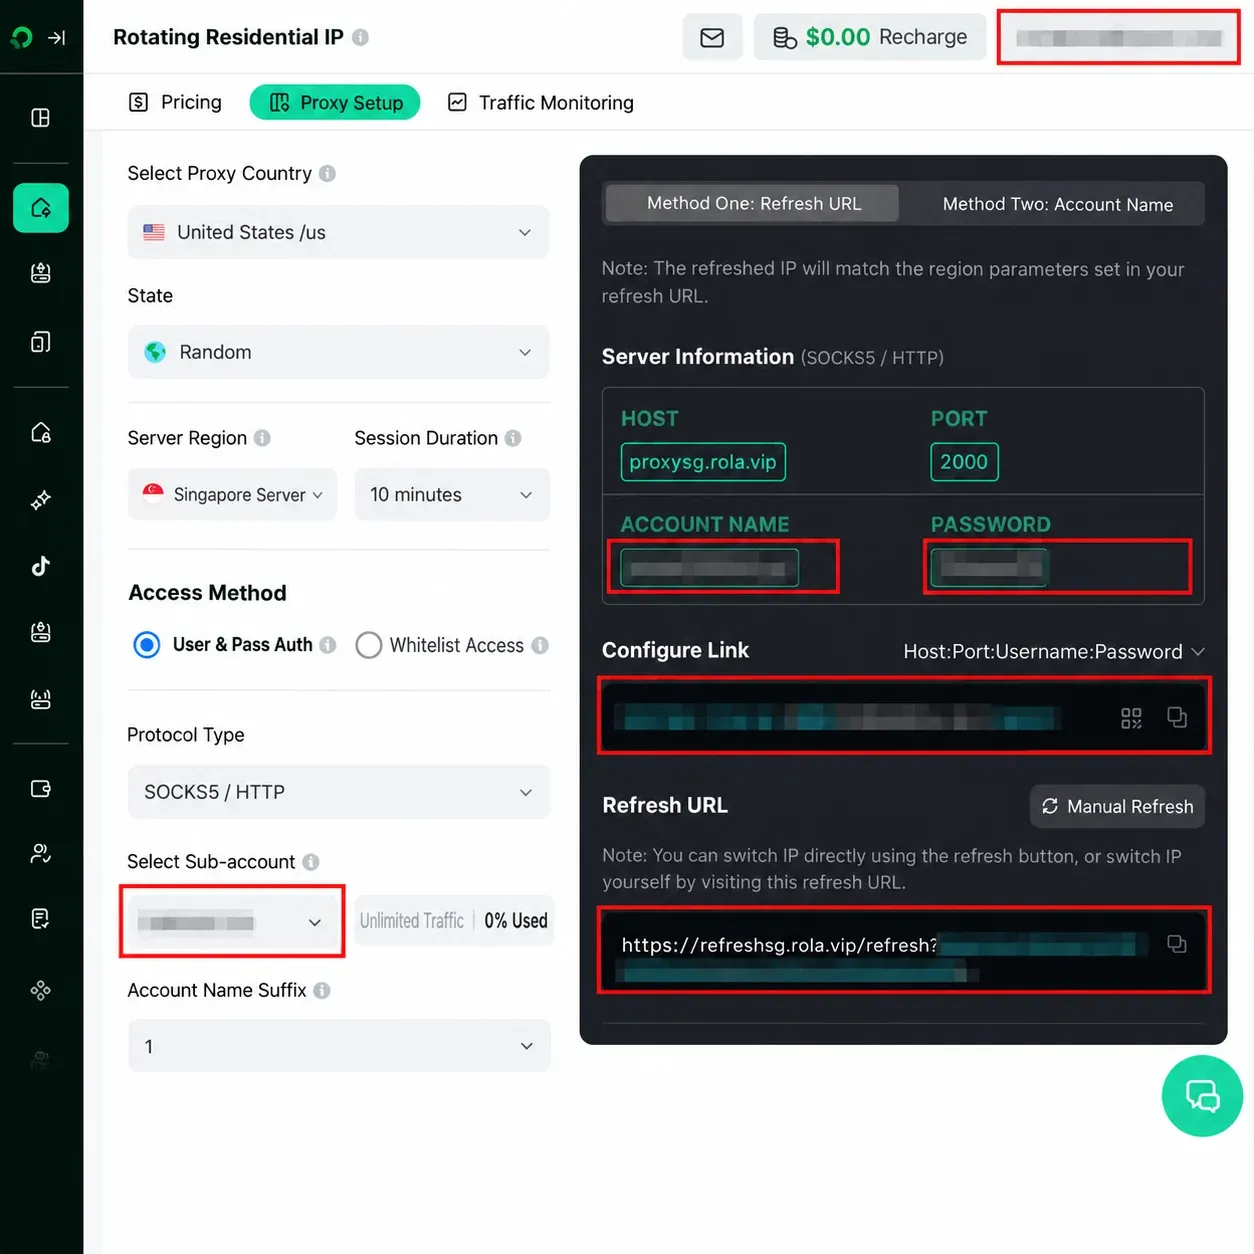
ローテーションとスティッキーセッションはどう使い分ける?
独立した観測ではローテーションを検討でき、関連する商品・バリエーション・出品条件を確認する間は同じセッションを保つほうが比較条件をそろえやすくなります。どちらも、アクセス先と契約で認められる範囲で使います。用途ごとの違いは、スティッキーセッションとローテーションの比較(英語)で確認できます。
| 調査内容 | セッションの考え方 | 検証する点 |
|---|---|---|
| 関連のないASINを独立した標本として観測 | 許可された取得方針に合う場合はローテーション | IP変更を拒否応答の回避手段にしない |
| 同一商品と色・サイズ・出品条件の確認 | スティッキーセッションで出口を維持 | 配送先、Cookie、選択中の商品が変わっていないか |
| 長時間にわたり同じ出口が必要な調査 | 静的住宅・ISPプロキシなどを検討 | 割当条件、継続時間、再接続時の挙動 |
| 失敗した応答の再現 | 最初は同じ入力条件で確認 | その後に一つずつ条件を変える |
| テスト用HTMLや許可済みの接続先 | データセンタープロキシも候補 | 対象が受け入れる経路か、用途に適した費用か |
ローテーション型の住宅プロキシでも、設定によって一定時間のセッション維持が可能な製品があります。ただし、住宅IP、固定IP、独享IP、スティッキーセッションは同義ではありません。Rola IPの住宅プロキシ製品情報を入口に、対象プランの出口国、認証方式、保持時間、プロトコルを確認します。
プロキシチェッカーで接続性や出口IPを確認しても、Amazonの価格精度は証明できません。実際の取得クライアントで、最終URL、ASIN、通貨、配送先、価格の出品元を別に検証します。壊れたセレクターや認証画面は、IPを変えるだけでは直りません。
PythonとPlaywrightでAmazon.co.jpの価格候補を取得する
Playwrightはブラウザーエンジンを操作し、JavaScriptによって表示されるページを確認できます。Requestsが返すHTMLだけでは情報が足りない場合の選択肢ですが、取得元の利用条件は変わりません。
以下は、許可された商品ページへ1回だけトップレベル遷移を行い、価格候補をCSVとExcelへ保存するテンプレートです。日本向けに円表示を扱いますが、すべての商品カテゴリやDOMを網羅するパーサーではありません。
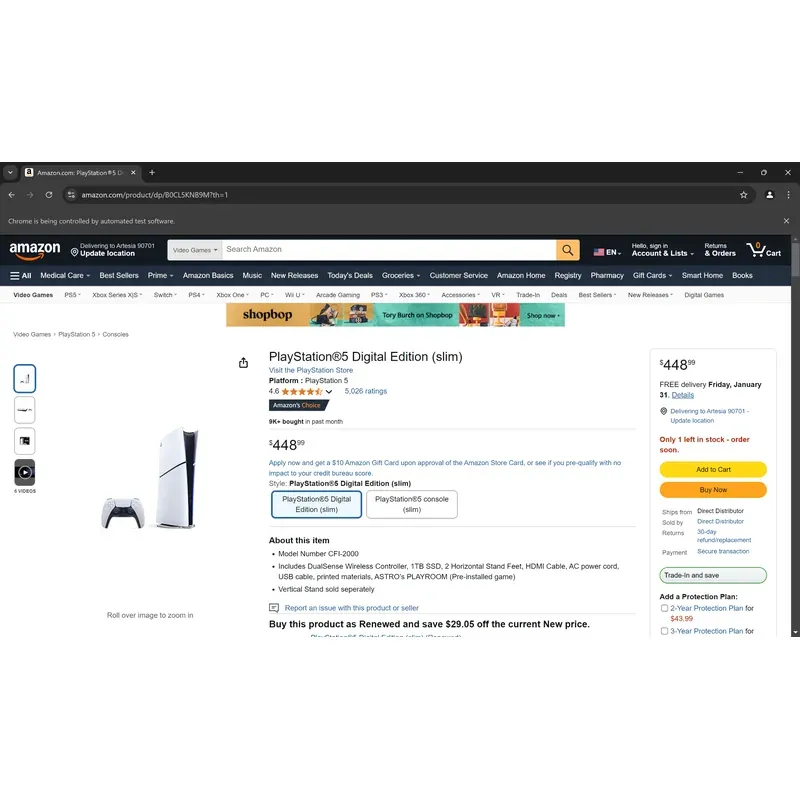
必要な環境と準備
- Python 3.10以上、分離した仮想環境。
- Playwright、pandas、openpyxlとChromium。
- 利用条件を確認した商品URL、期待するASIN、マーケットプレイス、通貨、配送先表示。
- 現行のRola IP管理画面または資料から確認したHTTPプロキシのホスト、ポート、ユーザー名、パスワード。
python -m venv .venv
WindowsのPowerShellでは.\.venv\Scripts\Activate.ps1、macOS・Linuxではsource .venv/bin/activateで環境を有効にします。PowerShellの実行ポリシーで有効化できない場合は、設定を緩めず、.\.venv\Scripts\python.exeを以下のpythonの代わりに使用できます。
python -m pip install playwright pandas openpyxl
python -m playwright install chromium
python --version
python -m playwright --version
python -m pip show pandas openpyxl
実行環境のバージョンを記録します。インストールに成功したことだけでは、特定のAmazonページで動作する保証にはなりません。
接続情報と日本向けの観測条件を設定する
PowerShellの設定例です。大文字のプレースホルダーとASINを実際の値に置き換えます。配送先ラベルは例の郵便番号をそのまま使わず、準備したブラウザーで表示される値と一致させます。
$env:ROLA_HTTP_PROXY_SERVER="http://CURRENT_ROLA_HOST:PORT"
$env:ROLA_PROXY_USERNAME="YOUR_USERNAME"
$env:ROLA_PROXY_PASSWORD="YOUR_PASSWORD"
$env:AMAZON_PRODUCT_URL="https://www.amazon.co.jp/dp/B0XXXXXXXXX"
$env:EXPECTED_ASIN="B0XXXXXXXXX"
$env:EXPECTED_MARKETPLACE="amazon.co.jp"
$env:EXPECTED_CURRENCY="JPY"
$env:EXPECTED_DELIVERY_LABEL="100-0001"
$env:PLAYWRIGHT_STORAGE_STATE="amazon-context-ja.json"
macOS・Linuxのシェルではexport EXPECTED_CURRENCY="JPY"のように同じ名前で設定します。認証情報を共有スクリプトやGitへ保存せず、実運用では承認されたシークレット管理手段から渡します。
本例はHTTPプロキシのユーザー名・パスワード認証を使います。PlaywrightにはSOCKSv5に関する記述もありますが、認証付きSOCKS5が同じChromium設定で動くことを意味しません。単にhttp://をsocks5://へ変更せず、Playwrightのプロキシ仕様と対象エンドポイントの組み合わせを確認します。
配送先を設定したブラウザー状態を用意する
認められた準備操作として、ブラウザーで配送先を設定し、その状態を保存します。
python -m playwright codegen --save-storage=amazon-context-ja.json https://www.amazon.co.jp/
設定後にウィンドウを閉じ、保存されたファイルを指定します。この準備操作にもサイトへの通信が発生し、収集コード内の通信件数には含まれません。ログインは許可された業務で必要な場合に限ります。準備した状態を読み込んでも、取得時に同じ配送先が有効とは限らないため、画面の表示を再確認します。
状態ファイルにはCookieやローカルストレージなどの機密情報が含まれ得ます。Gitや公開ログへ入れず、アクセス権を制限してください。挙動はブラウザー状態の公式説明とcodegenの保存方法を参照します。
完全なコード例
次のコードをamazon_price_snapshot_ja.pyとして保存します。¥1,980や¥1980などを円価格候補として扱い、範囲表示、小数、複数の価格候補は採用しません。円記号だけではJPYを確定せず、同じ価格領域のISO通貨コードも確認します。金額の形式が正しくても、小計や別の出品価格でないことは別途確認が必要です。
import os
import re
from datetime import datetime, timezone, timedelta
from decimal import Decimal
from pathlib import Path
from urllib.parse import urlparse

import pandas as pd
from playwright.sync_api import (
    Error as PlaywrightError,
    TimeoutError as PlaywrightTimeoutError,
    sync_playwright,
)


EXPORT_COLUMNS = [
    "requested_url",
    "final_url",
    "asin",
    "title",
    "marketplace",
    "variation",
    "variation_status",
    "seller",
    "raw_price",
    "numeric_price",
    "currency_symbol",
    "currency_code",
    "expected_currency",
    "delivery_location",
    "delivery_status",
    "offer_container",
    "captured_at_utc",
    "captured_at_jst",
    "http_status",
    "top_level_navigations",
    "browser_request_count",
    "validation_status",
    "missing_reason",
]

STRICT_JPY_DISPLAY = re.compile(
    r"^(?:¥|¥)(?P<whole>(?:0|[1-9]\d*|[1-9]\d{0,2}(?:,\d{3})+))$"
)


class CollectionError(RuntimeError):
    def __init__(self, stage, message, status=None, retry_after=None):
        super().__init__(message)
        self.stage = stage
        self.status = status
        self.retry_after = retry_after


def normalized_host(url: str) -> str:
    host = (urlparse(url).hostname or "").lower()
    return host.removeprefix("www.")


def normalized_text(value: str) -> str:
    return " ".join(value.split())


def first_visible_text(scope, selectors):
    for selector in selectors:
        locator = scope.locator(selector).first
        if locator.count() and locator.is_visible():
            text = normalized_text(locator.inner_text())
            if text:
                return text, selector
    return None, None


def wait_for_page_outcome(page):
    page.wait_for_function(
        """() => Boolean(
            document.querySelector('#productTitle') ||
            document.querySelector('input#captchacharacters') ||
            document.querySelector("form[action*='validateCaptcha']") ||
            document.querySelector("form[name='signIn']") ||
            document.querySelector('input#ap_email')
        )""",
        timeout=12_000,
    )


def detect_page_type(page, final_url: str) -> str:
    lower_url = final_url.lower()
    captcha = page.locator(
        "input#captchacharacters, form[action*='validateCaptcha'], img[src*='captcha']"
    )
    login = page.locator("form[name='signIn'], input#ap_email")

    if "validatecaptcha" in lower_url or captcha.count():
        return "captcha"
    if "/ap/signin" in lower_url or login.count():
        return "login_wall"
    if page.locator("#productTitle").count():
        return "product"
    return "unknown"


def extract_asin(page, final_url: str):
    asin_input = page.locator("input#ASIN").first
    if asin_input.count():
        value = asin_input.get_attribute("value")
        if value:
            return value.upper()

    match = re.search(r"/(?:dp|gp/product)/([A-Z0-9]{10})", final_url, re.I)
    return match.group(1).upper() if match else None


def parse_strict_jpy_display(raw_price: str) -> str:
    value = normalized_text(raw_price)
    match = STRICT_JPY_DISPLAY.fullmatch(value)
    if not match:
        raise CollectionError(
            "price_format",
            "単一の円建て価格として解釈できない表示です",
        )
    amount = match.group("whole").replace(",", "")
    return str(Decimal(amount))


def extract_currency_code(offer_container):
    marker = offer_container.locator("[itemprop='priceCurrency']").first
    if not marker.count():
        return None
    value = marker.get_attribute("content") or marker.text_content() or ""
    value = normalized_text(value).upper()
    return value if re.fullmatch(r"[A-Z]{3}", value) else None


def extract_offer_candidate(page):
    container_selectors = ("#apex_desktop", "#buybox", "#rightCol")

    page.wait_for_function(
        """() => Boolean(
            document.querySelector('#apex_desktop .a-price') ||
            document.querySelector('#buybox .a-price') ||
            document.querySelector('#rightCol .a-price') ||
            document.querySelector('input#captchacharacters') ||
            document.querySelector("form[name='signIn']")
        )""",
        timeout=10_000,
    )

    page_type = detect_page_type(page, page.url)
    if page_type != "product":
        raise CollectionError(
            "offer_wait",
            f"価格待機中にページ種別が変化しました: {page_type}",
        )

    for container_selector in container_selectors:
        container = page.locator(container_selector).first
        if not container.count() or not container.is_visible():
            continue

        nodes = container.locator(
            ".a-price:not(.a-text-price) .a-offscreen"
        )
        observed = []
        for index in range(nodes.count()):
            node = nodes.nth(index)
            price_box = node.locator("xpath=..")
            if price_box.count() and price_box.is_visible():
                text = normalized_text(node.text_content() or "")
                if text and text not in observed:
                    observed.append(text)

        if len(observed) > 1:
            raise CollectionError(
                "offer_ambiguity",
                f"複数の価格候補を検出した領域: {container_selector}",
            )
        if len(observed) == 1:
            return container, observed[0], container_selector

    raise CollectionError(
        "offer_validation",
        "価格領域から単一の表示価格候補を取得できませんでした",
    )


def extract_variation_state(page):
    controls = page.locator("[id^='variation_']")
    selections = page.locator("[id^='variation_'] .selection")

    if controls.count() == 0:
        return None, "not_applicable"

    values = []
    for index in range(selections.count()):
        text = normalized_text(selections.nth(index).inner_text())
        if text and text not in values:
            values.append(text)

    if not values:
        return None, "unresolved"
    return " | ".join(values), "observed"


def classify_browser_error(exc, stage):
    message = str(exc).lower()
    if "407" in message or "proxy authentication" in message:
        return "proxy_authentication"
    if "name_not_resolved" in message or "dns" in message:
        return "dns_resolution"
    if "certificate" in message or "ssl" in message or "tls" in message:
        return "tls_handshake"
    if "connection refused" in message or "connection reset" in message:
        return "connection"
    if isinstance(exc, PlaywrightTimeoutError):
        return f"{stage}_timeout"
    return stage


def collect_price(url: str, expected_asin: str, expected_marketplace: str) -> dict:
    proxy = {
        "server": os.environ["ROLA_HTTP_PROXY_SERVER"],
        "username": os.environ["ROLA_PROXY_USERNAME"],
        "password": os.environ["ROLA_PROXY_PASSWORD"],
    }

    expected_currency = os.environ.get("EXPECTED_CURRENCY", "").upper()
    expected_delivery = normalized_text(
        os.environ.get("EXPECTED_DELIVERY_LABEL", "")
    )
    storage_state = os.environ.get("PLAYWRIGHT_STORAGE_STATE")
    state_loaded = False

    context_options = {"locale": "ja-JP", "timezone_id": "Asia/Tokyo"}
    if storage_state:
        storage_path = Path(storage_state)
        if not storage_path.is_file():
            raise CollectionError(
                "context_setup",
                "PLAYWRIGHT_STORAGE_STATEで指定したファイルがありません",
            )
        context_options["storage_state"] = str(storage_path)
        state_loaded = True

    with sync_playwright() as playwright:
        browser = None
        context = None
        stage = "browser_launch"
        try:
            browser = playwright.chromium.launch(headless=True, proxy=proxy)
            stage = "context_setup"
            context = browser.new_context(**context_options)
            page = context.new_page()
            network = {"requests": 0}
            page.on(
                "request",
                lambda _request: network.__setitem__(
                    "requests", network["requests"] + 1
                ),
            )

            stage = "navigation"
            response = page.goto(
                url,
                wait_until="domcontentloaded",
                timeout=30_000,
            )
            if response is None:
                raise CollectionError("navigation", "HTTP応答を取得できませんでした")

            status = response.status
            retry_after = response.headers.get("retry-after")
            final_url = page.url

            if status < 200 or status >= 300:
                raise CollectionError(
                    "http_response",
                    f"取得先のHTTPステータス: {status}",
                    status,
                    retry_after,
                )

            stage = "page_identity"
            wait_for_page_outcome(page)
            page_type = detect_page_type(page, page.url)
            if page_type != "product":
                raise CollectionError(
                    "page_identity",
                    f"商品ページではない応答: {page_type}",
                    status,
                    retry_after,
                )

            final_url = page.url
            marketplace = normalized_host(final_url)
            if marketplace != expected_marketplace:
                raise CollectionError(
                    "marketplace",
                    f"サイト不一致: 期待={expected_marketplace}, 観測={marketplace}",
                    status,
                )

            observed_asin = extract_asin(page, final_url)
            if observed_asin != expected_asin.upper():
                raise CollectionError(
                    "product_identity",
                    f"ASIN不一致: 期待={expected_asin}, 観測={observed_asin}",
                    status,
                )

            title = normalized_text(
                page.locator("#productTitle").inner_text(timeout=10_000)
            )

            stage = "offer_wait"
            offer, raw_price, offer_selector = extract_offer_candidate(page)
            numeric_price = parse_strict_jpy_display(raw_price)
            currency_code = extract_currency_code(offer)
            seller, _ = first_visible_text(
                offer, ["#sellerProfileTriggerId", "#merchant-info"]
            )
            delivery, _ = first_visible_text(page, ["#glow-ingress-line2"])
            variation, variation_status = extract_variation_state(page)

            reasons = []
            if not expected_currency:
                reasons.append("期待する通貨が未指定です")
            elif currency_code != expected_currency:
                reasons.append(
                    "独立したISO通貨コードが未取得、または不一致です"
                )
            if not seller:
                reasons.append("選択した価格領域内の販売元が未取得です")
            if variation_status == "unresolved":
                reasons.append("バリエーションの選択状態が未確定です")
            if not state_loaded:
                reasons.append("準備済みのブラウザー状態を読み込んでいません")
            if not expected_delivery:
                reasons.append("期待する配送先表示が未指定です")
                delivery_status = "undeclared"
            elif not delivery:
                reasons.append("配送先表示を確認できませんでした")
                delivery_status = "missing"
            elif expected_delivery.casefold() not in delivery.casefold():
                reasons.append("配送先表示が期待する条件と一致しません")
                delivery_status = "mismatch"
            else:
                delivery_status = "observed_match"

            validation_status = (
                "candidate_context_complete"
                if not reasons
                else "candidate_manual_review"
            )

            captured_at = datetime.now(timezone.utc)
            return {
                "requested_url": url,
                "final_url": final_url,
                "asin": observed_asin,
                "title": title,
                "marketplace": marketplace,
                "variation": variation,
                "variation_status": variation_status,
                "seller": seller,
                "raw_price": raw_price,
                "numeric_price": numeric_price,
                "currency_symbol": raw_price[0],
                "currency_code": currency_code,
                "expected_currency": expected_currency or None,
                "delivery_location": delivery,
                "delivery_status": delivery_status,
                "offer_container": offer_selector,
                "captured_at_utc": captured_at.isoformat(),
                "captured_at_jst": captured_at.astimezone(
                    timezone(timedelta(hours=9))
                ).isoformat(),
                "http_status": status,
                "top_level_navigations": 1,
                "browser_request_count": network["requests"],
                "validation_status": validation_status,
                "missing_reason": "; ".join(reasons) or None,
            }
        except CollectionError:
            raise
        except (PlaywrightTimeoutError, PlaywrightError) as exc:
            category = classify_browser_error(exc, stage)
            raise CollectionError(category, "ブラウザー操作が失敗しました") from exc
        finally:
            if context is not None:
                context.close()
            if browser is not None:
                browser.close()


def main():
    required = (
        "ROLA_HTTP_PROXY_SERVER", "ROLA_PROXY_USERNAME", "ROLA_PROXY_PASSWORD",
        "AMAZON_PRODUCT_URL", "EXPECTED_ASIN", "EXPECTED_CURRENCY",
    )
    if any(not os.environ.get(key) for key in required):
        raise CollectionError("configuration", "必須の環境変数が未設定です")
    if os.environ["EXPECTED_CURRENCY"].upper() != "JPY":
        raise CollectionError("configuration", "このパーサーはJPY候補専用です")
    if normalized_host(os.environ["AMAZON_PRODUCT_URL"]) != "amazon.co.jp":
        raise CollectionError("configuration", "対象URLはAmazon.co.jpを指定してください")
    if urlparse(os.environ["AMAZON_PRODUCT_URL"]).scheme != "https":
        raise CollectionError("configuration", "商品URLはHTTPSで指定してください")
    if not re.fullmatch(r"[A-Z0-9]{10}", os.environ["EXPECTED_ASIN"].upper()):
        raise CollectionError("configuration", "ASINは10桁の英数字で指定してください")
    captured = collect_price(
        os.environ["AMAZON_PRODUCT_URL"],
        os.environ["EXPECTED_ASIN"],
        os.environ.get("EXPECTED_MARKETPLACE", "amazon.co.jp"),
    )

    expected_keys = set(EXPORT_COLUMNS)
    actual_keys = set(captured)
    if actual_keys != expected_keys:
        missing = sorted(expected_keys - actual_keys)
        extra = sorted(actual_keys - expected_keys)
        raise RuntimeError(f"出力列の不一致: missing={missing}, extra={extra}")

    # ページ由来の文字列をExcelの数式として実行させないための出力処理。
    def safe_cell(value):
        if isinstance(value, str):
            value = re.sub(r"[\x00-\x08\x0b\x0c\x0e-\x1f]", " ", value)
            if value.lstrip().startswith(("=", "+", "-", "@")):
                return "'" + value
        return value

    exported = {key: safe_cell(value) for key, value in captured.items()}
    frame = pd.DataFrame([exported], columns=EXPORT_COLUMNS)

    stamp = datetime.now(timezone.utc).strftime("%Y%m%dT%H%M%S%fZ")
    state = captured["validation_status"].replace("_", "-")
    base = Path(f"amazon-price-snapshot-{state}-{stamp}")
    frame.to_csv(base.with_suffix(".csv"), index=False, encoding="utf-8-sig")
    frame.to_excel(base.with_suffix(".xlsx"), index=False, engine="openpyxl")
    print(f"保存完了: {state} / {base}.csv / {base}.xlsx")


if __name__ == "__main__":
    try:
        main()
    except CollectionError as exc:
        details = [f"stage={exc.stage}"]
        if exc.status is not None:
            details.append(f"status={exc.status}")
        if exc.retry_after:
            details.append(f"retry_after={exc.retry_after}")
        print(f"取得を停止しました: {exc}. " + ", ".join(details))
        raise SystemExit(2)
python amazon_price_snapshot_ja.py
トップレベルの非2xx応答はすべて停止対象です。CAPTCHAやログイン画面の検出は専用要素を使い、通常のナビゲーションにある「ログイン」という文字だけでは判定しません。未知のページ、DOM変更、複数価格、通貨や配送先の不足は、停止または要確認として処理します。
セレクターは価格領域を絞るための候補です。#rightColのように広い領域では、数字が一つでも期待した販売価格とは限りません。また、販売元欄が複数の説明を含む場合や、表示されないバリエーションがある場合もあります。自動検査に通っても、同じ実行時点の画面・出品条件と照合してから比較用データへ昇格させます。
コードはHTTP応答、DNS、TLS、プロキシ認証、接続、処理段階のタイムアウトを区別します。ブラウザー例外の全文や、認証情報を含むプロキシURLは表示しません。DOMから得た文字列は、Excelで数式として解釈されないよう出力時に処理します。監査用の加工前データを別保存する場合はアクセスを制限します。
終了コードと検証状態の読み方
| 状態 | 意味 | 次の処理 |
|---|---|---|
candidate_manual_review |
商品と価格候補は取得したが、通貨・販売元・配送先などの確認が不足 | missing_reasonと同じ実行時点の画面を確認 |
candidate_context_complete |
コードが定義する自動検査を通過 | 販売価格の意味、販売元、バリエーション、配送条件を目視照合 |
complete_comparable_record |
人手による確認と証跡の保存まで完了した業務上の状態 | 比較用データへ追加。コード単独ではこの状態を出力しない |
終了コード2 |
応答、ページ、価格形式、接続などで停止 | 原因を調べ、価格レコードを作らない |
終了コード0はファイル出力の成功を表します。価格改定に利用できるデータが確定した意味ではありません。TLS検証の無効化、無限再試行、CAPTCHAの自動解決は実装していません。
Amazonの価格をスクレイピングしてExcelに出力する
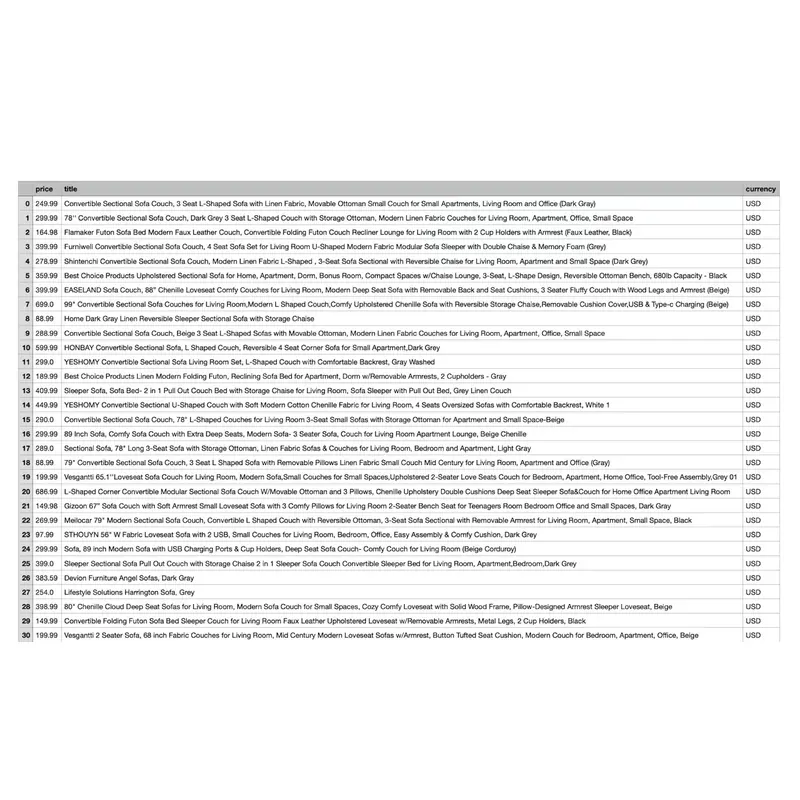
上のコードは、辞書のキーと定義済みの列を照合してからpandasのDataFrameを作成し、同じ候補レコードをCSVと.xlsxへ保存します。Excel出力にはopenpyxlを明示し、CSVは日本語を扱うExcelで読み込みやすいUTF-8 BOM付きにします。
ファイル名にUTC時刻を付けるため、観測履歴を残せます。日本の担当者向けにJST時刻も併記しますが、元のUTC時刻は維持します。欠損は空欄と理由で記録し、0円に置き換えません。
| 保存項目 | 確認できること | 日本向けの注意点 |
|---|---|---|
requested_url、final_url |
予定したページへ到達したか | Amazon.co.jp以外への遷移を検出 |
asin、title |
対象商品か | 親ASINと選択中の子ASINを混同しない |
marketplace |
どの国のサイトか | 言語設定やIPだけで判定しない |
variation、variation_status |
色・サイズなどの選択状態 | 選択なしと取得失敗を区別 |
seller |
価格候補に対応する販売元 | 発送元との混同、複合表示を確認 |
raw_price、numeric_price |
表示値と数値化した値 | 記号・桁区切りの情報を残す |
currency_symbol、currency_code |
通貨の根拠 | 円記号だけではJPYを確定しない |
delivery_location、delivery_status |
配送先の観測条件 | 公開データには個人住所を含めない |
captured_at_utc、captured_at_jst |
取得時刻 | 日次集計の基準時刻を統一 |
http_status、validation_status |
応答と検証の状態 | HTTP成功と比較可能性を分離 |
missing_reason |
なぜ空欄なのか | 品切れ、表示なし、抽出失敗を安易に同一視しない |
| 通信件数 | ブラウザーが開始した通信の数 | 転送バイト数や請求対象量とは異なる |
税込表示の有無、送料、ポイント、クーポン適用条件、参考価格、在庫・配送予定は業務に応じて追加します。このコードはこれらを抽出しないため、最終支払額やポイント込みの実質価格を確定する用途には、そのまま使えません。
Excelで数値比較する際はnumeric_price列を数値として読み込み、通貨と検証状態で絞り込みます。コードでは桁や精度を失わないため数値文字列で保存しています。外貨換算する場合も、元の金額を上書きせず、換算後金額、為替レートの出典、適用日を別列へ追加します。
取得失敗を、ネットワーク・応答・パーサーに分けて調べる
プロキシが検証できるのは主に接続経路です。アカウント制限、表示条件、セレクターの問題まで、すべてIP品質の問題と判断しないようにします。
| 症状 | 集める情報 | 対応と再確認 |
|---|---|---|
| HTTPプロキシが407を返す | プロトコル、認証形式、エンドポイント | 認証を修正し、許可されたIP確認先で経路を検証。Amazonアカウントのエラーとは区別 |
| 対象が非2xxを返す | ステータス、最終URL、時刻、Retry-After |
パース前に停止。利用条件と原因を確認してから再実行を判断 |
| 429 | 並列数、直近の通信・再試行、Retry-After |
バッチを停止。許可された再開時も負荷を抑え、IP変更で制限を追い越さない |
| 503 | 本文、ページ種別、時刻、他の失敗 | 一時的障害か認証画面かを確認。適切な場合だけ限定的に復旧を試す |
| DNS・TLS・接続・タイムアウト | 失敗段階と経路の接続性 | 経路を別検証し、同じ条件で原因を切り分ける。証明書検証を無効にしない |
| 200だが価格が違う・ない | ASIN、販売元、通貨、配送先、セレクター | 候補扱いまたは破棄。空欄を0円や値下がりにしない |
| CAPTCHA・ログイン・アカウント確認 | 専用画面、通知、最終URL | 実行を停止し、公式の確認手順や取得元を見直す |
IP、Cookie、配送先、ASIN、セレクターを同時に変更すると、結果が改善しても原因が分かりません。変更した条件を記録して比較します。
2026年にAmazonのスクレイピングに対するブロックを回避・低減する方法
不要な拒否や取得失敗を減らすには、取得元、頻度、セッション、停止条件を設計します。どのブラウザーやプロキシにも、Amazonの制限を常に回避できる設定はありません。ここで扱うのは、許可された取得における余分な通信と失敗の低減です。
- 少数のASINから始める。 最初は結果を1件ずつ目視し、価格の意味と出品条件を照合します。
- 並列数と更新頻度を業務に合わせる。 日次の意思決定に、分単位の全件取得が本当に必要かを確認します。安全を保証する一律のリクエスト数は設定しません。
- 関連する操作のセッションを維持する。 商品とバリエーションの確認中に条件を切り替えないようにします。ローテーションは許可された独立観測に限って検討します。
- 拒否や認証画面で止める。 403、429、503、CAPTCHA、予期しないページを連続取得しても、有効な価格データは増えません。
- 費用と失敗率の停止基準を先に決める。 基準を超えたら自動取得を止め、原因確認へ戻します。
通信量課金では、概算の従量費用は「請求対象GB×契約単価」です。最低購入量、利用期限、固定費、失敗・再試行時の計上、端数処理は別途確認します。リクエスト件数はGBの代わりにはなりません。転送量と実際の利用明細を測定してから予算を設定します。
必要な出口地域やセッション条件が明確になった段階で、Rola IPのAmazon向けプロキシ案内を確認してください。小規模な検証で、出口、出品条件の一致、失敗率、通信費を評価してから拡大します。Rola IPは接続経路を提供し、取得許可、パーサーの保守、応答検証、データ管理は利用側が担います。
まとめ
Amazonの価格スクレイピングの品質は、取得件数だけでは測れません。価格を保存する前に、商品・販売元・通貨・配送条件・取得時刻を照合し、候補と確認済みデータを分けることが重要です。
日本市場では、円表示に加え、税込・送料・ポイント・クーポンの条件を同じ基準で扱います。少数の商品で検証を完了し、失敗時の停止と費用管理が機能してから運用範囲を広げます。