用Python抓取Naver图片:官方API、分页与CSV导出
2026年9月30日 · 教程 · 13 分钟阅读
需要批量获取Naver图片搜索的标题、原图链接、缩略图和尺寸时,可使用官方Image Search API,并用Python将结果导出为CSV;若要观察网页卡片和预览,则应使用浏览器。示例最多请求1,000条结果记录,保留重复URL,不下载图片文件。API结果不一定与网页排序相同,代理不能替代API凭据或提高配额。
先了解Naver图片搜索页面
打开Naver图片搜索结果页,在搜索框输入关键词后,点击“이미지”(图片)标签。每张结果卡片通常包含缩略图、标题和来源域名,点击卡片后,右侧会出现放大预览和来源信息。
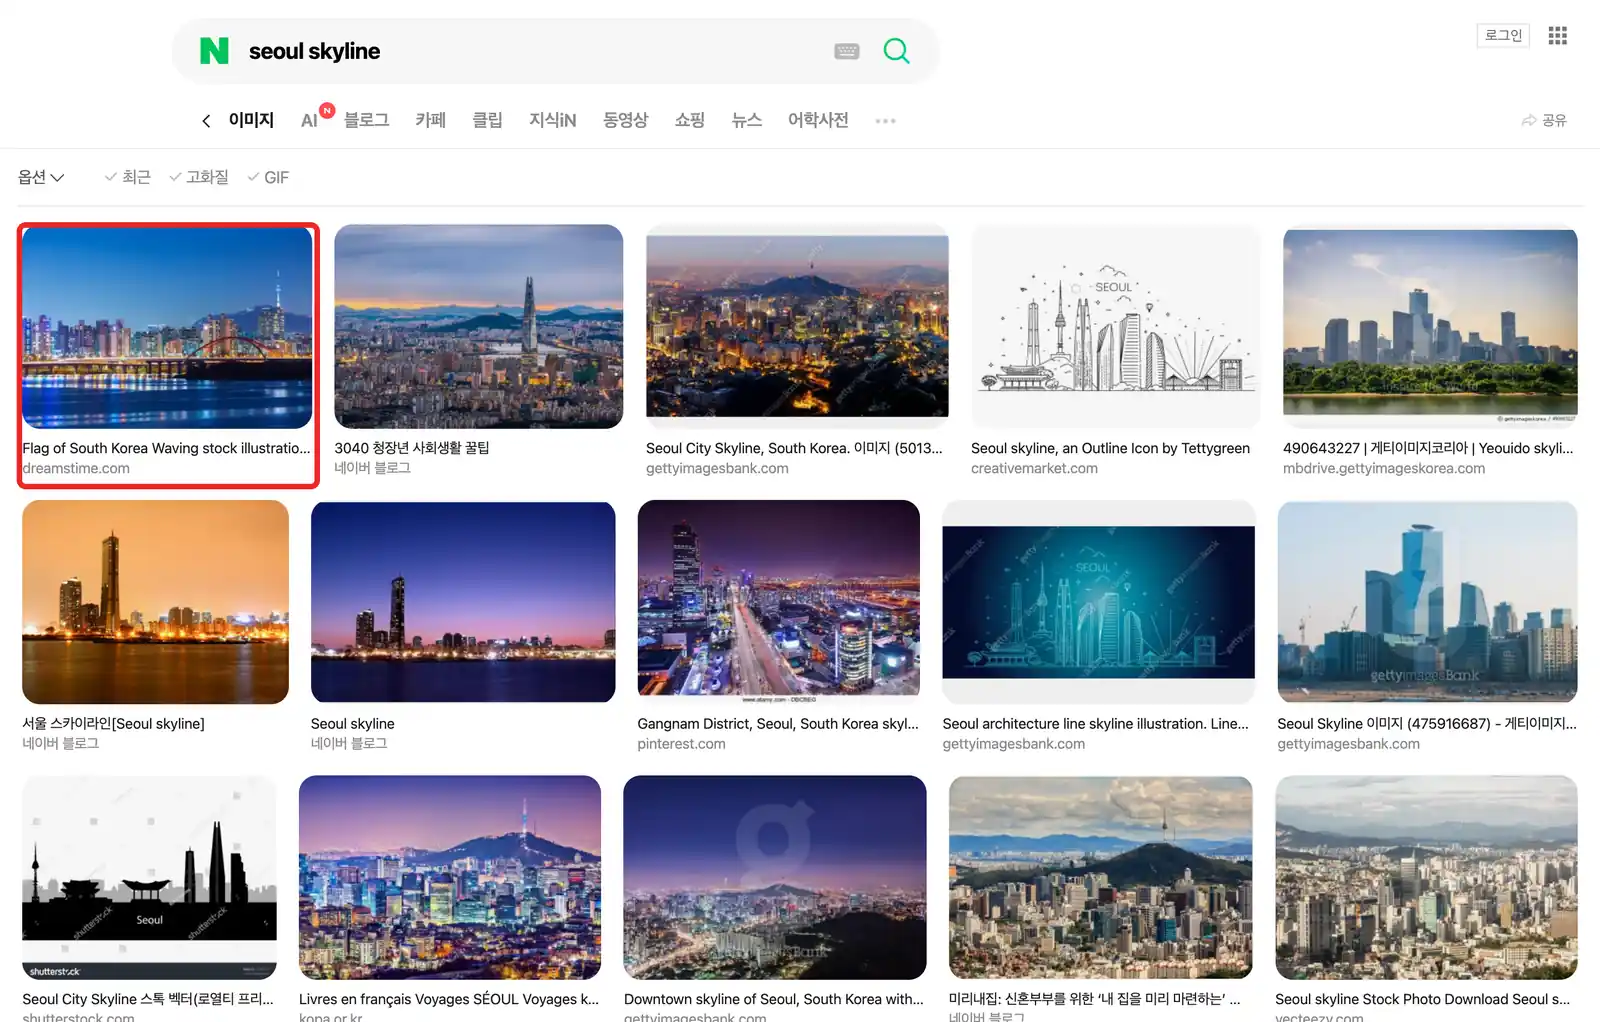
图1:Naver图片搜索结果页面。
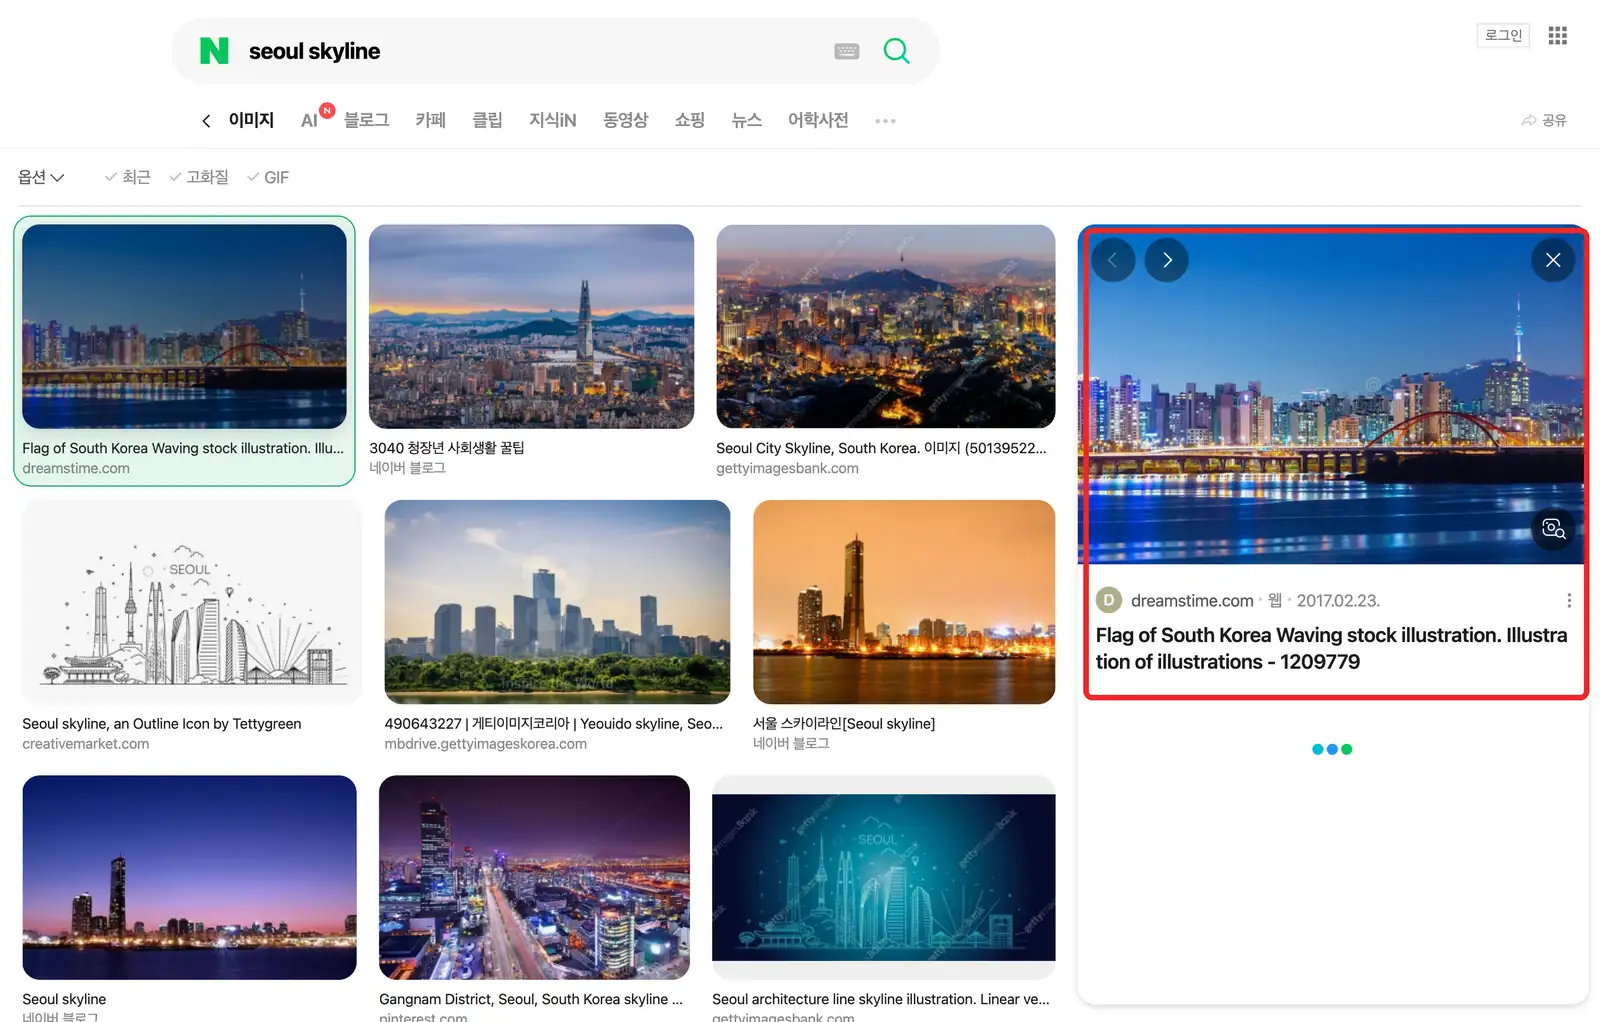
图2:点击结果后显示的预览面板。
网页上看到的内容与API返回的内容不一定一一对应。地区、时间、个性化设置和产品更新都会影响排序与数量,因此不要仅凭“网页第几张图片”和API第几条记录来判断程序是否正确。建议每次采集都记录关键词、执行时间和API参数,方便复核。
API抓取与网页抓取有什么区别?
Naver官方图片搜索API文档提供https://openapi.naver.com/v1/search/image接口。请求使用GET,并在请求头中携带Client ID与Client Secret。每条items记录可能包含title、link、thumbnail、sizewidth和sizeheight。
| 方法 | 适合场景 | 需要注意 |
|---|---|---|
| 官方图片搜索API | 批量取得图片元数据,并按参数分页 | 需要申请凭据,受官方配额和字段限制约束 |
| 浏览器读取搜索页 | 研究用户实际看到的卡片、预览和加载行为 | 页面结构会变化,懒加载结果不一定完整 |
| 下载图片文件 | 获取已获授权使用的像素文件 | 需单独确认版权、来源站限制和下载许可 |
图片搜索、地图和购物接口用途不同,不能把/v1/search/image的结果当成地图地点或商品库存。选择采集方式时,应先明确是要结构化元数据,还是要还原用户实际看到的页面。
第一步:注册应用并确认参数
在Naver Developers注册应用,启用Search API,取得Client ID和Client Secret。不要把凭据写入文章、截图或Git仓库。官方文档列出的参数范围为:display每页1–100条,start为1–1000,sort可用sim或date。本文脚本将单次运行请求的结果记录数限制在1–1,000条,这只是脚本限制,并不代表Naver总共只有这些结果。
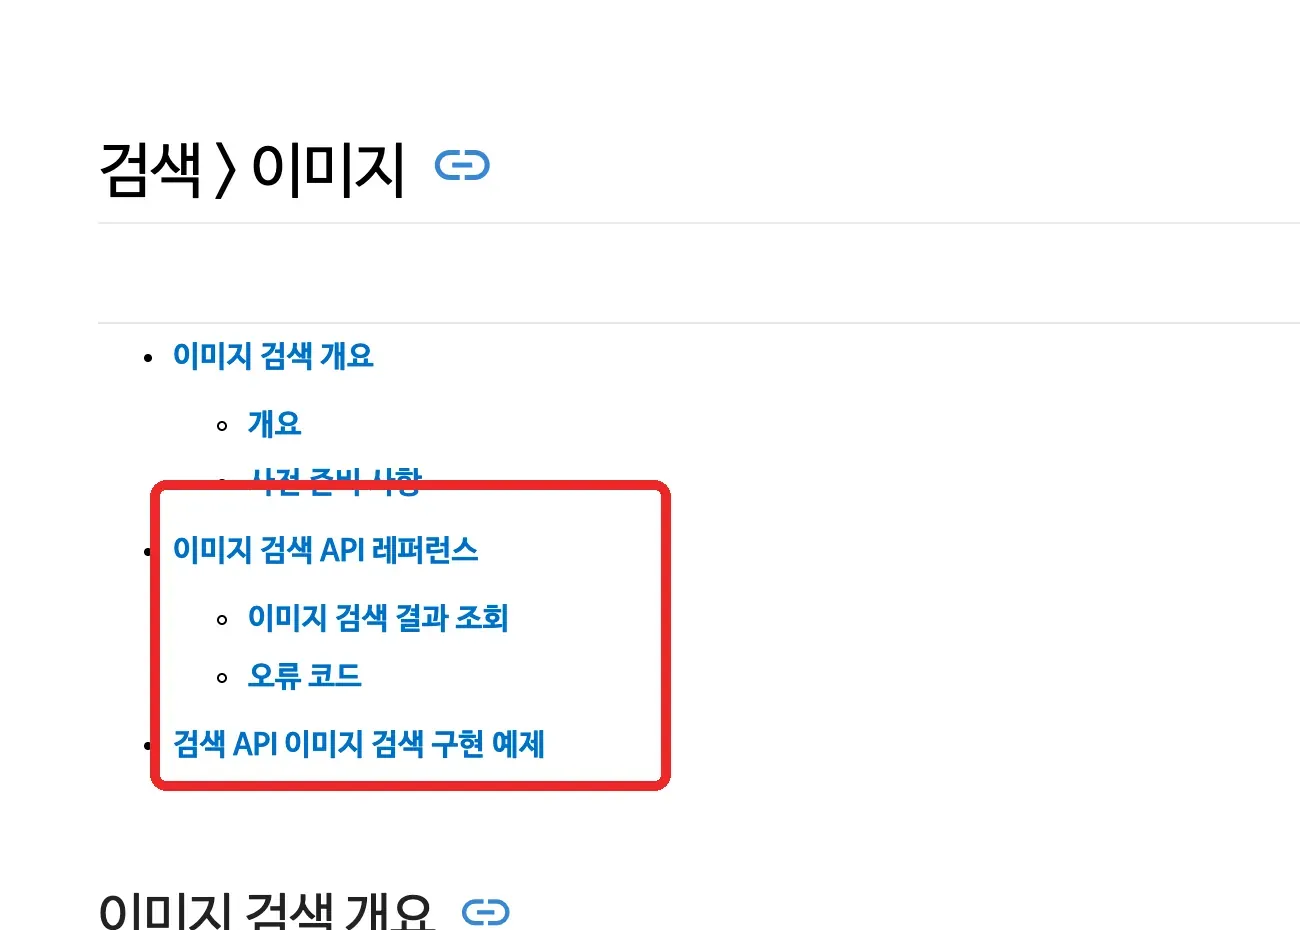
图3:Naver Developers图片搜索API文档。
link是图片地址,thumbnail是缩略图地址,sizewidth和sizeheight是像素尺寸。link不一定代表最高分辨率或可直接下载的原始文件。title通常是图片所在文档的标题,不一定是照片的正式名称。尺寸字段在官方文档中定义为字符串,导出时应保留原值。
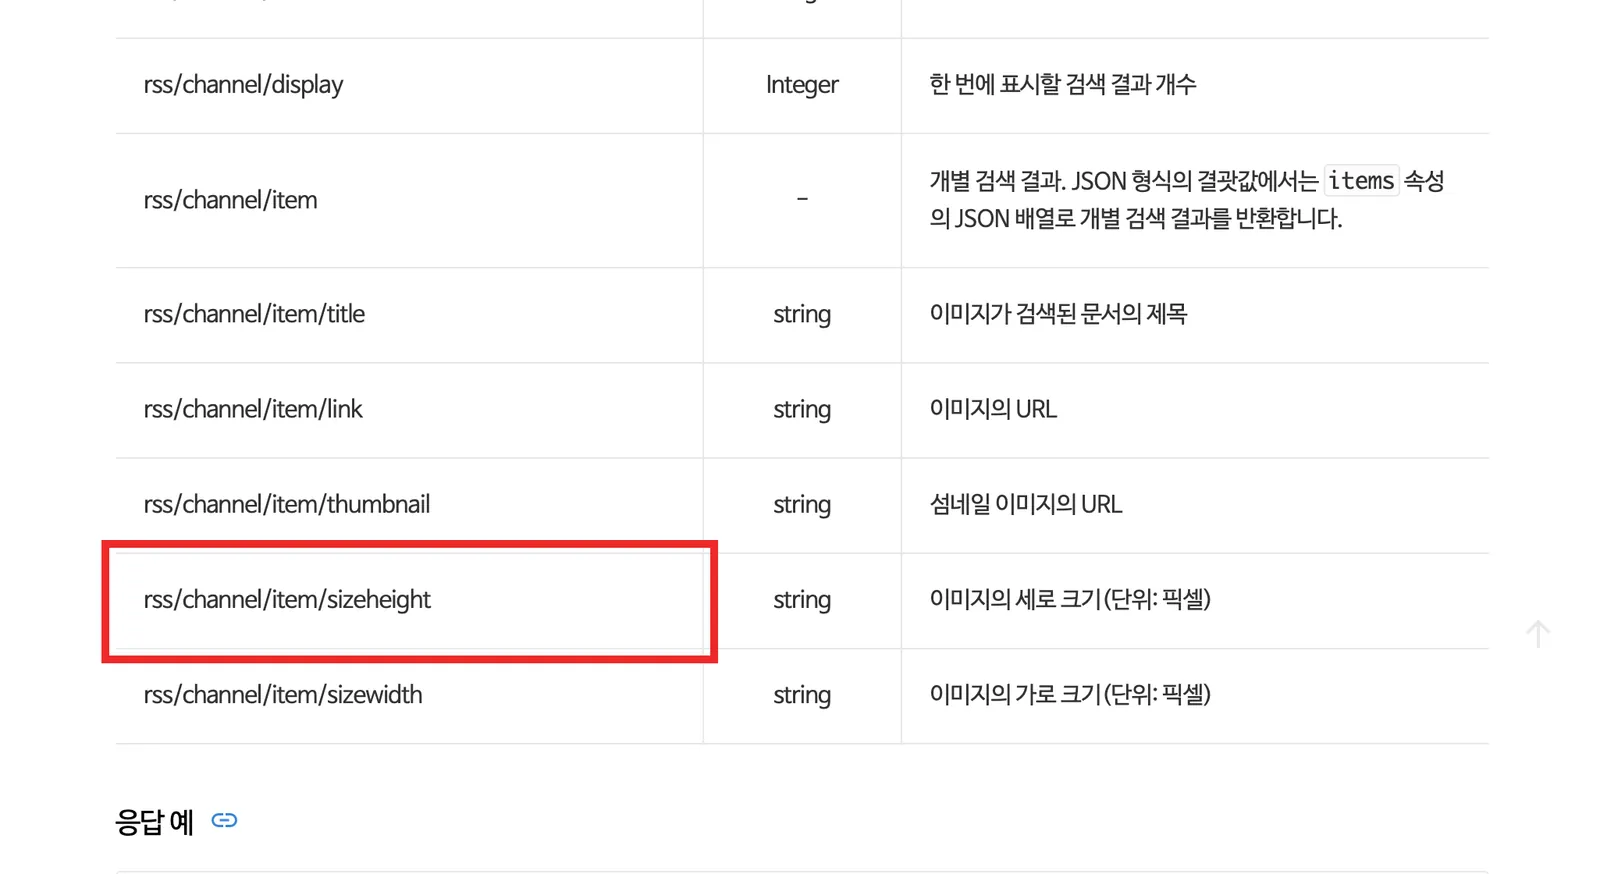
图4:官方字段说明。
第二步:准备Python环境和凭据
macOS/Linux:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requests
export NAVER_CLIENT_ID='你的 Client ID'
export NAVER_CLIENT_SECRET='你的 Client Secret'
Windows PowerShell:
py -m venv .venv
.\.venv\Scripts\python.exe -m pip install requests
$env:NAVER_CLIENT_ID = '你的 Client ID'
$env:NAVER_CLIENT_SECRET = '你的 Client Secret'
环境变量只在当前终端会话有效。若出现HTTP 403,先检查应用权限和Search API是否已启用,不要试图通过更换代理绕过授权。下文代码的验证范围见文末“验证范围”;没有Naver凭据时,不能把离线模拟等同于实时API访问。
第三步:用Python抓取标题、链接和尺寸
将以下代码保存为naver_image_api.py。脚本从环境变量读取凭据,按start=1、101、201……分页;每次请求都检查HTTP状态,针对常见错误输出诊断。标题中的HTML标签会被清理,CSV使用utf-8-sig,便于Excel显示韩文和中文。脚本在请求失败时不写本次CSV,也不自动重试;已有的同名文件不会被本次失败覆盖。
"""将 Naver 图片搜索 API 元数据导出为 CSV。"""
import argparse
import csv
import os
import re
from html import unescape

import requests

API_URL = "https://openapi.naver.com/v1/search/image"
FIELDNAMES = ["query", "title", "image_url", "thumbnail_url", "width", "height"]


def clean_title(value):
    return unescape(re.sub(r"<[^>]+>", "", value or ""))


def fetch_images(query, limit, client_id, client_secret, session=None):
    if not 1 <= limit <= 1000:
        raise ValueError("limit must be between 1 and 1000")
    http = session or requests.Session()
    headers = {
        "X-Naver-Client-Id": client_id,
        "X-Naver-Client-Secret": client_secret,
    }
    rows = []
    for start in range(1, limit + 1, 100):
        display = min(100, limit - len(rows))
        response = http.get(
            API_URL,
            headers=headers,
            params={"query": query, "display": display, "start": start, "sort": "sim"},
            timeout=20,
        )
        response.raise_for_status()
        payload = response.json()
        if not isinstance(payload, dict) or not isinstance(payload.get("items"), list):
            raise ValueError("API 响应缺少 items 列表")
        items = payload["items"]
        for item in items:
            rows.append({
                "query": query,
                "title": clean_title(item.get("title")),
                "image_url": item.get("link", ""),
                "thumbnail_url": item.get("thumbnail", ""),
                "width": item.get("sizewidth", ""),
                "height": item.get("sizeheight", ""),
            })
        if len(items) < display:
            break
    return rows


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("query", help="搜索词,例如 seoul skyline")
    parser.add_argument("--limit", type=int, default=100)
    parser.add_argument("--output", default="naver_images.csv")
    args = parser.parse_args()
    client_id = os.environ.get("NAVER_CLIENT_ID")
    client_secret = os.environ.get("NAVER_CLIENT_SECRET")
    if not client_id or not client_secret:
        parser.error("请先设置 NAVER_CLIENT_ID 和 NAVER_CLIENT_SECRET")
    if not args.query.strip() or not 1 <= args.limit <= 1000:
        parser.error("query 不能为空,limit 必须为 1–1000")
    try:
        rows = fetch_images(args.query, args.limit, client_id, client_secret)
    except requests.HTTPError as exc:
        response = exc.response
        status = response.status_code if response is not None else None
        advice = {
            400: "检查 query、display、start 和 sort 参数。",
            401: "检查 Client ID 和 Client Secret。",
            403: "检查应用权限及 Search API 是否已启用。",
            429: "检查速率限制和每日配额;更换代理不会增加配额。",
        }.get(status, "核对 API 状态及官方错误文档。")
        if status == 429 and response is not None:
            retry_after = response.headers.get("Retry-After")
            if retry_after:
                advice += f" 服务端建议的 Retry-After:{retry_after}。"
        parser.exit(1, f"API 请求失败(HTTP {status}):{advice}\n本次未写入 CSV。\n")
    except requests.Timeout:
        parser.exit(1, "请求超时:检查网络连接。本次未写入 CSV。\n")
    except (requests.RequestException, ValueError, TypeError):
        parser.exit(1, "请求或响应解析失败:检查网络和 API 响应格式。本次未写入 CSV。\n")
    with open(args.output, "w", encoding="utf-8-sig", newline="") as file:
        writer = csv.DictWriter(file, fieldnames=FIELDNAMES)
        writer.writeheader()
        writer.writerows(rows)
    print(f"已保存 {len(rows)} 条记录到 {args.output}")


if __name__ == "__main__":
    main()
运行示例:
python naver_image_api.py 'seoul skyline' --limit 120 --output naver_images.csv
Windows PowerShell:
.\.venv\Scripts\python.exe naver_image_api.py 'seoul skyline' --limit 120 --output naver_images.csv
成功时,命令退出码为0,终端会显示实际保存的行数,CSV包含6列表头。这个数字可能小于limit,因为API可能返回较少结果。脚本不会自动重试;请求失败时退出码为1,不写入本次CSV,也不会覆盖旧文件。若输出路径无法写入,文件系统错误仍需由调用方处理。
分页如何计算?
当limit=250时,最多请求三页:start=1, display=100;start=101, display=100;start=201, display=50。如果第二页只返回30条,脚本会提前结束,不再请求第三页。这样既避免写入空页,也不会超出代码设定的起始位置上限。
脚本会自动去重吗?
不会。脚本保留API返回的所有记录,因此同一个image_url可能出现多次。若分析需要每个URL只保留一行,可在导出的CSV中按image_url去重;合并多个关键词时,应保留每个关键词字段,避免丢失来源。
第四步:核对CSV与API响应
检查字段映射:title对应title,image_url对应link,thumbnail_url对应thumbnail,width和height对应sizewidth与sizeheight,query则记录输入关键词。随机检查标题是否可读、URL是否为空、尺寸字符串是否保留,并在获得许可的前提下打开少量图片或缩略图。不要要求API的排序和网页数量完全一致。
用Excel打开时,可直接双击CSV,或通过“数据→从文本/CSV”导入并选择UTF-8。utf-8-sig能减少韩文乱码,但不同版本Excel仍可能需要手动确认编码。
什么时候应使用浏览器自动化?
如果研究重点是网页上实际显示的卡片、点击后的右侧预览,或滚动后新增内容,API字段并不能完整表达这些视觉和交互信息。此时可使用Playwright或Selenium打开图片搜索页,通过开发者工具观察DOM属性和网络请求。
浏览器采集要等待页面渲染和懒加载完成:先确认关键词和图片标签,再等待首屏卡片出现;每次滚动后等待卡片数量稳定;最后记录标题、缩略图和来源,并按URL去重。不要长期依赖某个Naver CSS类名,也不要连续快速滚动,否则可能漏采。页面结构变化后,应重新检查真实页面并更新选择器。仅采集有权使用的数据,遵守目标站使用条款及适用的访问规则,并另行核对图片来源站的版权与使用许可;不要绕过登录或访问控制。
Rola IP何时能帮助Naver图片研究?
调用官方图片搜索API时,建议先使用直连。代理不能替代Client ID、Client Secret,也不会增加应用配额。只有在获得授权、需要比较不同网络地区实际看到的图片页面时,Naver代理解决方案才有帮助。
按照代理快速开始指南配置主机、端口、用户名和密码,并验证实际出口IP与位置。需要国家、州或城市定向时,可参考动态住宅代理配置;会话、轮换和地区字段可查阅代理参数。
一次对比实验应使用同一会话ID,按当前文档选择会话持续时间,并验证实际出口IP是否稳定;新实验再更换会话ID。逐请求轮换模式不适合要求同一出口的对比。记录关键词、目标地区、实际IP/位置、会话ID、时间、浏览器、语言、登录状态和页面URL,同时控制个性化设置与访问时机。浏览器扩展中的代理配置不会自动作用于独立运行的Python requests进程。
图5:用于授权区域页面对比的代理地址示例。
常见错误排查
| 现象 | 优先检查 | 处理建议 |
|---|---|---|
| 缺少凭据 | 当前终端是否同时设置两个环境变量 | 重新导出变量,不要硬编码 |
| HTTP 401/403 | Client ID、Secret和应用权限 | 在开发者后台确认Search API已启用 |
| HTTP 400 | query、display、start、sort |
对照官方参数范围修正 |
| HTTP 429 | 每日配额或每秒速率限制 | 脚本会显示响应中的Retry-After(若有);检查限制类型,等待或降频后再人工重试,换代理不能增加配额 |
CSV行数少于limit |
API本次实际返回的items数量 |
检查关键词和本次响应 |
| 图片URL无法打开 | 来源链接是否变化或受限 | 保留元数据,单独核验来源和权限 |
Naver在通用API错误指南中区分每日配额错误和每秒请求限制。示例脚本遇到错误会停止,不会自动重试。若响应中有Retry-After,脚本只显示其值;等待和再次请求由使用者决定。
验证范围
2026年9月30日在Windows 10(10.0.19045)、Python 3.14.4和requests 2.33.1环境下,以模拟API响应进行离线检查:limit=250时,请求参数依次为(start=1, display=100)、(101,100)、(201,50);第二页仅返回30条时,共得到130条并停止。测试还覆盖标题HTML实体还原、字段映射、重复URL保留、CSV字段序列化,以及401、403、429(含Retry-After)、响应缺少items和超时分支。上述检查不涉及实时Naver API、图片文件下载、macOS/Linux执行、Excel实际渲染或代理连通性;实际调用需要自己的应用凭据。
以下是一条模拟响应经主程序写入内存CSV后的脱敏输出,展示列名和字符编码路径:
已保存 1 条记录到 demo.csv
query,title,image_url,thumbnail_url,width,height
首尔风景,서울 & 中国,https://example.org/a,https://example.org/t,100,80
总结
抓取Naver图片前,先明确需要API元数据还是网页体验:标题、图片地址、缩略图和尺寸可通过官方API获取;卡片、预览和滚动加载需要浏览器观察。导出CSV后抽查字段、编码和URL。Rola IP仅适用于有授权的区域化页面观察,不能替代API凭据或扩大官方配额。