
Reddit网页抓取教程:用Python和PRAW采集帖子、评论与回复
2026年10月13日 · 教程 · 20 分钟阅读
Reddit网页抓取需求可以通过API采集或HTML解析实现。本文以Python和PRAW连接Reddit Data API为主,获取帖子、评论和嵌套回复并导出CSV,同时介绍少量页面字段的HTML解析方法。这个流程适合需要分析主题讨论、检索关键词或整理用户反馈的开发者和数据分析人员,前提是应用已取得相应访问权限。
本文从环境配置开始,依次介绍版块列表、关键词搜索、单条帖子和评论树的读取方法,并提供可直接保存的完整导出脚本。最后说明HTML解析的适用场景、代理接入方法,以及401、403、429和503错误的排查顺序。
先看结论
- 需要稳定字段、评论层级和批量导出时,优先使用经过授权的Reddit Data API和PRAW。
- 每条评论至少保存
post_id、comment_id和parent_id,这样后续才能重建回复关系。 replace_more()会增加请求量;限制最终导出的行数,并不等于限制评论展开过程消耗的请求。- CSV中建议记录UTC时间、原帖链接、版块名称和采集时间,方便复核数据来源。
- 代理只能改变网络出口,不能替代Reddit应用授权,也不能提高API配额或规避限流。
本文将完整导出脚本直接放在下方代码块中,无需下载附件。将代码保存为reddit_scraper_v2.py,并在同一目录中执行后续命令。示例默认不保存作者名称,使用时应根据业务目的设置数据保留期限,并处理删除请求和适用的隐私要求。
Reddit网页抓取能采集哪些数据
| 数据对象 | 常见字段 | 适用场景 |
|---|---|---|
| Subreddit | 名称、描述、成员数量、公开属性 | 确定讨论范围,理解社区背景 |
| 帖子 | 标题、正文、作者、发布时间、得分、评论数、URL | 主题研究、内容趋势和问题分类 |
| 评论与回复 | 正文、作者、时间、得分、post_id、parent_id |
反馈分析、对话关系和问题归纳 |
| 公开用户活动 | 公开帖子或评论及其链接 | 仅在获准范围内分析公开内容,尽量减少个人数据 |
得分和评论数量会随时间变化,已删除或被移除的内容也可能无法再次获取。导出时最好同时保存原始链接、社区名称和采集时间。帖子页面显示的评论数只是某一时刻的快照,不能直接当作CSV行数。
如何选择Reddit数据采集方式
| 方式 | 更适合的任务 | 需要注意的事项 |
|---|---|---|
| Data API + PRAW | 需要结构化字段、分页、评论树和批量导出 | 遵守应用权限和官方限流,检查OAuth配置 |
| HTML + BeautifulSoup | 只读取少量获准公开页面上的可见字段 | 页面结构容易变化,必须识别登录页、挑战页和动态空壳 |
| 无代码工具 | 已有少量帖子URL,只需得到简单表格 | 核对工具支持的回复深度、字段和导出格式 |
长期运行的项目应优先考虑官方接口,因为字段和错误更容易追踪。如果只是核对几页公开内容,获准的HTML读取也可能足够。页面抓取和API各有适用边界,本文后续示例采用结构更稳定的PRAW工作流。
数据使用与保留要求可查阅Reddit Data API Terms。
安装PRAW并验证Reddit API
准备凭据
- 准备Python3.12环境,并在项目目录中安装下方依赖。
- 准备已获准访问Data API的应用,取得client ID、client secret,并设置包含应用名称和联系用户名的user agent。创建应用和取得数据访问许可是两个需要分别确认的环节。
- 通过环境变量或密钥管理器提供凭据,不要把真实密钥写进代码或提交到Git。
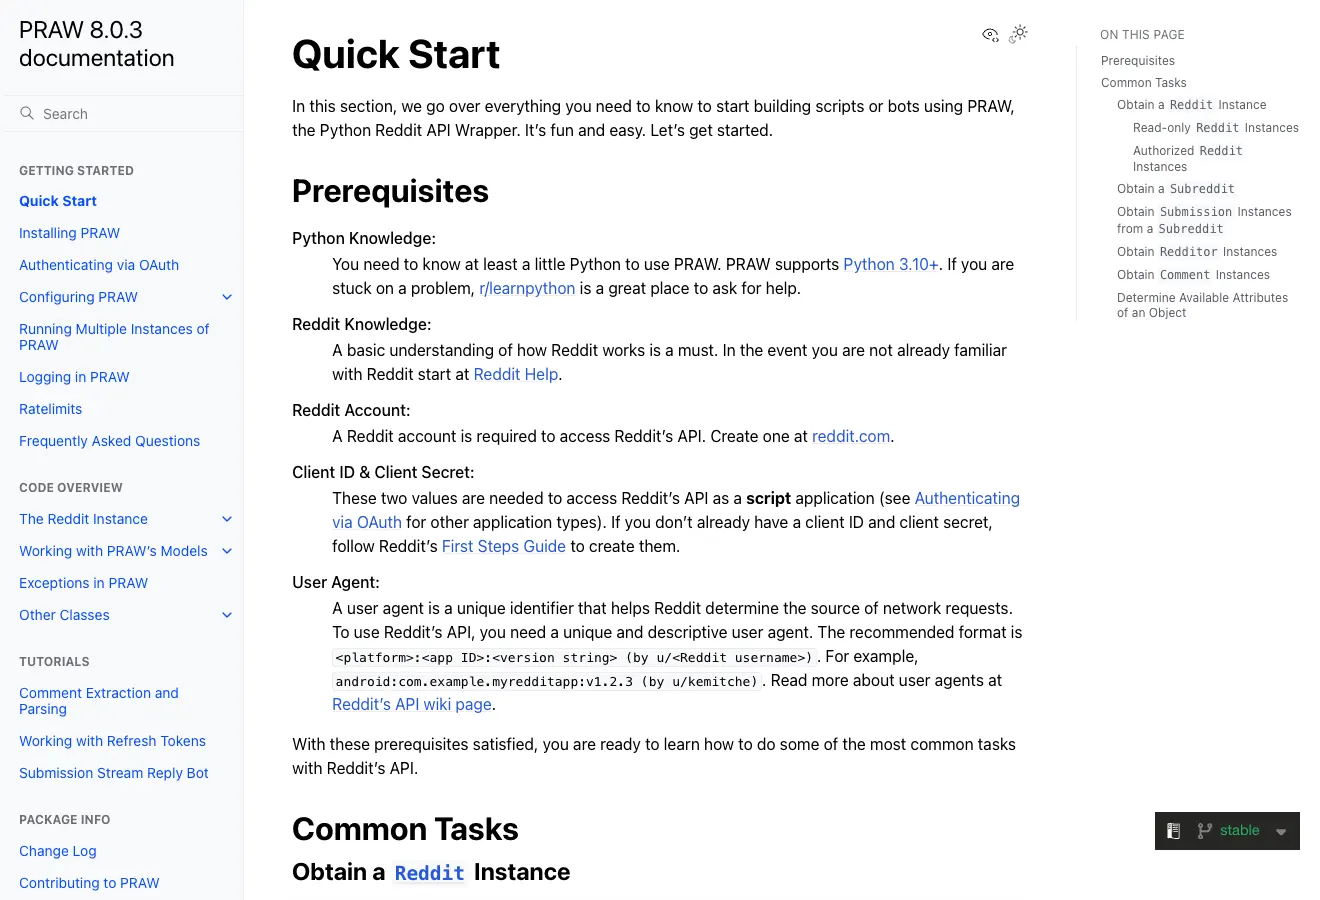
图1:PRAW快速开始文档中的凭据配置示例。
凭据字段和只读客户端的写法可参考PRAW Quick Start。先将下面的内容保存为项目目录中的requirements.txt:
beautifulsoup4==4.15.0
certifi==2026.7.22
charset-normalizer==3.5.1
defusedxml==0.7.1
idna==3.20
praw==8.0.3
prawcore==4.0.0
requests==2.34.2
soupsieve==2.10
typing_extensions==4.16.0
update_checker==1.0.0
urllib3==2.8.0
websocket-client==1.9.2
版本来源为PyPI,上述13项版本及其Python要求已于2026年10月13日核对。本教程使用Python3.12;以下命令从PyPI安装锁定依赖。
在同一目录执行安装命令:
python -m pip install --index-url https://pypi.org/simple -r requirements.txt
Windows PowerShell使用以下命令配置当前终端会话。将your_client_id、your_client_secret和your_name替换为自己的应用信息和Reddit用户名:
$env:REDDIT_CLIENT_ID="your_client_id"
$env:REDDIT_CLIENT_SECRET="your_client_secret"
$env:REDDIT_USER_AGENT="windows:research-export:1.0 (by u/your_name)"
macOS或Linux的Bash终端使用export:
export REDDIT_CLIENT_ID="your_client_id"
export REDDIT_CLIENT_SECRET="your_client_secret"
export REDDIT_USER_AGENT="script:research-export:1.0 (by u/your_name)"
后续Python命令应在配置了这些变量的同一终端执行。这样可以让脚本读取凭据,无需将密钥写入源码。
先取回一条帖子再判断连接是否成功
仅打印reddit.subreddit("Python")的名称,并不能证明已经访问API,因为PRAW的部分对象属性是惰性加载的。下面的代码实际消费一个帖子列表,并输出返回的帖子ID。
import os
import praw

reddit = praw.Reddit(
    client_id=os.environ["REDDIT_CLIENT_ID"],
    client_secret=os.environ["REDDIT_CLIENT_SECRET"],
    user_agent=os.environ["REDDIT_USER_AGENT"],
    timeout=20,
    ratelimit_seconds=0,
    check_for_updates=False,
)

try:
    posts = list(reddit.subreddit("Python").new(limit=1))
    if posts:
        print("API returned post:", posts[0].id)
    else:
        print("Listing returned no posts; inspect scope and community.")
except Exception as exc:
    print("API check failed:", type(exc).__name__)
    raise SystemExit(1)
如果返回401或403,先检查一下应用状态、凭据和授权范围。空列表不一定是认证失败,也可能是版块范围或内容可见性造成的。
获取版块帖子和自动分页
new适合最新讨论,hot适合当前热门内容,top可以配合week或month等时间范围。PRAW的listing generator会根据API返回的游标继续请求,你不需要手动拼接网页分页URL。
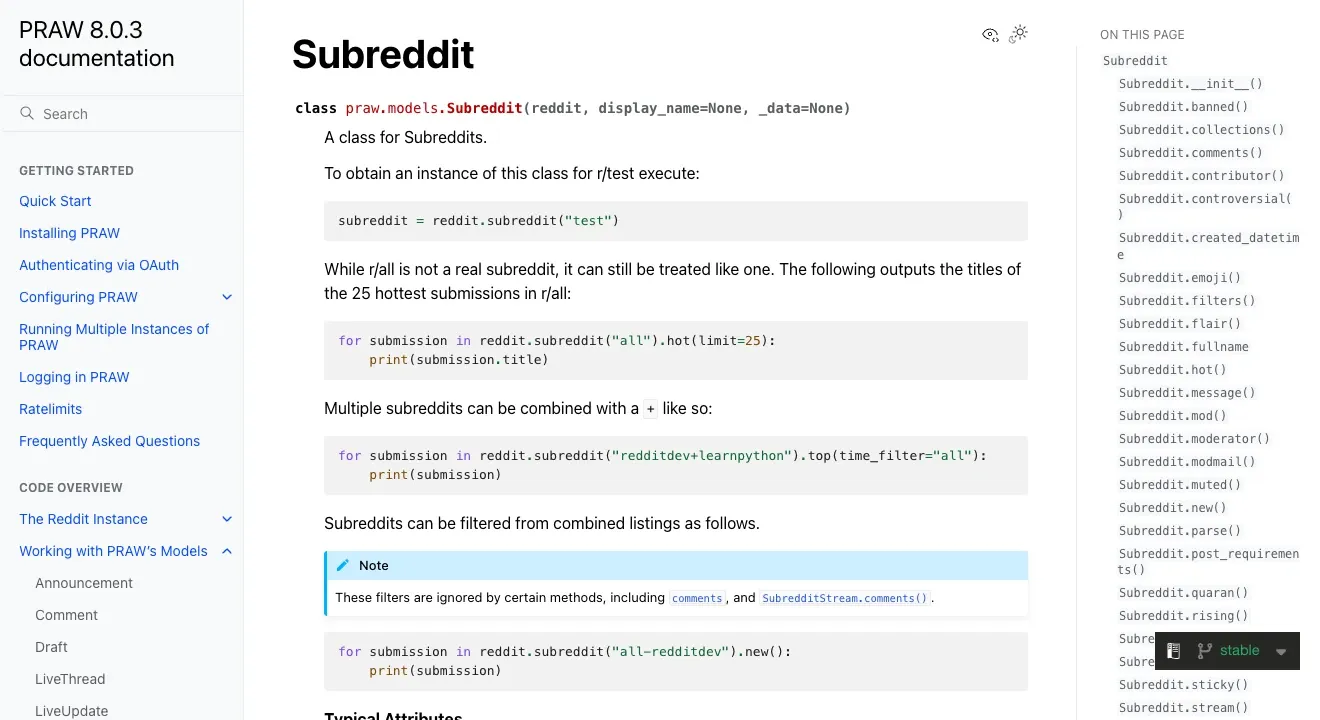
图2:PRAW Subreddit文档展示版块列表和搜索入口。
subreddit = reddit.subreddit("Python")

for post in subreddit.new(limit=10):
    print(post.id, post.title, post.score, post.num_comments)

for post in subreddit.top(time_filter="week", limit=10):
    print(post.id, post.title)
如果只需要帖子,就不要展开评论。标题、正文和媒体地址是不同字段:文字帖通常有selftext,链接帖可能没有正文,而post.url指向提交的目标地址。建议保存两者,避免把空正文误判为空帖子。
from datetime import datetime, timezone

row = {
    "post_id": post.id,
    "title": post.title,
    "body": post.selftext or "",
    "url": post.url,
    "permalink": "https://www.reddit.com" + post.permalink,
    "created_at_utc": datetime.fromtimestamp(
        post.created_utc, timezone.utc
    ).isoformat(),
}
按关键词搜索Reddit帖子
搜索时先限定目标版块,再确定关键词、排序方式和时间范围。开始扩大数据量前,人工检查前几条结果是否真的符合研究问题。站内搜索受索引、权限和删除状态影响,不能当作完整历史档案。
results = reddit.subreddit("Python").search(
    "proxy", sort="new", time_filter="month", limit=20
)

for post in results:
    print(post.id, post.title, post.permalink)
这里的proxy只是示例。实际项目应使用与你的研究问题相匹配的词,并为不同版块保存一致的过滤条件,保证后续比较可复现。
获取单条帖子和公开版块信息
已知帖子ID后,可以直接请求submission对象,不必再次从列表中寻找。ID是/comments/后面的标识,不是完整URL。版块描述等公开属性应单独读取,因为某些社区可能没有填写这些字段。
post = reddit.submission(id="replace_with_post_id")
print(post.title)
print(post.selftext)
print(post.url)
print(post.score, post.num_comments)

community = reddit.subreddit("Python")
print(community.display_name, community.public_description)
抓取评论和嵌套回复
评论采集的关键不是单纯“拿到更多文本”,而是保留对话关系:
- 加载目标帖子。
- 用有限的
replace_more(limit=...)展开评论树;limit=0表示不继续展开占位节点。 - 为每条评论保存
post_id、comment_id和parent_id。 - 根据
parent_id的类型前缀区分顶层评论与多层回复。
parent_id使用Reddit的完整标识:t3_表示帖子,t1_表示评论。例如,t3_abc123指向post_id为abc123的帖子,t1_def456指向comment_id为def456的评论。关联CSV时,需要先识别前缀,再与对应表中的ID匹配。
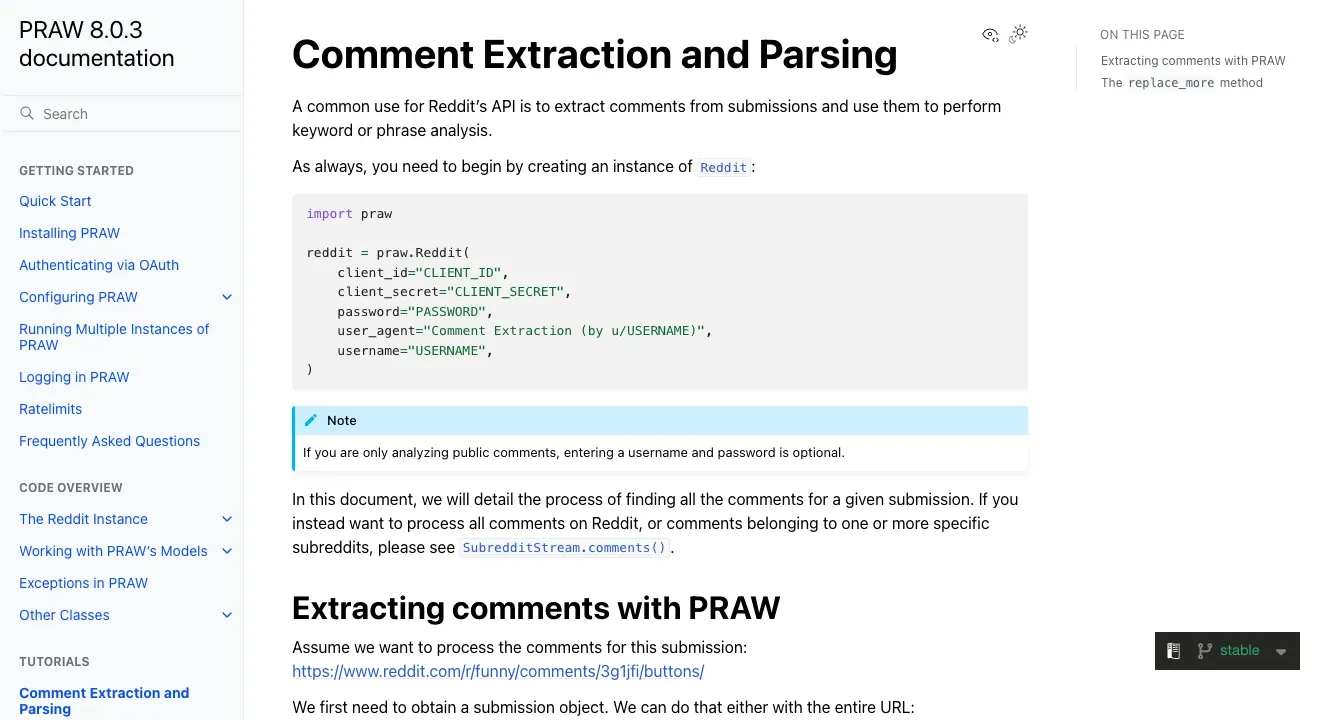
图3:PRAW评论提取教程中的客户端配置和帖子读取说明。
post = reddit.submission(id="replace_with_post_id")
post.comments.replace_more(limit=2)

for comment in post.comments.list()[:50]:
    print({
        "post_id": post.id,
        "comment_id": comment.id,
        "parent_id": comment.parent_id,
        "body": comment.body,
        "permalink": "https://www.reddit.com" + comment.permalink,
    })
replace_more(limit=None)会尽可能展开占位节点,因此热门长帖可能产生大量请求。如果只想读取已经加载的第一批评论,可使用replace_more(limit=0),但结果并不完整。代码中的[:50]只限制最终输出行数,不会减少前面评论展开已经消耗的请求。
建议默认不导出作者名称,也不要尝试恢复被删除的内容。截断导出时,某条回复的父评论可能不在结果中;保存parent_id也不代表父行一定存在。更多评论树细节可参考PRAW评论提取与解析。
将帖子和评论导出为CSV
实际分析时,最好拆成两个文件:reddit_posts.csv每行一个帖子,reddit_comments.csv每行一条评论。两个文件通过post_id关联,评论表中的parent_id用于保留回复层级。下面的完整导出脚本包含配置、CSV写入、失败状态和公式注入防护。将其复制到新的UTF-8文件reddit_scraper_v2.py中即可运行。
"""Small authorized Reddit exports. No credentials or raw exception URLs are logged."""
import argparse
import csv
import json
import logging
import os
import sys
import time
from datetime import datetime, timezone
from pathlib import Path

import praw
import requests

POST_FIELDS = ["subreddit", "post_id", "title", "body", "author", "created_at_utc",
               "collected_at_utc", "score", "num_comments", "url", "permalink"]
COMMENT_FIELDS = ["subreddit", "post_id", "comment_id", "parent_id", "body",
                  "author", "created_at_utc", "collected_at_utc", "score", "permalink"]


def utc(seconds=None):
    return datetime.fromtimestamp(seconds if seconds is not None else time.time(),
                                  timezone.utc).isoformat()


def post_row(post, include_authors=False):
    return dict(subreddit=post.subreddit.display_name, post_id=post.id,
                title=post.title, body=post.selftext or "",
                author=str(post.author) if include_authors and post.author else "",
                created_at_utc=utc(post.created_utc), collected_at_utc=utc(),
                score=post.score, num_comments=post.num_comments, url=post.url,
                permalink="https://www.reddit.com" + post.permalink)


def comment_row(comment, post, include_authors=False):
    return dict(subreddit=post.subreddit.display_name, post_id=post.id,
                comment_id=comment.id, parent_id=comment.parent_id, body=comment.body,
                author=str(comment.author) if include_authors and comment.author else "",
                created_at_utc=utc(comment.created_utc), collected_at_utc=utc(),
                score=comment.score, permalink="https://www.reddit.com" + comment.permalink)


def safe_cell(value):
    # Protect spreadsheet users from untrusted formula-like text.
    if isinstance(value, str) and value.lstrip().startswith(("=", "+", "-", "@")):
        return "'" + value
    return value


def write_csv(path, fields, rows):
    with path.open("w", encoding="utf-8-sig", newline="") as handle:
        writer = csv.DictWriter(handle, fieldnames=fields)
        writer.writeheader()
        writer.writerows({key: safe_cell(value) for key, value in row.items()} for row in rows)


def make_client():
    # Library retry messages may include request details; emit only sanitized errors.
    logging.getLogger("prawcore").disabled = True
    logging.getLogger("praw").disabled = True
    names = ["REDDIT_CLIENT_ID", "REDDIT_CLIENT_SECRET", "REDDIT_USER_AGENT"]
    if any(not os.environ.get(name) for name in names):
        raise ValueError("Set REDDIT_CLIENT_ID, REDDIT_CLIENT_SECRET and REDDIT_USER_AGENT.")
    session = requests.Session()
    session.trust_env = False
    proxy = os.environ.get("ROLA_PROXY_URL")
    if proxy:
        if not proxy.startswith(("http://", "https://")):
            raise ValueError("ROLA_PROXY_URL must be an HTTP(S) proxy URL.")
        session.proxies.update(http=proxy, https=proxy)
    return praw.Reddit(client_id=os.environ[names[0]], client_secret=os.environ[names[1]],
                       user_agent=os.environ[names[2]], requestor_kwargs={"session": session},
                       timeout=20, ratelimit_seconds=0, check_for_updates=False)


def export(reddit, args):
    # Refuse to overwrite an existing export, including one from a failed attempt.
    folder = Path(args.output_dir)
    folder.mkdir(parents=True, exist_ok=False)
    posts, comments = [], []
    start = time.monotonic()
    state = {"status": "running", "started_at_utc": utc(),
             "mode": "single" if args.post_id else "search" if args.query else "new",
             "post_limit": args.limit, "comments_per_post": args.comments_per_post,
             "more_limit": args.more_limit, "include_authors": args.include_authors,
             "proxy_enabled": bool(os.environ.get("ROLA_PROXY_URL")),
             "coverage": "bounded sample; not a complete archive"}
    failure = None
    try:
        if args.post_id:
            source = [reddit.submission(id=args.post_id)]
        elif args.query:
            source = reddit.subreddit(args.subreddit).search(
                args.query, sort="new", time_filter="month", limit=args.limit)
        else:
            source = reddit.subreddit(args.subreddit).new(limit=args.limit)
        for post in source:
            if time.monotonic() - start >= args.max_seconds:
                state["status"] = "stopped_at_time_budget"
                break
            posts.append(post_row(post, args.include_authors))
            if args.comments_per_post:
                post.comments.replace_more(limit=args.more_limit)
                for comment in post.comments.list()[:args.comments_per_post]:
                    comments.append(comment_row(comment, post, args.include_authors))
        else:
            state["status"] = "completed" if posts else "completed_empty"
    except Exception as exc:
        failure = exc
        state["status"] = "failed_partial"
        state["error_type"] = type(exc).__name__
        response = getattr(exc, "response", None)
        if response is not None:
            state["http_status"] = response.status_code
            state["retry_after"] = response.headers.get("Retry-After")
    finally:
        write_csv(folder / "reddit_posts.csv", POST_FIELDS, posts)
        write_csv(folder / "reddit_comments.csv", COMMENT_FIELDS, comments)
        state.update(finished_at_utc=utc(), posts=len(posts), comments=len(comments))
        (folder / "run_metadata.json").write_text(json.dumps(state, indent=2), encoding="utf-8")
    if failure:
        print("Export stopped: " + type(failure).__name__ +
              ". Inspect run_metadata.json; partial files are not a successful run.", file=sys.stderr)
        return 1
    print(json.dumps(state, indent=2))
    return 0 if state["status"] in ("completed", "completed_empty") else 2


def parser():
    result = argparse.ArgumentParser(description=__doc__)
    mode = result.add_mutually_exclusive_group()
    mode.add_argument("--query")
    mode.add_argument("--post-id")
    result.add_argument("--subreddit", default="Python")
    result.add_argument("--limit", type=int, default=10)
    result.add_argument("--comments-per-post", type=int, default=50)
    result.add_argument("--more-limit", type=int, default=0)
    result.add_argument("--max-seconds", type=int, default=120)
    result.add_argument("--include-authors", action="store_true")
    result.add_argument("--output-dir", default="reddit_output")
    return result


def main():
    arg_parser = parser()
    args = arg_parser.parse_args()
    for name, low, high in [("limit", 1, 100), ("comments_per_post", 0, 500),
                            ("more_limit", 0, 10), ("max_seconds", 1, 600)]:
        if not low <= getattr(args, name) <= high:
            arg_parser.error(f"{name} must be between {low} and {high}")
    try:
        with make_client() as reddit:
            return export(reddit, args)
    except ValueError as exc:
        print(str(exc), file=sys.stderr)
    except FileExistsError:
        print("Output directory already exists. Choose a new --output-dir.", file=sys.stderr)
    except Exception as exc:
        print("Stopped: " + type(exc).__name__, file=sys.stderr)
    return 1


if __name__ == "__main__":
    raise SystemExit(main())
运行脚本时,每次使用新的输出目录:
python reddit_scraper_v2.py --limit 10 --comments-per-post 0 --output-dir reddit_posts_run
python reddit_scraper_v2.py --query proxy --limit 10 --more-limit 2 --output-dir reddit_search_run
python reddit_scraper_v2.py --post-id POST_ID --more-limit 2 --output-dir reddit_thread_run
命令中的POST_ID需要替换为真实帖子ID。每次运行会生成reddit_posts.csv、reddit_comments.csv和run_metadata.json。先查看元数据中的状态,再检查CSV中的字段:
| 状态 | 含义 | 下一步 |
|---|---|---|
completed |
本次遍历结束,已导出至少一个帖子 | 检查帖子ID、原帖链接和评论关联;结果仍受采集上限约束 |
completed_empty |
遍历结束但没有返回帖子 | 检查版块、关键词和时间范围;不代表已经取得目标数据 |
stopped_at_time_budget |
在帖子处理边界发现时间预算已到,停止继续处理 | 将已有CSV作为部分结果,调整范围后使用新目录运行 |
failed_partial |
遇到异常,保存截至异常发生时已收集的数据 | 查看异常类型、HTTP状态和Retry-After,修复后重新运行 |
检查CSV时,确认帖子表和评论表的post_id可以对应,按t3_和t1_前缀解析parent_id,并核对created_at_utc包含+00:00时区信息。原帖链接可用于抽查数据来源。使用--comments-per-post 0时,评论CSV只有表头属于正常结果。
脚本默认读取10个帖子,每帖最多导出50条已加载评论;--more-limit默认为0,表示移除未展开的占位节点。设为2时,每帖最多展开2个占位节点,它不是总HTTP请求数。关键词模式固定搜索最近一个月,并按最新排序。
--max-seconds默认为120秒,是在进入每次帖子处理时检查的软时间预算。列表请求可能在检查前发生,正在进行的网络请求、客户端等待和评论展开也不会被它中断,因此总耗时可能超过设定值;最后一帖处理结束后也可能仍返回completed。单次请求另设20秒超时。需要严格限定进程总时长时,应由外部任务调度器控制,并单独处理强制停止后的结果保存。
脚本拒绝覆盖已有输出目录,重跑时请指定新的--output-dir。它不会自动续传或合并历史结果;合并多个批次时,可按post_id和comment_id去重。
什么时候适合用HTML解析
如果你的权限允许读取公开页面,且只需要页面上可见的少量字段,可以使用BeautifulSoup。但Reddit可能返回挑战页、登录页或动态组件,HTTP 200并不能证明拿到的是帖子内容。解析前要验证目标元素确实存在,并为选择器变化保留测试。
from bs4 import BeautifulSoup


def parse_visible_posts(html):
    soup = BeautifulSoup(html, "html.parser")
    rows = []
    for tag in soup.select("shreddit-post"):
        title = tag.get("post-title")
        permalink = tag.get("permalink")
        if title and permalink:
            rows.append({"title": title, "permalink": permalink})
    if not rows:
        raise ValueError("No post elements; inspect page or challenge response")
    return rows
shreddit-post选择器只是某一页面结构的示例,不保证长期不变。需要完整评论、稳定字段或大规模采集时,优先评估经过授权的Data API。
为Reddit采集脚本配置Rola-IP代理
代理适合解决“需要不同网络出口”这类网络路径问题,例如在获准的数据流程中比较不同地区的公开页面展示,或为任务提供可管理的出口。住宅代理更适合模拟普通用户网络环境;需要保持同一出口IP的会话,则应选择静态住宅代理。选型时需比较地区、稳定性、流量成本和目标平台规则,具体可参考住宅代理与网络爬虫代理页面。
本文导出脚本仅接受HTTP或HTTPS代理URL,不支持直接填写SOCKS5地址。这是示例脚本的接入范围,不代表Rola-IP全部产品的协议范围。请按照所用端口的实际协议填写http://或https://,不要仅因目标网站使用HTTPS就修改代理URL的协议。
先用IP回显服务诊断代理是否生效,再把代理配置传给完整导出脚本。用户名和密码中的特殊字符需要URL编码;IP白名单模式使用http://HOST:PORT形式,并确认当前出口IP已加入白名单。
$env:ROLA_PROXY_URL="http://USERNAME:PASSWORD@HOST:PORT"
下面使用第三方IP回显接口https://ipinfo.io/json作为示例,读取响应中的ip字段。也可以将IP_ECHO_URL设置为团队批准的HTTPS回显接口;若返回结构不同,需要同步调整JSON字段读取方式。接口限流或不可用时,应先检查回显服务,再判断代理连接是否故障。
该诊断只检查出口IP,不验证Reddit访问。未设置ROLA_PROXY_URL时,完整导出脚本会使用直连,并忽略继承来的代理环境变量。
import os
from ipaddress import ip_address

import requests

try:
    proxy = os.environ["ROLA_PROXY_URL"]
    echo_url = os.environ.get("IP_ECHO_URL", "https://ipinfo.io/json")
    if not echo_url.startswith("https://"):
        raise ValueError("IP_ECHO_URL must use HTTPS")
    with requests.Session() as session:
        session.trust_env = False
        response = session.get(
            echo_url,
            proxies={"http": proxy, "https": proxy},
            timeout=15,
        )
        response.raise_for_status()
        print(ip_address(response.json()["ip"]))
except (requests.RequestException, ValueError, KeyError) as exc:
    print("Proxy diagnostic failed:", type(exc).__name__)
    raise SystemExit(1)
需要了解代理地址、端口、认证和白名单配置,可查看Python代理接入。将取得的连接信息填入ROLA_PROXY_URL后,在同一终端运行前面的导出命令,脚本会把该配置传给PRAW使用的HTTP会话。
常见错误与排查顺序
| 现象 | 可能原因 | 首要检查 |
|---|---|---|
| 401 / 403 | 凭据无效、权限不足或访问被拒 | 检查Reddit应用、授权范围和账号状态 |
| 429 | 请求频率过高 | 停止任务并查看Retry-After,等待指定时间后再运行 |
| HTML请求返回HTTP200但没有帖子 | 收到挑战页、登录页或选择器已变化 | 检查实际HTML和目标元素;PRAW的空列表应检查版块、搜索条件和可见范围 |
| 503 / 超时 | 服务暂时不可用或网络路径异常 | 客户端重试后仍失败时,检查服务状态和网络路径,再缩小采集范围重跑 |
| 代理407 | 认证、白名单或端口配置错误 | 先用IP回显服务验证代理路线 |
| 作者字段为空 | 脚本默认不导出作者,或账号已删除 | 确认是否启用--include-authors,并接受不可用值为空 |
| 评论数量少于预期 | 导出上限、未展开MoreComments、内容删除或权限限制 |
检查--comments-per-post和--more-limit |
本文使用的prawcore4.0.0在API请求层对503等部分状态码、连接错误和读取超时提供有限重试,默认最多追加2次尝试。重试耗尽后,异常交给导出脚本记录。HTTP429会进入失败处理;脚本保存可用的Retry-After,由你等待后重新运行,不会自动反复启动整个采集任务。
PRAW还会依据API返回的配额信息进行请求节奏管理;ratelimit_seconds=0不代表关闭所有限速等待。排错时查看run_metadata.json中的异常类型和状态码即可,避免在共享日志中暴露凭据或代理URL。
从小批量采集开始
第一次运行时,先用--limit 1 --comments-per-post 0取得一条帖子,核对标题、原帖链接和UTC时间。再为目标帖子开启评论导出,确认parent_id能对应帖子或上一级评论,最后扩展到关键词搜索和多个帖子。
分析时保留采集时间和运行元数据,可以区分不同批次的得分、评论数量和内容变化。将帖子表与评论表分开保存,并用稳定的ID建立关联,后续就能围绕主题、时间或回复关系整理数据。