
如何用Python爬取需要登录的网站?从模拟登录到数据导出
2026年10月13日 · 教程 · 23 分钟阅读
用Python爬取需要登录的网站,关键是先完成认证,再沿用同一会话采集数据。 普通表单和服务端HTML页面优先用Requests;依赖JavaScript渲染或复杂交互的页面用Playwright。两种方法都要检查受保护页面和实际数据,不能只看HTTP 200。
浏览器里能看到商品,脚本却拿到登录表单或空表格,通常是登录状态没有保持,或商品尚未完成加载。下面用会员商品采集场景说明如何定位这两类问题。
本文以一个本地电商演示站为例,分别使用Requests和Playwright完成登录、商品采集与CSV导出,再说明如何为需要稳定网络出口的任务接入Rola IP。
先选工具:Requests还是Playwright?
先确认数据来自初始HTML还是后续接口,再按下表选择工具。除了数据来源,还要考虑登录过程是否需要浏览器交互。
| 页面或登录特征 | 建议方法 | 判断依据 |
|---|---|---|
| 表单提交账号密码,商品直接出现在HTML中 | Requests + BeautifulSoup | 能在Network的响应内容中找到商品名称或商品行 |
登录后通过XHR、fetch加载商品 |
Playwright;或调用已获授权的数据接口 | 初始HTML只有容器,数据出现在后续响应中 |
| 单点登录、多步交互或复杂前端状态 | Playwright | 登录过程依赖浏览器执行脚本、跳转或交互 |
| 存在MFA、验证码或额外权限要求 | 按官方流程完成验证,或使用官方API | 自动化工具不能替代账号授权 |
| 登录、翻页等步骤需要稳定出口IP | 在所选工具中配置粘性会话代理 | Cookie状态与网络出口需要分别保持 |
动态页面并不意味着只能用浏览器采集。如果已经确认某个JSON接口允许该账号访问,并且能够正确携带认证信息,也可以使用Requests获取数据。选择工具的依据是数据来源和认证方式,而不是页面看起来是否“动态”。
一、先看清登录流程,再写代码
在浏览器里确认这五项信息
打开开发者工具的 Network(网络) 面板,完成一次正常登录,记录以下内容:
- 登录请求的地址与方法,例如
POST /login。 - 提交格式是表单还是JSON,以及真实字段名,例如
email、password。 - CSRF Token来自哪里,是否存在隐藏字段、Cookie或请求头。
- 登录成功后的跳转地址,以及服务端设置或更新了哪些Cookie。
- 商品来自HTML还是后续接口,定位商品所需的CSS选择器是什么。
如果接口要求特定请求头,应按实际请求补齐,而不是随意复制一整套浏览器请求头。相关配置可参考Python Requests请求头使用指南。
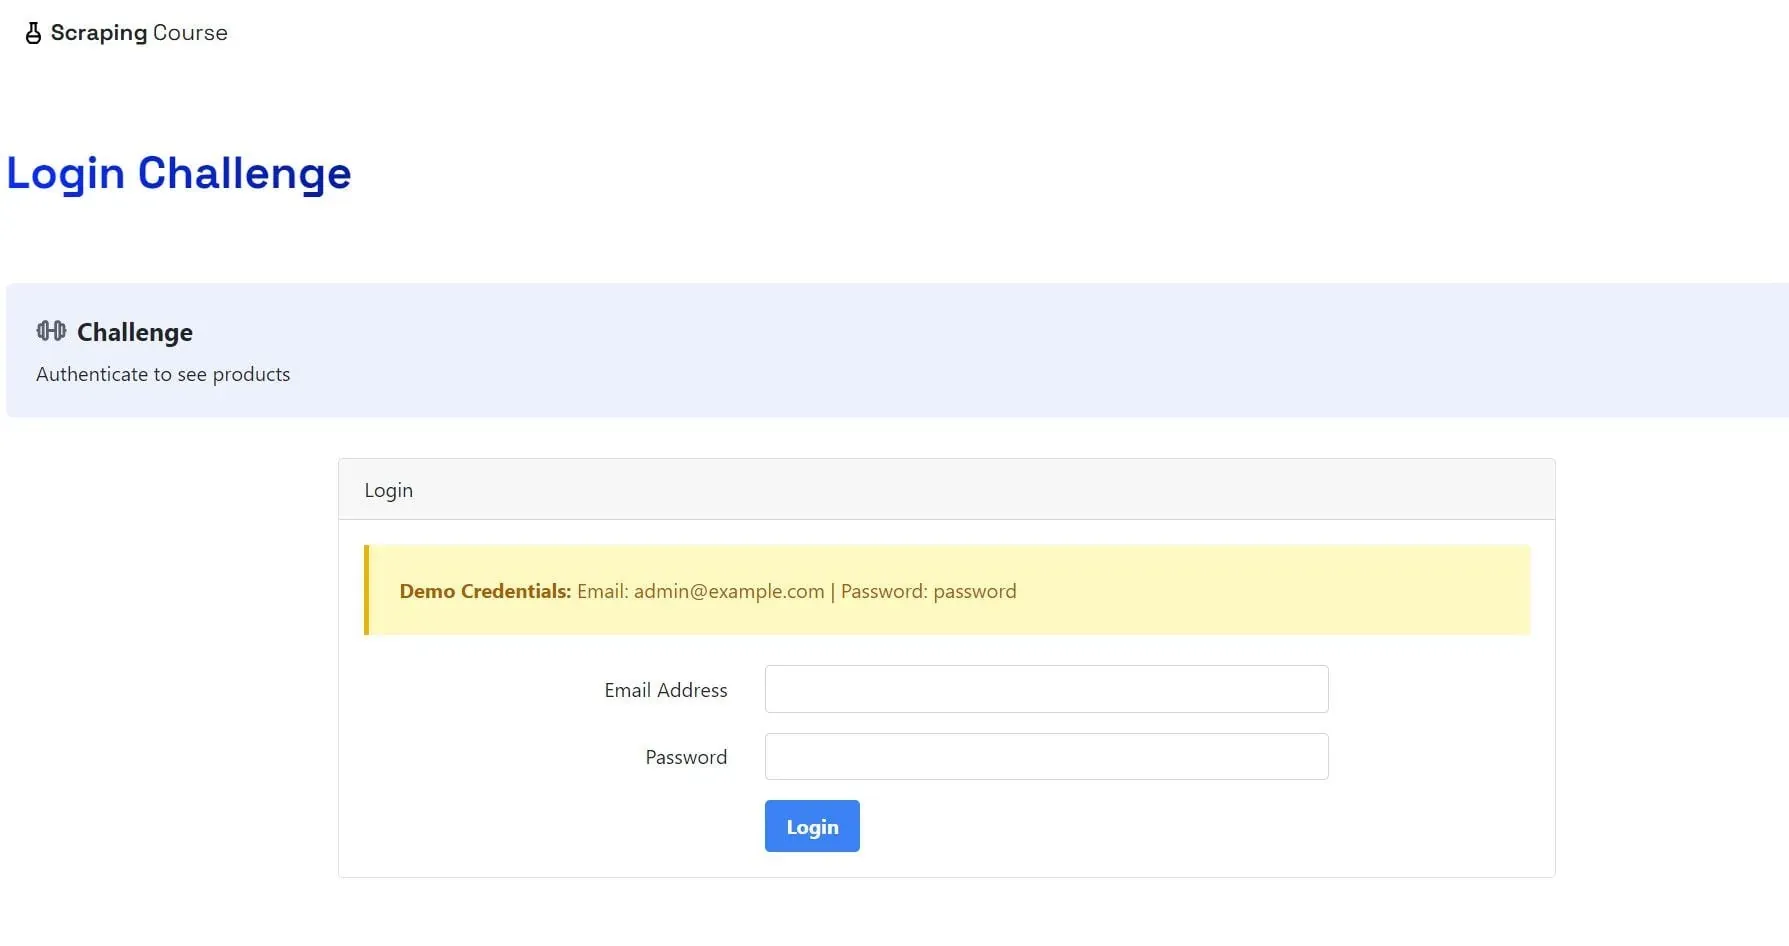
图1:Scraping Course登录练习页面,用于说明登录入口的常见形式。该站点与下文运行代码使用的本地演示站不同,账号及字段不能混用。
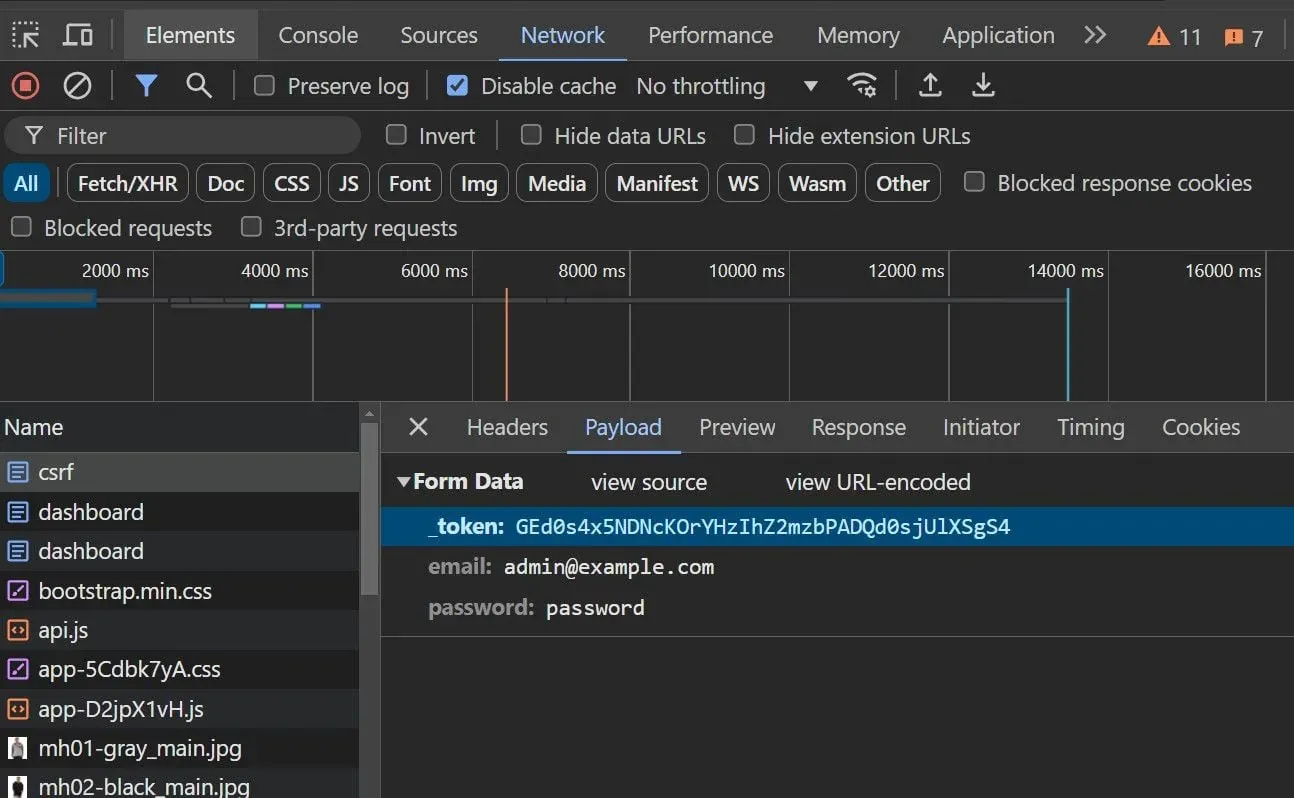
图2:此处的登录请求提交_token、email和password。字段名以目标站点的真实请求为准。
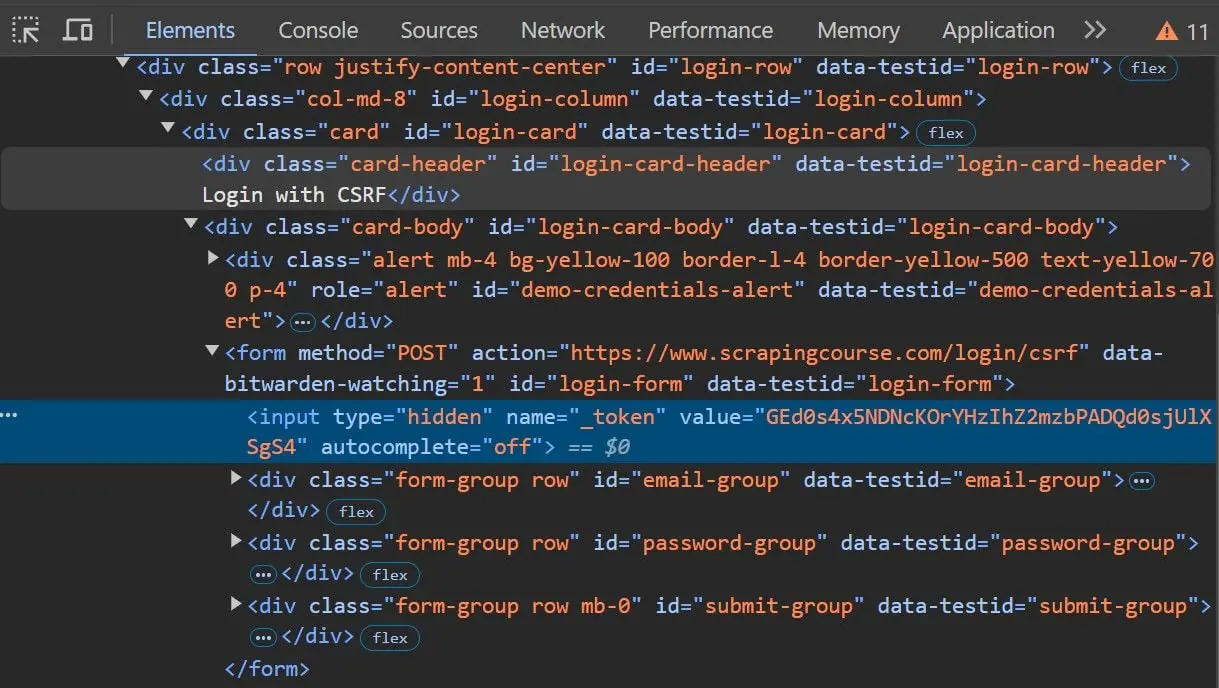
图3:参考页面使用名为_token的隐藏字段,并提交到/login/csrf;下文演示站使用的是csrf_token和/login。
Cookie、Session和CSRF Token各负责什么?
Cookie是浏览器或HTTP客户端随请求携带的一类状态数据,其中可能包含会话标识。服务端根据会话及权限判断能否返回受保护内容。存在Cookie不等于已经登录:很多网站在打开登录页时就会创建匿名会话。
requests.Session()是Requests提供的会话对象,能够保存和复用Cookie;Playwright则通过浏览器上下文(Browser Context)保存Cookie等浏览器状态。二者都不会让已过期的服务端会话自动恢复有效。
CSRF Token用于防御跨站请求伪造,常与当前会话关联。脚本需要从当前登录流程中读取它,再按站点要求提交;把昨天复制的Token写死在代码里,很容易导致验证失败。原理可参考 OWASP的CSRF防护说明。
二、准备本地演示环境
将文末附录中的完整代码保存为demo_site.py,在文件所在目录打开终端。演示站仅依赖Python标准库,提供以下访问路径。
验证环境(2026年10月13日): Windows、Python 3.14.4、Requests 2.33.1、Beautiful Soup 4.14.3、Playwright 1.58.0、Chromium 145.0.7632.6。两套采集脚本分别在本地演示站完成登录并导出3条商品,CSV均含表头及3行数据。验证使用本地直连、单任务串行执行;Requests超时为10秒,Playwright默认等待上限为15秒,未配置自动重试。
| 路径 | 用途 | 是否要求登录 |
|---|---|---|
/login |
登录表单和登录提交 | 否 |
/products |
服务端直接输出的商品表格 | 是 |
/dynamic |
由JavaScript加载的商品目录 | 是 |
/api/products |
返回商品JSON的接口 | 是 |
启动演示站,并保持该终端运行:
python demo_site.py --host 127.0.0.1 --port 8765
在浏览器中打开http://127.0.0.1:8765/login。演示账号为editor@example.test,密码为demo-pass-123;这些只是本地测试凭据。演示服务器仅用于学习,不应对公网开放。
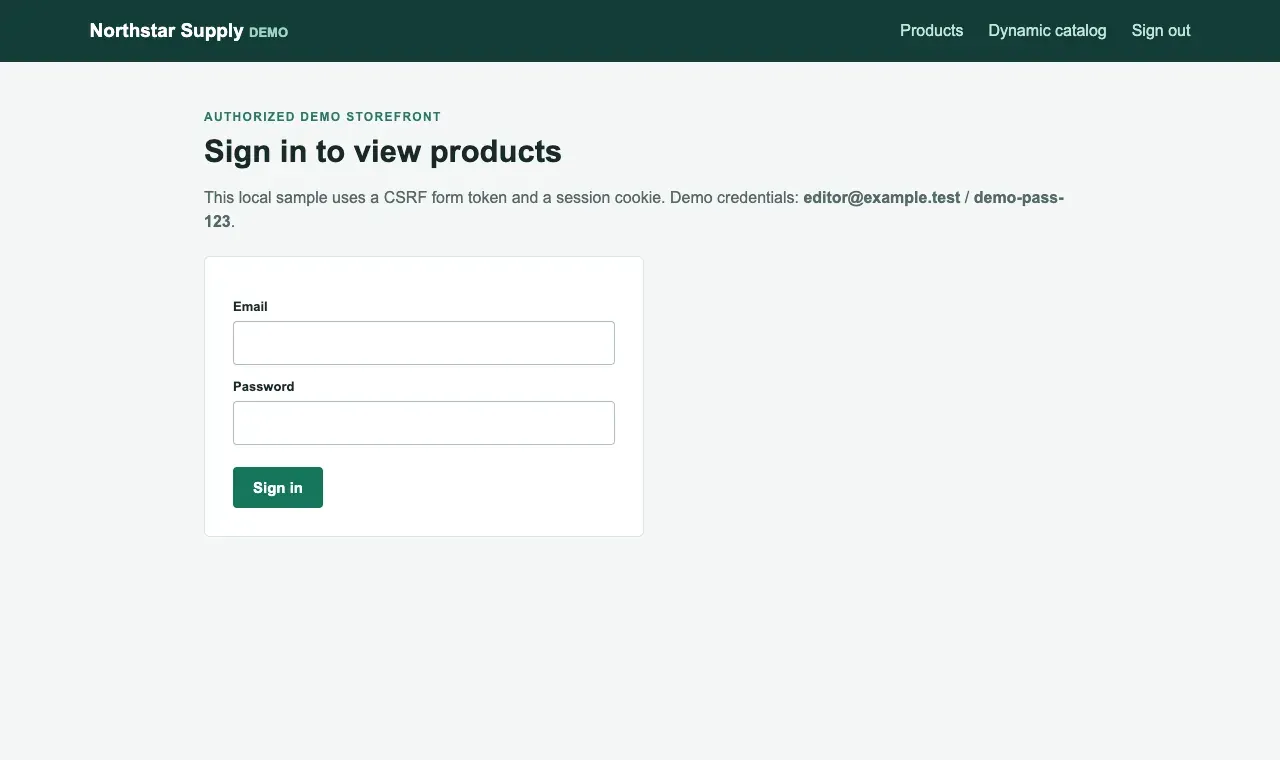
图4:本地演示站登录页,代码中的Email、Password和Sign in均对应这里的实际控件。
再打开一个终端,安装所需依赖:
python -m pip install requests==2.33.1 beautifulsoup4==4.14.3 playwright==1.58.0
python -m playwright install chromium
以下以Windows PowerShell为例配置环境变量。后续两个采集脚本均在此终端运行:
$env:DEMO_BASE_URL = "http://127.0.0.1:8765"
$env:DEMO_USERNAME = "editor@example.test"
$env:DEMO_PASSWORD = "demo-pass-123"
macOS或Linux可使用export DEMO_BASE_URL="http://127.0.0.1:8765",另外两个变量同样通过export设置。更换为真实网站时,除了地址和账号,还需要重新确认登录路径、表单字段、Cookie名称和商品选择器。
三、用Requests模拟登录并爬取商品
正确顺序:获取表单 → 提交登录 → 验证受保护页面
Requests方案的重点是:三个步骤都使用同一个Session。
先访问/login,让客户端接收初始Cookie,并从响应里解析当前csrf_token;再提交账号密码和Token;最后访问/products,确认仍停留在商品页,而且确实能找到商品行。
本地演示站在打开登录页时就会设置demo_session,因此检查它是否存在,只能确认Cookie已保存。真正的登录验证还必须检查受保护页面和实际数据。
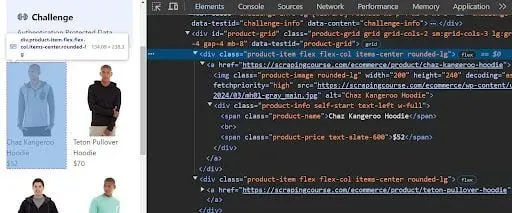
图5:采集前先确认商品结构。本例使用tr.product定位商品行,再提取.sku、.name和.price。
完整代码:登录、提取数据并保存CSV
将下面的代码保存为requests_login.py。这是一段完整脚本,无须拼接多个代码片段:
import csv
import os
from pathlib import Path
from urllib.parse import urljoin, urlparse

import requests
from bs4 import BeautifulSoup

BASE = os.environ["DEMO_BASE_URL"].rstrip("/") + "/"
USER = os.environ["DEMO_USERNAME"]
PASSWORD = os.environ["DEMO_PASSWORD"]
OUTPUT = Path(os.getenv("OUTPUT_CSV", "products_requests.csv"))


def collect():
    with requests.Session() as session:
        session.headers.update({"User-Agent": "AuthorizedDemoResearch/1.0"})
        login_page = session.get(urljoin(BASE, "login"), timeout=10)
        login_page.raise_for_status()
        soup = BeautifulSoup(login_page.text, "html.parser")
        token = soup.select_one('input[name="csrf_token"]')
        if token is None or not token.get("value"):
            raise RuntimeError("未找到当前登录表单的 CSRF Token")

        login = session.post(
            urljoin(BASE, "login"),
            data={
                "csrf_token": token["value"],
                "email": USER,
                "password": PASSWORD,
            },
            timeout=10,
        )
        login.raise_for_status()
        if "demo_session" not in session.cookies:
            raise RuntimeError("未保存演示站的会话 Cookie")

        protected = session.get(urljoin(BASE, "products"), timeout=10)
        protected.raise_for_status()
        if urlparse(protected.url).path.rstrip("/") != "/products":
            raise RuntimeError("未进入受保护商品页,请检查登录结果")

        soup = BeautifulSoup(protected.text, "html.parser")
        products = []
        for row in soup.select("tr.product"):
            item = {}
            for key in ("sku", "name", "price"):
                cell = row.select_one("." + key)
                if cell is None:
                    raise RuntimeError(f"商品行缺少 {key} 字段")
                item[key] = cell.get_text(strip=True)
            products.append(item)
        if not products:
            raise RuntimeError("未找到商品,请检查登录状态和选择器")
        return products, sorted(session.cookies.keys())


def main():
    products, cookie_names = collect()
    with OUTPUT.open("w", newline="", encoding="utf-8-sig") as handle:
        writer = csv.DictWriter(handle, fieldnames=("sku", "name", "price"))
        writer.writeheader()
        writer.writerows(products)
    print("Authenticated page: /products")
    print("Cookie names:", ", ".join(cookie_names))
    print(f"Exported {len(products)} product rows to {OUTPUT}")
    for item in products:
        print(item["sku"], item["name"], item["price"])


if __name__ == "__main__":
    main()
运行脚本:
python requests_login.py
正常情况下,脚本会生成products_requests.csv,包含演示站的3条商品记录。utf-8-sig编码便于常见表格软件识别UTF-8中文;它并不负责清洗价格或转换币种。
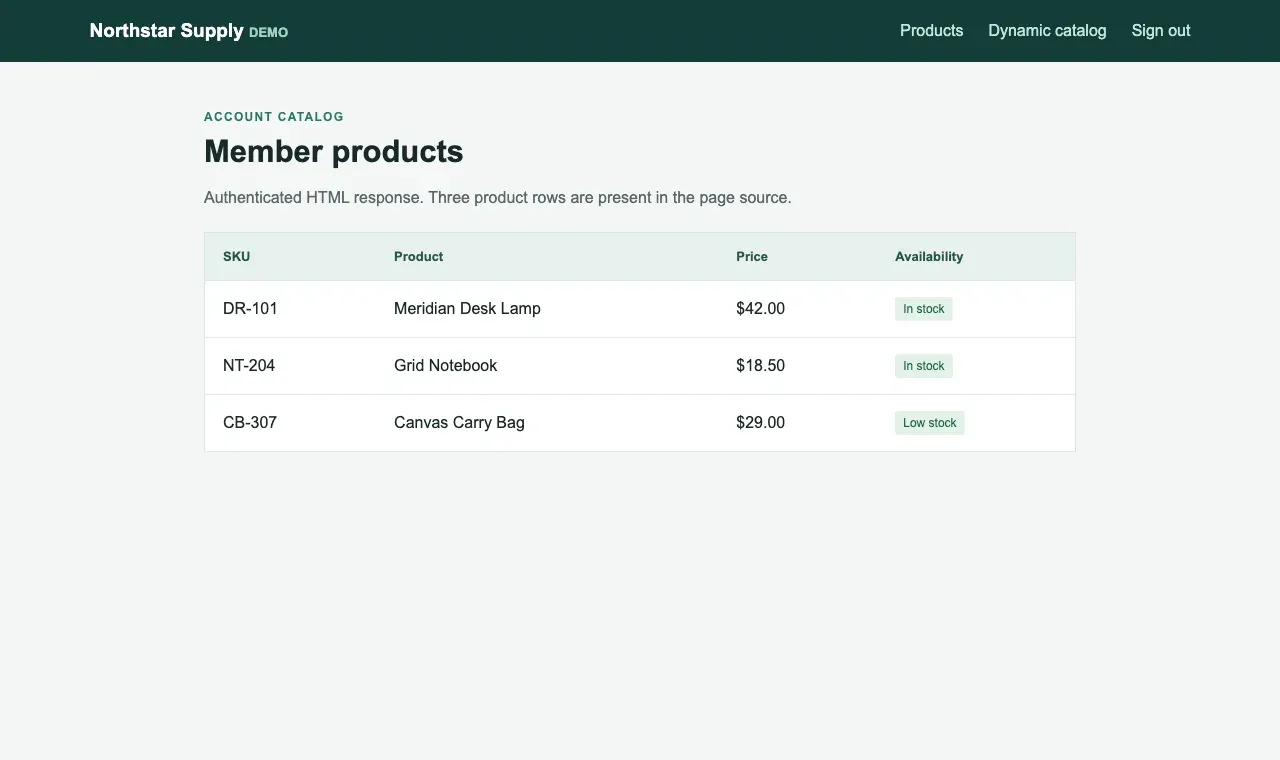
图6:登录后的商品页。三条商品记录直接包含在HTML中,适合Requests解析。
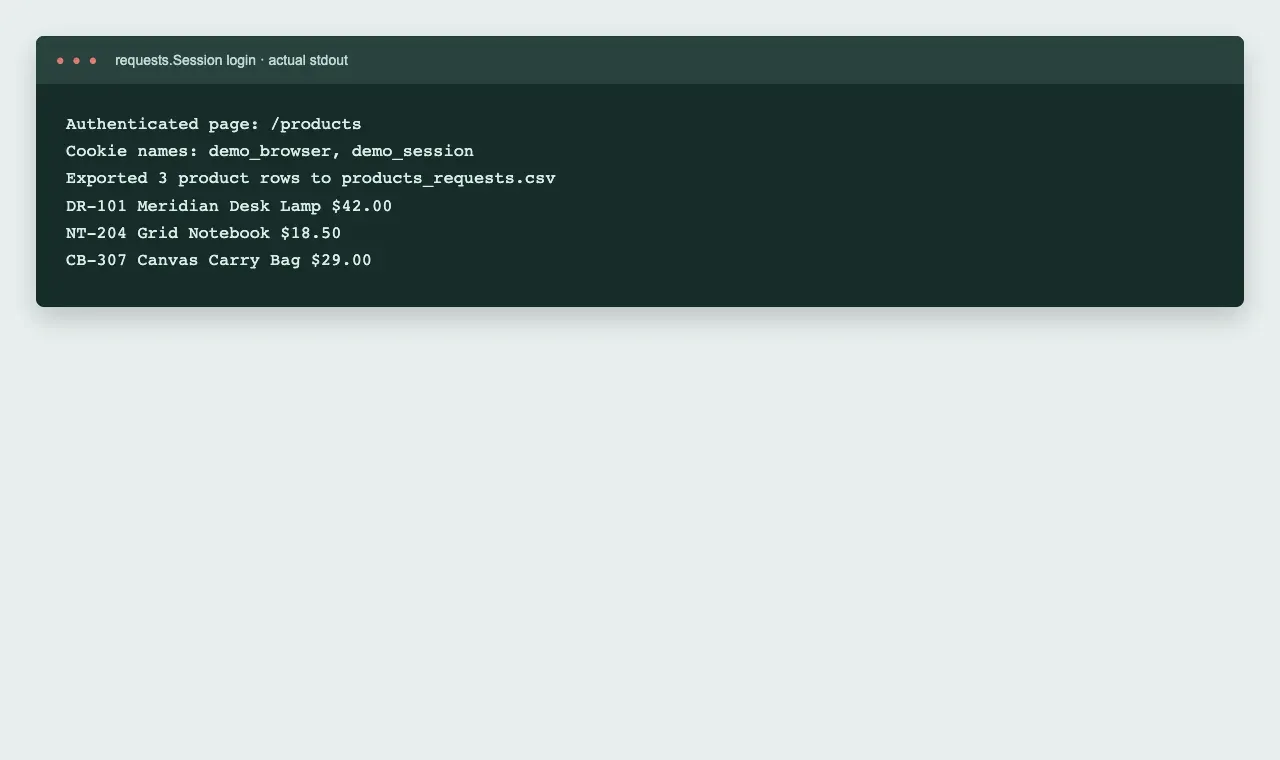
图7:运行输出展示:受保护页面、Cookie名称及三条商品记录与上述脚本的默认输出一致。Cookie名称用于排查状态,不包含Cookie值。
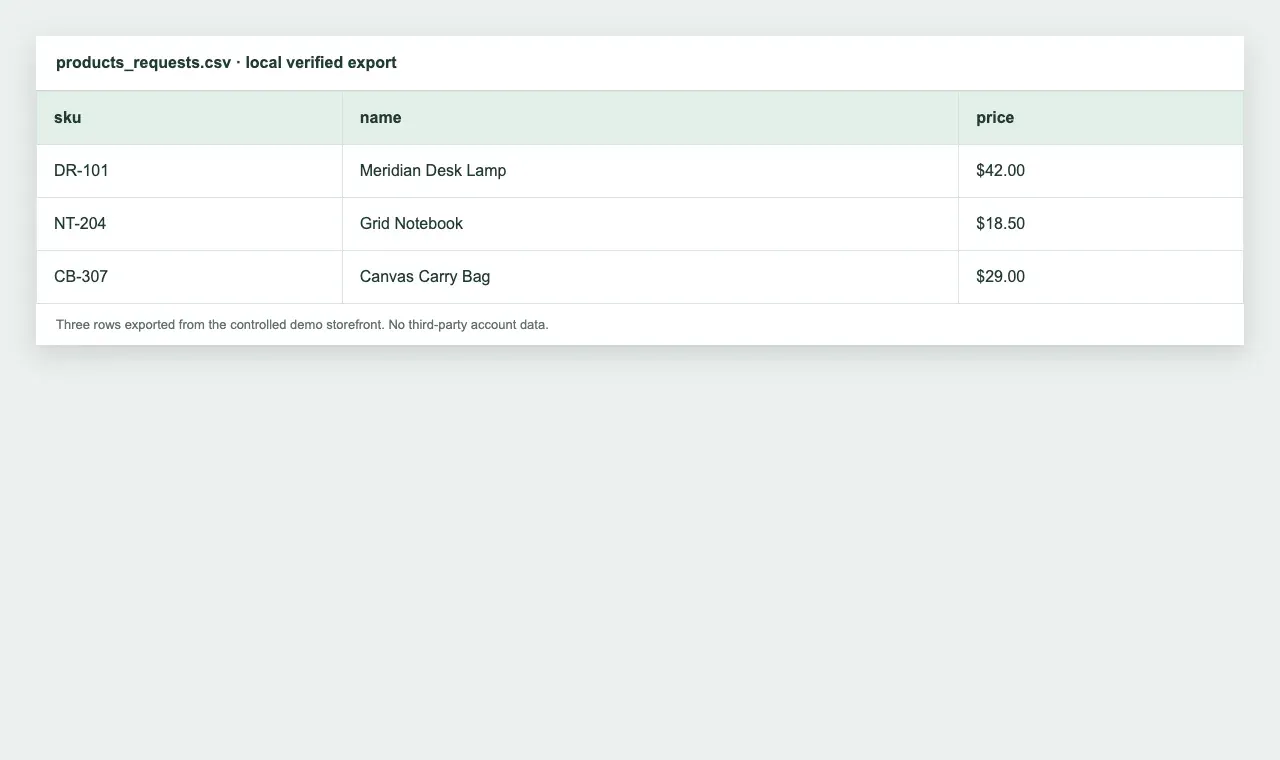
图8:CSV中的SKU、名称与价格应和页面逐项对应。仅生成文件。
四、用Playwright爬取登录后的动态网页
如果Requests获取的HTML只有一个空表格,而浏览器稍后才显示商品,通常说明数据由JavaScript加载。BeautifulSoup只能解析拿到的HTML,不会替你执行fetch或渲染页面。
Playwright可以启动浏览器、填写表单,并在同一个浏览器上下文中继续访问会员页面。本例的/dynamic会请求受保护的/api/products,插入商品行后,把表格的data-state改为ready。
等待明确的数据就绪状态,比固定等待几秒更可靠。 固定sleep(3)可能在网速慢时过早采集,也可能在页面早已完成时白白等待。
完整代码:等待商品渲染后导出
将下面的代码保存为playwright_login.py,沿用前面配置的环境变量:
import csv
import os
from pathlib import Path
from urllib.parse import urlparse

from playwright.sync_api import sync_playwright

BASE = os.environ["DEMO_BASE_URL"].rstrip("/")
USER = os.environ["DEMO_USERNAME"]
PASSWORD = os.environ["DEMO_PASSWORD"]
OUTPUT = Path(os.getenv("OUTPUT_CSV", "products_playwright.csv"))


def collect():
    with sync_playwright() as playwright:
        browser = playwright.chromium.launch(headless=True)
        try:
            context = browser.new_context()
            page = context.new_page()
            page.set_default_timeout(15000)
            page.goto(BASE + "/login", wait_until="domcontentloaded")
            page.get_by_label("Email").fill(USER)
            page.get_by_label("Password").fill(PASSWORD)
            page.get_by_role("button", name="Sign in").click()
            page.wait_for_url(BASE + "/products")
            page.locator("tr.product").first.wait_for()

            page.goto(BASE + "/dynamic", wait_until="domcontentloaded")
            if urlparse(page.url).path.rstrip("/") != "/dynamic":
                raise RuntimeError("动态商品页未通过登录验证")
            rows = page.locator('#catalog[data-state="ready"] tr.product')
            rows.first.wait_for()
            products = rows.evaluate_all("""rows => rows.map(row => ({
                sku: row.querySelector('.sku').textContent.trim(),
                name: row.querySelector('.name').textContent.trim(),
                price: row.querySelector('.price').textContent.trim()
            }))""")
            if not products:
                raise RuntimeError("页面未渲染出商品数据")
            return products
        finally:
            browser.close()


def main():
    products = collect()
    with OUTPUT.open("w", newline="", encoding="utf-8-sig") as handle:
        writer = csv.DictWriter(handle, fieldnames=("sku", "name", "price"))
        writer.writeheader()
        writer.writerows(products)
    print("Authenticated dynamic page: /dynamic")
    print(f"Exported {len(products)} JavaScript-rendered rows to {OUTPUT}")
    for item in products:
        print(item["sku"], item["name"], item["price"])


if __name__ == "__main__":
    main()
运行:
python playwright_login.py
脚本会生成products_playwright.csv。如果出现超时,先把headless=True改为headless=False观察实际页面,判断是登录失败、选择器变化,还是数据接口没有成功返回。
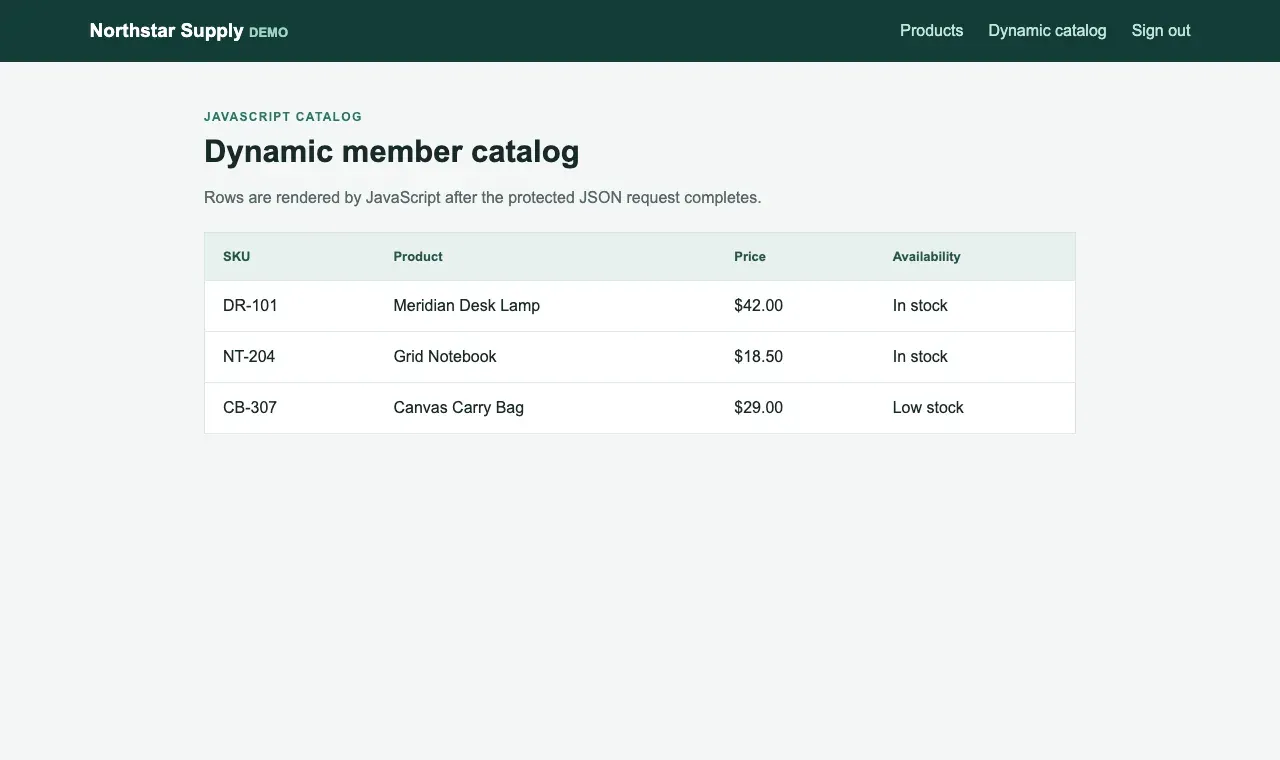
图9:动态商品页的三条记录来自登录后的JSON请求,不能只靠初始页面HTML判断数据是否存在。
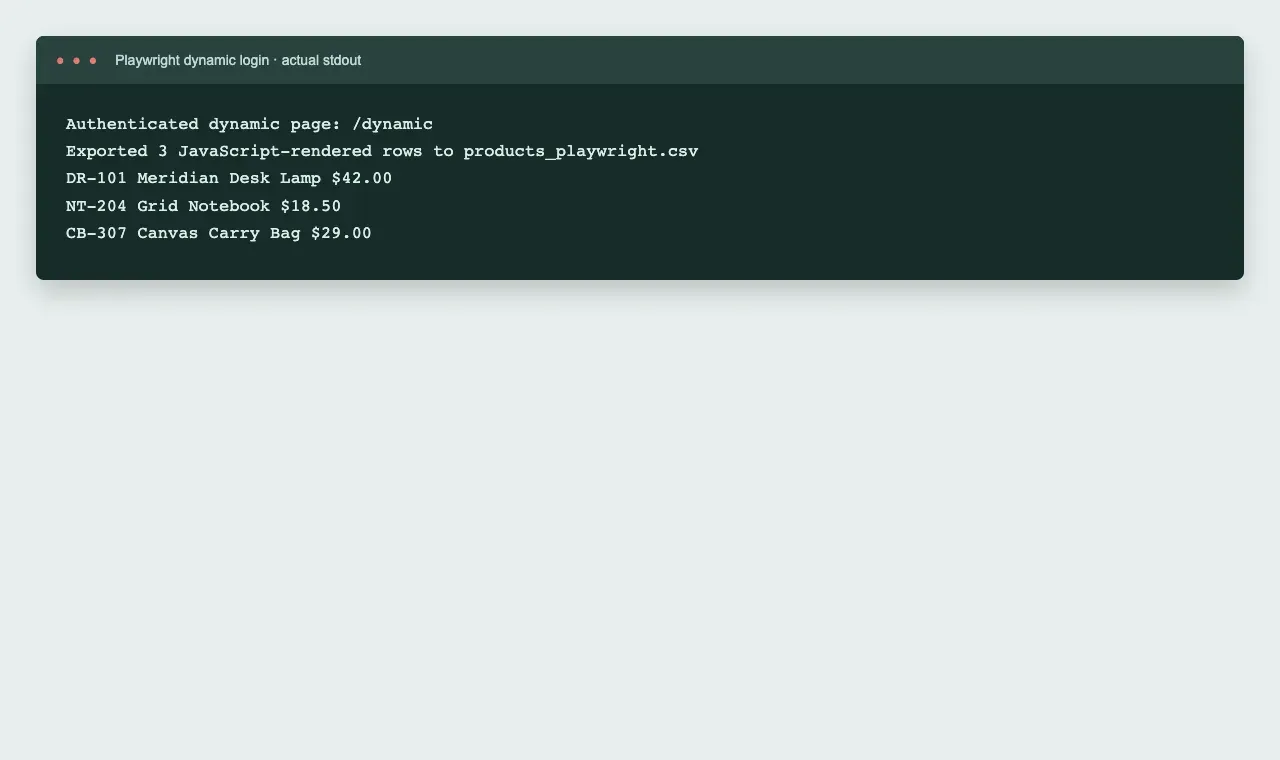
图10:运行输出展示:动态页面路径和三条商品记录与上述脚本的默认输出一致。应同时核对记录数量与导出内容。
对于需要多次运行的任务,可以在授权登录后使用Playwright的storage_state保存可复用状态,具体用法见 Playwright认证文档。状态文件可能包含敏感Cookie或Token,不能上传到公开仓库;能否恢复登录还取决于站点的认证机制和会话是否过期。
五、保持登录状态:Cookie与出口IP要分开管理
登录采集中的“会话稳定”至少包含两层:客户端持续持有有效认证信息,以及网络出口符合目标站点的访问要求。它们不能互相替代。
| 需要保持的状态 | Requests做法 | Playwright做法 | 常见问题 |
|---|---|---|---|
| Cookie与登录状态 | 复用同一个Session |
复用同一个Browser Context | 每翻一页就新建客户端,导致认证信息丢失 |
| CSRF Token | 重新登录前读取当前表单 | 通过实际表单流程提交 | 写死Token,或把其他会话的Token拿来使用 |
| 出口IP | 在整个任务中使用一致的代理会话参数 | 浏览器使用一致的代理身份 | 登录中途换IP,引发额外验证或会话异常 |
| 数据就绪状态 | 检查响应内容和字段 | 等待具体元素或完成标记 | 页面还没加载完就导出 |
| 访问频率 | 设置超时、间隔与有限重试 | 控制并发和页面操作频率 | 遇到限流后持续重试 |
粘性会话代理用于尽量在指定时间内保持相同出口IP,不负责保存登录Cookie,也不保证账号永远在线。 实际出口还会受代理网络可用性等因素影响。
并非所有登录采集都需要代理。本地演示和已有稳定直连环境可以先完成采集流程;确实需要指定出口或保持代理会话时,再配置代理。评估实际业务中的网络需求,可参考Rola IP的网络爬虫代理方案。
六、Rola IP粘性会话代理配置示例
先核对账号参数,再接入脚本
以下展示动态住宅代理的接入方式。参数规则已于2026年10月13日核对官方文档。配置后,请使用实际账号检查代理连通性和出口IP,再接入目标站点。
以动态住宅网络的账号格式为例,会话标识位于基础账号名后的下划线之后:
account_login001-country-us-sessiontime-10
这里的login001是会话标识,country-us表示美国出口,sessiontime-10表示请求保持10分钟的会话时长。会话时长参数范围为1—120分钟;不同网络类型的账号标记、地区定向能力可能不同,使用前请核对当前的Rola IP代理参数文档及控制台配置。
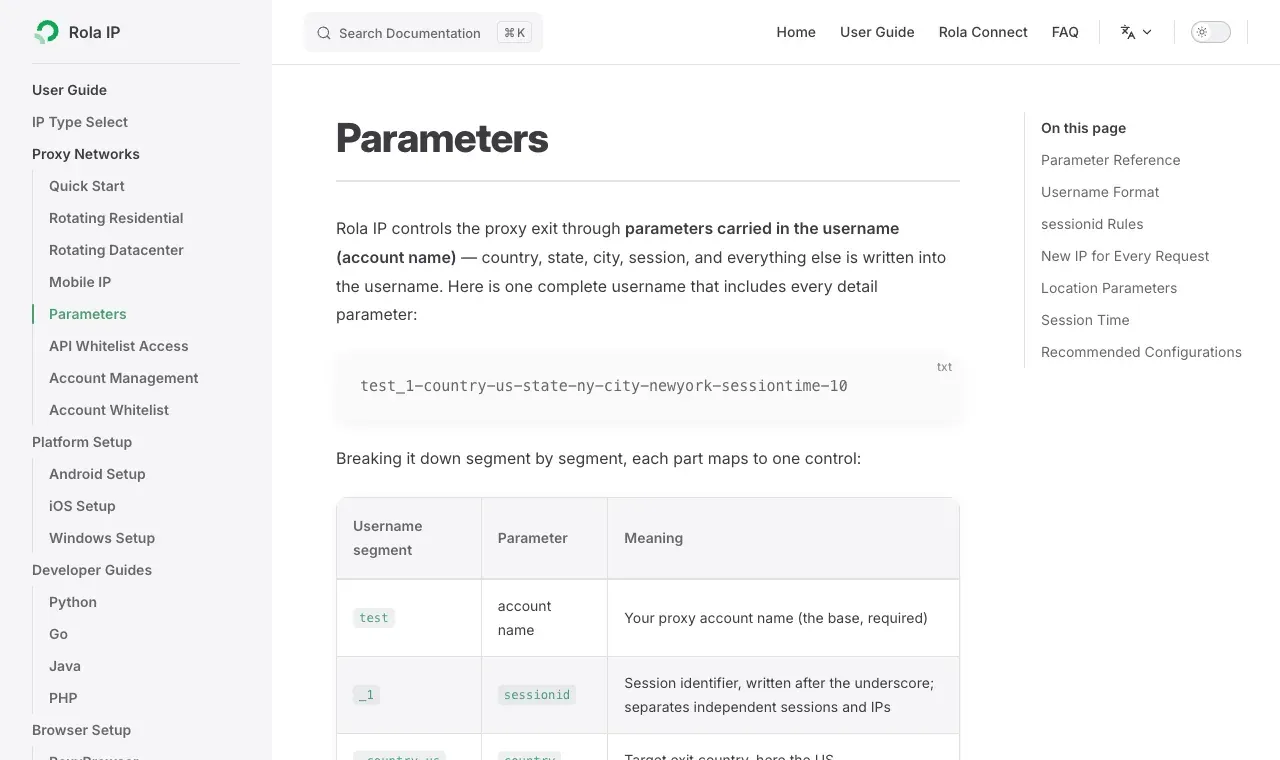
图11:代理参数通过用户名携带。复制配置时应区分基础账号名与已经追加参数的完整用户名。
下面示例使用HTTP代理网关gate.rola.vip:1000。网关与端口以账号控制台为准;该用户名拼接示例不应直接套用到所有网络类型。
将以下代码保存为rola_proxy.py,与采集脚本放在同一个目录:
import os
from urllib.parse import quote


def proxy_settings():
    # 使用基础账号名,不要重复追加已有的会话或地区后缀。
    account = os.environ["ROLA_PROXY_USER"]
    password = os.environ["ROLA_PROXY_PASSWORD"]
    session_id = os.getenv("ROLA_SESSION_ID", "login001")
    country = os.getenv("ROLA_COUNTRY", "us").lower()
    minutes = int(os.getenv("ROLA_SESSION_MINUTES", "10"))
    gateway = os.getenv("ROLA_PROXY_GATEWAY", "gate.rola.vip:1000")
    if not 1 <= minutes <= 120:
        raise ValueError("会话时长必须在 1—120 分钟之间")

    username = f"{account}_{session_id}-country-{country}-sessiontime-{minutes}"
    url = (
        f"http://{quote(username, safe='')}:{quote(password, safe='')}"
        f"@{gateway}"
    )
    return (
        {"http": url, "https": url},
        {"server": "http://" + gateway,
         "username": username, "password": password},
    )
先在环境变量中设置ROLA_PROXY_USER和ROLA_PROXY_PASSWORD。其他变量可按任务需要设置;同一任务中不要每次请求都生成新的ROLA_SESSION_ID。
Requests的接入位置
在脚本顶部加入导入语句,然后在collect()中创建Session后、第一次访问登录页之前设置代理:
from rola_proxy import proxy_settings

# 以下两行放在 with requests.Session() as session: 内部。
requests_proxies, _ = proxy_settings()
session.proxies.update(requests_proxies)
后续获取登录页、提交表单、翻页和详情页访问,都沿用这个Session。若运行环境已经配置HTTP_PROXY、HTTPS_PROXY等变量,也要检查它们是否影响了实际路由。库的接入方式可参考Python代理接入指南;会话用户名沿用上文参数页的account_sessionid格式,不混用接入页部分示例中的-sid-写法。
Playwright的接入位置
在Playwright脚本顶部导入proxy_settings,并在with sync_playwright() as playwright:内,用下面两行替换原来的浏览器启动语句:
_, browser_proxy = proxy_settings()
browser = playwright.chromium.launch(headless=True, proxy=browser_proxy)
代理配置适用于可由该代理访问的授权目标站点,不要直接用远程代理访问本机的127.0.0.1演示地址。接入真实目标前,可以通过可信的IP查询服务检查实际出口,并在任务开始和结束时核对它是否保持一致。
七、登录采集失败时,按现象定位问题
HTTP 200不代表登录成功
登录失败后,网站可能仍返回状态码200,也可能先重定向,最后展示一个正常返回200的登录页。因此,应该一起检查最终URL、登录表单是否仍存在、服务端错误提示和预期数据,而不只是调用raise_for_status()。
| 现象 | 优先检查 | 处理方式 |
|---|---|---|
| POST返回200,页面仍是登录框 | 字段、Token、账号、最终URL | 重新核对登录请求,读取当前会话的Token |
| 已有Cookie,仍被跳回登录页 | Cookie是否仅对应匿名会话、会话是否过期 | 验证受保护页面,必要时按正常流程重新登录 |
| 登录后拿不到商品 | 数据来源、选择器、账号权限 | 区分动态加载、合法空结果和实际失败 |
| 403 | CSRF、访问权限和站点访问策略 | 检查授权与请求条件,不盲目重试 |
| 407 | 代理账号密码、网关、参数格式 | 修正代理认证;这不是目标站账号登录失败 |
| 429 | 请求频率、并发、Retry-After |
按服务端要求等待并降低频率 |
| Playwright等待超时 | 页面跳转、接口响应、定位器 | 打开有界面模式查看实际流程 |
超时、重试和限流怎么处理?
Requests应显式设置timeout,避免请求长时间挂起。但timeout=10并不等于整个采集任务最多运行10秒,连接和读取超时也有各自含义,可参考Python Requests超时设置。
对临时故障,只为适合重试的请求设置有限次数的退避。例如GET请求出现临时服务端错误时,可以逐步增加间隔;提交账号密码的POST不应盲目重放,以免触发账号锁定或重复操作。
遇到429时,优先读取Retry-After。它可能是等待秒数,也可能是HTTP日期。如果服务器要求等待120秒,就不能把等待时间截断为30秒后继续请求。 如果任务无法等这么久,应暂停任务或留待后续执行。
翻页、详情页和导出还需要注意什么?
先验证第一页,再沿用相同会话访问真实的下一页链接或接口游标。动态页面翻页后,应等待页面编号、数据响应或商品集合更新;仅等待旧的.product元素存在,可能重复采集上一页。
长期运行时,建议保存SKU、商品来源URL和采集时间,并按SKU或业务主键去重。价格字段需要区分金额与币种;只有确认数据完整后再写入最终结果。正式业务中合法的空列表应单独处理,本文“没有商品即报错”的判断仅适用于固定包含三件商品的演示站。
附录:本地演示站完整代码
将下面代码保存为demo_site.py,再按第二节启动服务。商品与账号均为测试数据;服务默认仅监听本机。
"""Small local storefront used by the login-scraping tutorial.

This server uses only Python's standard library. It is intentionally local and
contains synthetic products and credentials; do not expose it to the internet.
"""

import argparse
import html
import http.cookies
import json
import secrets
import urllib.parse
from http import HTTPStatus
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer


DEMO_USER = "editor@example.test"
DEMO_PASSWORD = "demo-pass-123"
PRODUCTS = [
    {"sku": "DR-101", "name": "Meridian Desk Lamp", "price": "$42.00"},
    {"sku": "NT-204", "name": "Grid Notebook", "price": "$18.50"},
    {"sku": "CB-307", "name": "Canvas Carry Bag", "price": "$29.00"},
]
SESSIONS = {}


def cookie_value(headers, name):
    parsed = http.cookies.SimpleCookie()
    parsed.load(headers.get("Cookie", ""))
    morsel = parsed.get(name)
    return morsel.value if morsel else None


class DemoHandler(BaseHTTPRequestHandler):
    server_version = "LoginScrapeDemo/1.0"

    def send_html(self, body, status=HTTPStatus.OK, extra_headers=None):
        payload = body.encode("utf-8")
        self.send_response(status)
        self.send_header("Content-Type", "text/html; charset=utf-8")
        self.send_header("Content-Length", str(len(payload)))
        for key, value in (extra_headers or {}).items():
            if isinstance(value, (list, tuple)):
                for item in value:
                    self.send_header(key, item)
            else:
                self.send_header(key, value)
        self.end_headers()
        self.wfile.write(payload)

    def send_json(self, value, status=HTTPStatus.OK):
        payload = json.dumps(value).encode("utf-8")
        self.send_response(status)
        self.send_header("Content-Type", "application/json; charset=utf-8")
        self.send_header("Content-Length", str(len(payload)))
        self.end_headers()
        self.wfile.write(payload)

    def session(self):
        sid = cookie_value(self.headers, "demo_session")
        return sid, SESSIONS.get(sid)

    def require_auth(self):
        sid, state = self.session()
        if not state or not state.get("authenticated"):
            self.send_response(HTTPStatus.FOUND)
            self.send_header("Location", "/login")
            self.end_headers()
            return None
        return sid, state

    def do_GET(self):  # noqa: N802 - required by BaseHTTPRequestHandler
        path = urllib.parse.urlparse(self.path).path
        if path == "/login":
            sid = cookie_value(self.headers, "demo_session") or secrets.token_urlsafe(18)
            token = secrets.token_urlsafe(24)
            SESSIONS[sid] = {"authenticated": False, "csrf_token": token}
            body = f"""<!doctype html>
<html><head><meta charset='utf-8'><title>Demo sign in</title></head>
<body><h1>Demo storefront sign in</h1>
<form method='post' action='/login'>
<label for='email'>Email</label><input id='email' name='email' type='email'><br>
<label for='password'>Password</label><input id='password' name='password' type='password'><br>
<input type='hidden' name='csrf_token' value='{html.escape(token)}'>
<button type='submit'>Sign in</button>
</form></body></html>"""
            self.send_html(
                body,
                extra_headers={
                    "Set-Cookie": [
                        f"demo_session={sid}; Path=/; HttpOnly",
                        "demo_browser=1; Path=/; HttpOnly",
                    ]
                },
            )
            return

        if path == "/products":
            if not self.require_auth():
                return
            rows = "".join(
                f"<tr class='product'><td class='sku'>{html.escape(p['sku'])}</td>"
                f"<td class='name'>{html.escape(p['name'])}</td>"
                f"<td class='price'>{html.escape(p['price'])}</td></tr>"
                for p in PRODUCTS
            )
            self.send_html(
                "<!doctype html><html><body><h1>Products</h1>"
                f"<table><thead><tr><th>SKU</th><th>Name</th><th>Price</th></tr></thead>"
                f"<tbody>{rows}</tbody></table></body></html>"
            )
            return

        if path == "/dynamic":
            if not self.require_auth():
                return
            body = """<!doctype html><html><body><h1>Dynamic catalog</h1>
<table id='catalog' data-state='loading'><tbody></tbody></table>
<script>
fetch('/api/products').then(r => r.json()).then(products => {
  const catalog = document.querySelector('#catalog');
  catalog.querySelector('tbody').innerHTML = products.map(p =>
    `<tr class="product"><td class="sku">${p.sku}</td><td class="name">${p.name}</td><td class="price">${p.price}</td></tr>`
  ).join('');
  catalog.dataset.state = 'ready';
});
</script></body></html>"""
            self.send_html(body)
            return

        if path == "/api/products":
            sid, state = self.session()
            if not state or not state.get("authenticated"):
                self.send_json({"error": "authentication required"}, status=HTTPStatus.UNAUTHORIZED)
                return
            self.send_json(PRODUCTS)
            return

        self.send_error(HTTPStatus.NOT_FOUND)

    def do_POST(self):  # noqa: N802 - required by BaseHTTPRequestHandler
        path = urllib.parse.urlparse(self.path).path
        if path != "/login":
            self.send_error(HTTPStatus.NOT_FOUND)
            return
        sid, state = self.session()
        if not sid or not state:
            self.send_error(HTTPStatus.FORBIDDEN, "Open /login first")
            return
        length = int(self.headers.get("Content-Length", "0"))
        values = urllib.parse.parse_qs(self.rfile.read(length).decode("utf-8"))
        token = values.get("csrf_token", [""])[0]
        email = values.get("email", [""])[0]
        password = values.get("password", [""])[0]
        if token != state["csrf_token"]:
            self.send_error(HTTPStatus.FORBIDDEN, "Invalid CSRF token")
            return
        if email != DEMO_USER or password != DEMO_PASSWORD:
            self.send_error(HTTPStatus.UNAUTHORIZED, "Invalid demo credentials")
            return
        state["authenticated"] = True
        self.send_response(HTTPStatus.FOUND)
        self.send_header("Location", "/products")
        self.end_headers()


def main():
    parser = argparse.ArgumentParser(description="Run the local login-scraping demo")
    parser.add_argument("--host", default="127.0.0.1")
    parser.add_argument("--port", type=int, default=8765)
    args = parser.parse_args()
    server = ThreadingHTTPServer((args.host, args.port), DemoHandler)
    print(f"Demo site listening at http://{args.host}:{args.port}/login")
    print(f"Demo credentials: {DEMO_USER} / {DEMO_PASSWORD}")
    try:
        server.serve_forever()
    except KeyboardInterrupt:
        print("\nStopping demo site")
    finally:
        server.server_close()


if __name__ == "__main__":
    main()