
AliExpressのスクレイピング入門|Pythonで保存済みHTMLを解析してCSVに出力
2026年10月22日 · ガイド · 約20分で読める
AliExpressの商品情報は、保存済みHTMLに対象商品のJSON-LDが含まれていれば、Pythonで解析してCSVに出力できます。価格比較に使う際は、価格を取り出す前に「対象商品のデータかどうか」を確認することが大切です。
本記事では、保存済みHTMLに含まれる構造化データのProductをPythonで解析し、商品URL・商品名・表示価格・通貨を検証してCSVに出力する方法を紹介します。完全な実装コードと、実際の販売商品を使わない8件のサンプルを掲載しているため、まずは通信せずに動作を確認できます。
押さえておきたい点は、次の3つです。
Productのurlまたは@idから対象商品を照合します。販売者が付けるSKUは、AliExpressの商品IDとは区別します。- 単一の
Offerに含まれる、有限かつ0以上の価格を採用します。評価の欠損は空欄にし、在庫不明と在庫切れを分けます。 - 最初にローカルのサンプルで確認し、その後、処理する権限のあるHTMLに適用します。オンライン取得の手順は後半に掲載しています。
1. 保存済みHTMLの解析に必要なPython環境とコード
この実装は、商品詳細ページのHTMLからJSON-LDを読み取り、条件に合う商品を1件だけ抽出します。JavaScriptの実行や検索結果の巡回は行いません。
作業用フォルダーを用意し、以下のコードをarticle_ali_scraper.pyという名前で保存してください。サンプルHTMLを生成するコードと一括処理のコードは、次の章で用意します。
2026年10月22日に、Windows 10 ビルド19045、Python 3.12.10、Requests 2.34.2、Beautiful Soup 4.15.0で、8件のサンプルHTMLの解析とCSV出力を確認しました。価格がNaNの場合と商品IDが一致しない場合は、終了コード1となり、既存のCSVを更新しないことも確認しています。検証には架空の商品データを使用しており、実際のAliExpress商品ページへのオンライン接続やプロキシ接続は検証していません。
python --version
python -m pip install requests==2.34.2 beautifulsoup4==4.15.0
入力URLは、https://www.aliexpress.com/item/PRODUCT_ID.html形式に限定しています。
- HTTPSを使用し、
PRODUCT_IDには数字のみを指定します。 - ホスト名は
aliexpress.comまたはwww.aliexpress.comを受け付けます。 - トラッキング用のクエリ文字列やフラグメントは付けません。
- 検索結果、レビューのページ送り、カート、決済情報は対象外です。
商品IDと価格を検証するパーサーの完全版
次のコードをarticle_ali_scraper.pyとして保存します。コード内のメッセージ、コメント、検証ページの判定文字列は、そのまま実行できる形で掲載しています。
"""Strict Product JSON-LD parser and optional, bounded AliExpress fetcher."""
import argparse
import csv
import json
import os
import re
import sys
import tempfile
from datetime import datetime, timezone
from decimal import Decimal, InvalidOperation
from pathlib import Path
from urllib.parse import urljoin, urlsplit

import requests
from bs4 import BeautifulSoup

FIELDS = ['product_id', 'title', 'currency', 'price', 'availability', 'rating',
          'review_count', 'processed_at_utc', 'input_url', 'final_url', 'source_kind']
REDIRECTS = {301, 302, 303, 307, 308}


def product_id_from_url(url, expected_id=None):
    try:
        u = urlsplit(url)
        valid_host = u.hostname in {'aliexpress.com', 'www.aliexpress.com'}
        valid_port = u.port in (None, 443)
    except (ValueError, TypeError):
        raise ValueError('invalid product URL') from None
    match = re.fullmatch(r'/item/([0-9]+)\.html', u.path)
    if (u.scheme != 'https' or not valid_host or not valid_port or u.username
            or u.password or u.query or u.fragment or not match):
        raise ValueError('use an HTTPS aliexpress.com /item/ID.html URL without query or fragment')
    pid = match.group(1)
    if expected_id is not None and pid != expected_id:
        raise ValueError('redirect or Product identity mismatch')
    return pid


def has_type(obj, wanted):
    types = obj.get('@type', [])
    if isinstance(types, str):
        types = [types]
    return isinstance(types, list) and any(t in {wanted, 'https://schema.org/' + wanted,
                                                'http://schema.org/' + wanted} for t in types if isinstance(t, str))


def walk(node):
    if isinstance(node, dict):
        yield node
        for value in node.values():
            yield from walk(value)
    elif isinstance(node, list):
        for value in node:
            yield from walk(value)


def candidate_matches(item, requested_id):
    identities = []
    for key in ('url', '@id'):
        value = item.get(key)
        if not value:
            continue
        if not isinstance(value, str):
            return False
        # A fragment may identify the Product entity within its own page.
        try:
            identities.append(product_id_from_url(value.split('#', 1)[0]))
        except ValueError:
            return False
    # Never equate a seller SKU with the marketplace's product ID.
    return bool(identities) and all(pid == requested_id for pid in identities)


def numeric(value, label):
    if isinstance(value, bool):
        raise ValueError(label + ' must be numeric')
    try:
        number = Decimal(str(value))
    except (InvalidOperation, ValueError):
        raise ValueError(label + ' must be numeric') from None
    if not number.is_finite() or number < 0:
        raise ValueError(label + ' must be finite and nonnegative')
    return format(number, 'f')


def parse_product(html, input_url, final_url=None, source_kind='saved_html'):
    requested_id = product_id_from_url(input_url)
    final_url = final_url or input_url
    product_id_from_url(final_url, requested_id)
    soup = BeautifulSoup(html, 'html.parser')
    # These are sample stop markers, not a universal challenge detector.
    visible = soup.get_text(' ', strip=True).lower()
    if any(marker in visible for marker in ('slide to verify', 'verify you are human',
                                             '请拖动下方滑块完成验证')):
        raise ValueError('verification page returned')
    candidates = []
    for script in soup.find_all('script', attrs={'type': 'application/ld+json'}):
        try:
            data = json.loads(script.string or script.get_text(), parse_float=Decimal)
        except (json.JSONDecodeError, TypeError):
            continue
        candidates.extend(n for n in walk(data) if has_type(n, 'Product')
                          and candidate_matches(n, requested_id))
    if len(candidates) != 1:
        raise ValueError('requested Product identity is missing or ambiguous')
    product = candidates[0]
    title = product.get('name')
    if not isinstance(title, str) or not title.strip():
        raise ValueError('product title is missing')
    offer = product.get('offers')
    if isinstance(offer, list) and len(offer) == 1:
        offer = offer[0]
    if (not isinstance(offer, dict) or not has_type(offer, 'Offer')
            or has_type(offer, 'AggregateOffer') or 'lowPrice' in offer or 'highPrice' in offer):
        raise ValueError('a single Offer with one price is required')
    price = numeric(offer.get('price'), 'price')
    currency = str(offer.get('priceCurrency', '')).strip().upper()
    if not re.fullmatch('[A-Z]{3}', currency):
        raise ValueError('currency must contain three ASCII letters')
    availability = str(offer.get('availability', '')).rstrip('/').rsplit('/', 1)[-1]
    if availability not in {'InStock', 'OutOfStock'}:
        availability = 'Unknown'
    rating = product.get('aggregateRating', {})
    rating = rating if isinstance(rating, dict) else {}
    optional = {}
    for key, output in [('ratingValue', 'rating'), ('reviewCount', 'review_count')]:
        value = rating.get(key)
        optional[output] = ''
        if value is not None and value != '':
            try:
                parsed = numeric(value, key)
                if key != 'reviewCount' or Decimal(parsed) == Decimal(parsed).to_integral_value():
                    optional[output] = parsed
            except ValueError:
                pass
    return dict(product_id=requested_id, title=title.strip(), currency=currency,
                price=price, availability=availability, **optional,
                processed_at_utc=datetime.now(timezone.utc).isoformat(timespec='seconds'),
                input_url=input_url, final_url=final_url, source_kind=source_kind)


def fetch_product(url, session):
    requested_id = product_id_from_url(url)
    current = url
    for hop in range(6):
        with session.get(current, timeout=(10, 20), allow_redirects=False, stream=True) as response:
            if response.status_code in REDIRECTS:
                if hop == 5 or not response.headers.get('Location'):
                    raise ValueError('redirect limit exceeded or Location missing')
                target = urljoin(current, response.headers['Location'])
                product_id_from_url(target, requested_id)
                current = target
                continue
            if response.status_code == 429:
                raw = response.headers.get('Retry-After', 'not supplied')
                hint = ''.join(c for c in raw if c.isprintable())[:100]
                raise ValueError('HTTP 429; stop. Retry-After: ' + hint)
            if response.status_code != 200:
                raise ValueError('HTTP ' + str(response.status_code) + '; stop current request')
            chunks, size = [], 0
            for chunk in response.iter_content(65536):
                size += len(chunk)
                if size > 5_000_000:
                    raise ValueError('HTML exceeds 5 MB limit')
                chunks.append(chunk)
            html = b''.join(chunks).decode(response.encoding or 'utf-8', errors='replace')
            return parse_product(html, url, current, source_kind='online_response')
    raise ValueError('redirect limit exceeded')


def safe_cell(value):
    text = str(value)
    # Protect spreadsheet users from formula-like untrusted product titles.
    return "'" + text if text.lstrip().startswith(('=', '+', '-', '@')) else value


def write_csv(path, rows, fields=FIELDS):
    path = Path(path)
    path.parent.mkdir(parents=True, exist_ok=True)
    name = None
    try:
        with tempfile.NamedTemporaryFile('w', encoding='utf-8-sig', newline='',
                                         dir=path.parent, delete=False) as f:
            name = f.name
            writer = csv.DictWriter(f, fieldnames=fields)
            writer.writeheader()
            writer.writerows({key: safe_cell(row[key]) for key in fields} for row in rows)
        os.replace(name, path)
    finally:
        if name and os.path.exists(name):
            os.unlink(name)


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument('url', help='HTTPS product-detail URL, without tracking parameters')
    parser.add_argument('--html', type=Path, help='parse saved HTML without any network request')
    parser.add_argument('--output', type=Path, default=Path('product.csv'))
    parser.add_argument('--authorized', action='store_true', help='confirm permission for an online request')
    args = parser.parse_args()
    try:
        if args.html:
            row = parse_product(args.html.read_text(encoding='utf-8'), args.url)
        else:
            if not args.authorized:
                parser.error('online requests require --authorized; use --html for offline parsing')
            with requests.Session() as session:
                row = fetch_product(args.url, session)
        write_csv(args.output, [row])
        print('Wrote 1 record to ' + str(args.output))
    except requests.RequestException as exc:
        print('STOP: ' + type(exc).__name__ + '; check connection, proxy and credentials locally', file=sys.stderr)
        return 1
    except (ValueError, OSError) as exc:
        print('STOP: ' + str(exc), file=sys.stderr)
        return 1
    return 0


if __name__ == '__main__':
    sys.exit(main())
2. 保存済みHTMLから商品情報を取得してCSVに出力する方法
まず8件のサンプルHTMLを生成し、同じパーサーでまとめて処理します。この手順ではAliExpressへのアクセスは発生しません。
サンプルHTMLを8件作成する
先ほどと同じフォルダーに、次のコードをbuild_examples.pyとして保存します。
"""Create eight explicitly synthetic parser fixtures; no network requests."""
import json
from pathlib import Path

EXAMPLES = [
    ('USB-C 7-in-1 Hub', 'USD', '24.90', 'InStock', '4.6', 328),
    ('Portable Laptop Stand', 'USD', '19.50', 'InStock', '4.5', 217),
    ('Compact Cable Organizer', 'USD', '8.25', 'InStock', None, None),
    ('Travel Packing Cubes', 'EUR', '17.30', 'InStock', '4.2', 84),
    ('Foldable Travel Bottle', 'EUR', '11.80', 'OutOfStock', None, None),
    ('Desk Cable Clips', 'EUR', '5.40', 'InStock', '4.1', 63),
    ('Adjustable Desk Lamp', 'JPY', '2480', 'InStock', '4.7', 105),
    ('Canvas Pencil Case', 'JPY', '780', 'OutOfStock', None, None),
]


def build():
    folder = Path(__file__).parent / 'saved_html'
    folder.mkdir(exist_ok=True)
    manifest = []
    for i, (title, currency, price, stock, rating, count) in enumerate(EXAMPLES, 100000001):
        url = f'https://www.aliexpress.com/item/{i}.html'
        product = {'@context': 'https://schema.org', '@type': 'Product', 'url': url,
                   'name': title, 'offers': {'@type': 'Offer', 'price': price,
                   'priceCurrency': currency, 'availability': 'https://schema.org/' + stock}}
        if rating is not None:
            product['aggregateRating'] = {'@type': 'AggregateRating', 'ratingValue': rating, 'reviewCount': count}
        html = '<!doctype html><html lang="en"><meta charset="utf-8"><title>Synthetic fixture</title><body><h1>Synthetic parser fixture; not a marketplace capture</h1><script type="application/ld+json">' + json.dumps(product) + '</script></body></html>'
        (folder / f'{i}.html').write_text(html, encoding='utf-8')
        manifest.append({'file': f'{i}.html', 'url': url, 'source_kind': 'synthetic_fixture'})
    (folder / 'manifest.json').write_text(json.dumps(manifest, indent=2), encoding='utf-8')
    print('Created 8 synthetic HTML fixtures; no marketplace requests were made.')


if __name__ == '__main__':
    build()
HTMLの解析とCSV・JSONへの出力をまとめて実行する
続いて、次のコードをrun_local_pipeline.pyとして保存します。
"""Parse the delivered synthetic HTML and export CSV summaries."""
import json
from collections import Counter
from pathlib import Path
from article_ali_scraper import parse_product, write_csv


def main():
    root = Path(__file__).parent
    folder = root / 'saved_html'
    manifest = json.loads((folder / 'manifest.json').read_text(encoding='utf-8'))
    rows = [parse_product((folder / entry['file']).read_text(encoding='utf-8'),
                          entry['url'], source_kind=entry['source_kind']) for entry in manifest]
    write_csv(root / 'product_fields.csv', rows)
    summaries = []
    for currency in sorted({r['currency'] for r in rows}):
        counts = Counter(r['availability'] for r in rows if r['currency'] == currency)
        summaries.append(dict(currency=currency, in_stock=counts['InStock'],
                              out_of_stock=counts['OutOfStock'], unknown=counts['Unknown'], total=sum(counts.values())))
    write_csv(root / 'currency_availability_summary.csv', summaries,
              ['currency', 'in_stock', 'out_of_stock', 'unknown', 'total'])
    (root / 'product_fields.json').write_text(json.dumps(rows, indent=2), encoding='utf-8')
    for row in rows:
        print(f"{row['product_id']} | {row['currency']} {row['price']} | {row['availability']}")
    print('Wrote 8 synthetic records to product_fields.csv')
    for item in summaries:
        print(item)


if __name__ == '__main__':
    main()
作業フォルダーで、次のコマンドを順に実行してください。
python build_examples.py
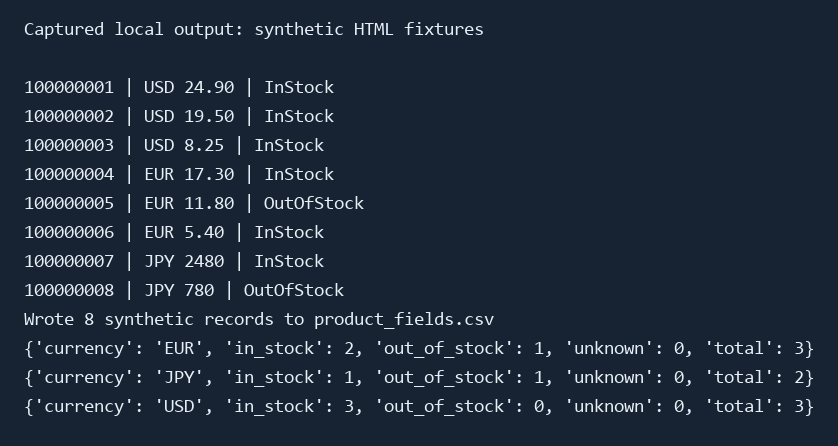
python run_local_pipeline.py
最初のコマンドで、saved_html/に架空のサンプルHTMLを8件と、ファイル一覧のmanifest.jsonを作成します。次のコマンドで各HTMLをparse_product()に渡し、以下のファイルを出力します。
| 出力ファイル | 内容 |
|---|---|
product_fields.csv |
8件の商品データ。入力URL、最終URL、処理日時、データの種別も記録します |
currency_availability_summary.csv |
通貨別・在庫状況別の件数。不明の区分も設けます |
product_fields.json |
CSVと同じ商品データを、後続処理に利用できるJSON形式で保存します |
サンプルの内訳は、USDが3件、EURが3件、JPYが2件です。
自分で保存した商品HTMLを処理する
UTF-8で保存したHTMLをテキストエディターで開き、application/ld+jsonを検索します。次の構造が含まれているか確認してください。
- 対象商品を指す
urlまたは@idを持つProductがあること。 offersに単一のOfferがあること。- その
OfferにpriceとpriceCurrencyがあること。
このパーサーはJavaScriptを実行しません。必要な構造が見つからない場合は、抽出ルールを変える前に、HTMLの保存方法や保存内容を確認します。
PRODUCT_IDを商品URLの数値IDに置き換え、次のコマンドを実行します。
python article_ali_scraper.py "https://www.aliexpress.com/item/PRODUCT_ID.html" --html saved-product.html --output product.csv
--htmlを指定した場合、ネットワーク通信は発生しません。正常終了時は終了コード0となり、Wrote 1 recordを含むメッセージを表示してCSVを更新します。検証に失敗すると終了コード1となり、既存の出力ファイルは更新しません。
3. JSON-LDから対象の商品を特定する仕組み
商品を特定する根拠は、Productのurlと@idです。商品名や販売者SKUが一致するだけでは、対象商品として扱いません。
パーサーは<script type="application/ld+json">を読み込み、JSONオブジェクト、配列、@graphの内部を再帰的に探索します。@typeは文字列とリストの両方に対応します。JSONとして壊れているブロックは読み飛ばし、条件に一致するProductが1件に定まらないページはエラーにします。
照合ルールは次のとおりです。
urlまたは@idの少なくとも一方が、要求した/item/ID.htmlを指す必要があります。- 両方ある場合は、どちらも同じ商品IDを指している必要があります。
- 一方が対象商品を指していても、もう一方に空でない値があり、その型やURL形式が本実装の条件に合わない場合はエラーにします。
- 構造化データの識別子には、
#productのようなフラグメントを付けられます。 - おすすめ商品カードや販売者SKUから商品IDを推測しません。
第1章の実装は、Pythonから直接呼び出すこともできます。
from pathlib import Path
from article_ali_scraper import parse_product

html = Path("saved_html/100000001.html").read_text(encoding="utf-8")
record = parse_product(
    html,
    "https://www.aliexpress.com/item/100000001.html",
    source_kind="synthetic_fixture",
)
print(record["product_id"], record["currency"], record["price"])
生成したサンプルでは、100000001 USD 24.90と表示します。このURLは架空のサンプルを識別するための値なので、オンライン取得には使用せず、ローカルで確認してください。
JSON-LD内の参照先をたどる処理、一致するProductが複数ある場合の選別、未対応の識別子形式には、保存したページ構造に応じた実装の追加が必要です。現状のコードでは、任意の候補を選ばずエラーにします。
4. 商品価格・通貨・在庫情報の検証ルール
必須項目に不備がある商品は出力せず、任意項目の評価やレビュー件数は欠損として残します。これにより、取得できなかった値と実際の0を区別できます。
| 項目 | 検証・保存のルール | 欠損や不正な値の扱い |
|---|---|---|
product_id |
入力した商品URLのIDと照合します | レコードを出力しません |
title |
Product.nameに空白以外の文字が必要です |
レコードを出力しません |
price |
単一のOffer.priceを10進数で処理します。負数、無限大、NaNは認めません |
レコードを出力しません |
currency |
ASCII英大文字3文字に正規化します | レコードを出力しません |
availability |
値の末尾の名称でInStockとOutOfStockに分類します。URI全体の妥当性は検証しません |
欠損やそれ以外の状態はUnknownにします |
rating / review_count |
任意のaggregateRatingから取得します。有限かつ0以上で、レビュー件数は整数であることを確認します |
空欄にします |
processed_at_utc |
この入力をパーサーで処理したUTC日時を記録します | HTMLを保存した日時とは区別します |
input_url / final_url |
入力URLと、オンライン取得時に検証した遷移先URLを保存します。保存済みHTMLではfinal_urlの既定値はinput_urlです |
指定した遷移先が対象商品と一致しなければエラーにします |
source_kind |
サンプル、保存済みHTML、オンライン応答を区別します | データの由来を保持します |
価格と通貨のプロパティは、Schema.orgのOfferの仕様で定義されています。ただし、このコードの通貨チェックは文字列の形式だけを確認します。ISO 4217に実在する通貨コードかどうかも確認する場合は、最新の許可リストを追加してください。
単一価格に限定する理由
受け付けるのは、単一のOfferオブジェクト、またはそのOfferだけを含む要素数1のリストです。複数のオファー、AggregateOffer、lowPriceやhighPriceを含む価格帯は受け付けません。
これは、1レコードに1つの表示価格を保存するための設計です。それ以外のSchema.orgの記述が不正という意味ではありません。
JSON内の小数は、2進浮動小数点数を経由せずDecimalとして読み込みます。小数の文字列にも対応します。CSVには固定小数点表記で書き込むため、指数表記の数値は桁を展開した文字列になる場合があります。
保存済みHTMLを扱う場合は、保存時のURLと取得日時を別途記録してください。既定のfinal_urlだけでは、保存前のリダイレクト履歴までは確認できません。
表示価格と決済金額を混同しない
このコードで記録するのは、構造化データ内の表示価格です。実際の決済金額は、バリエーション、配送先、キャンペーン、送料、税金によって変わることがあります。
価格比較では、少なくとも次の条件を別途記録します。
- 選択したバリエーション
- 対象市場と配送先
- ページの取得日時
プロキシの出口IPだけでは、これらの条件は確定しません。
5. CSVをExcelに取り込み、通貨別に集計する方法
Excelでは、商品IDを文字列として取り込み、通貨別・在庫状況別に件数を集計します。異なる通貨の価格をそのまま合算せず、評価の空欄も0に置き換えないようにします。
CSVの取り込みとシートの準備
- Excelの**[データ]→[テキストまたはCSVから]**で
product_fields.csvを取り込みます。 - 長い商品IDの丸めを防ぐため、
product_idのデータ型を文字列に指定します。評価の空欄はそのまま残します。 - Product FieldsとSummaryという名前のシートを作成します。以下の数式は、このシート名を使います。
- Product Fieldsの4行目に見出し、5〜12行目に8件の商品データを配置します。
- A〜H列を順に、商品ID、商品名、通貨、表示価格、在庫状況、評価、レビュー件数、処理日時とします。残りのURLやデータ種別は右側に残します。
Pythonのコマンドで生成するのはCSVとJSONです。Excelのシートは、ここで説明する手順と数式を使って作成します。
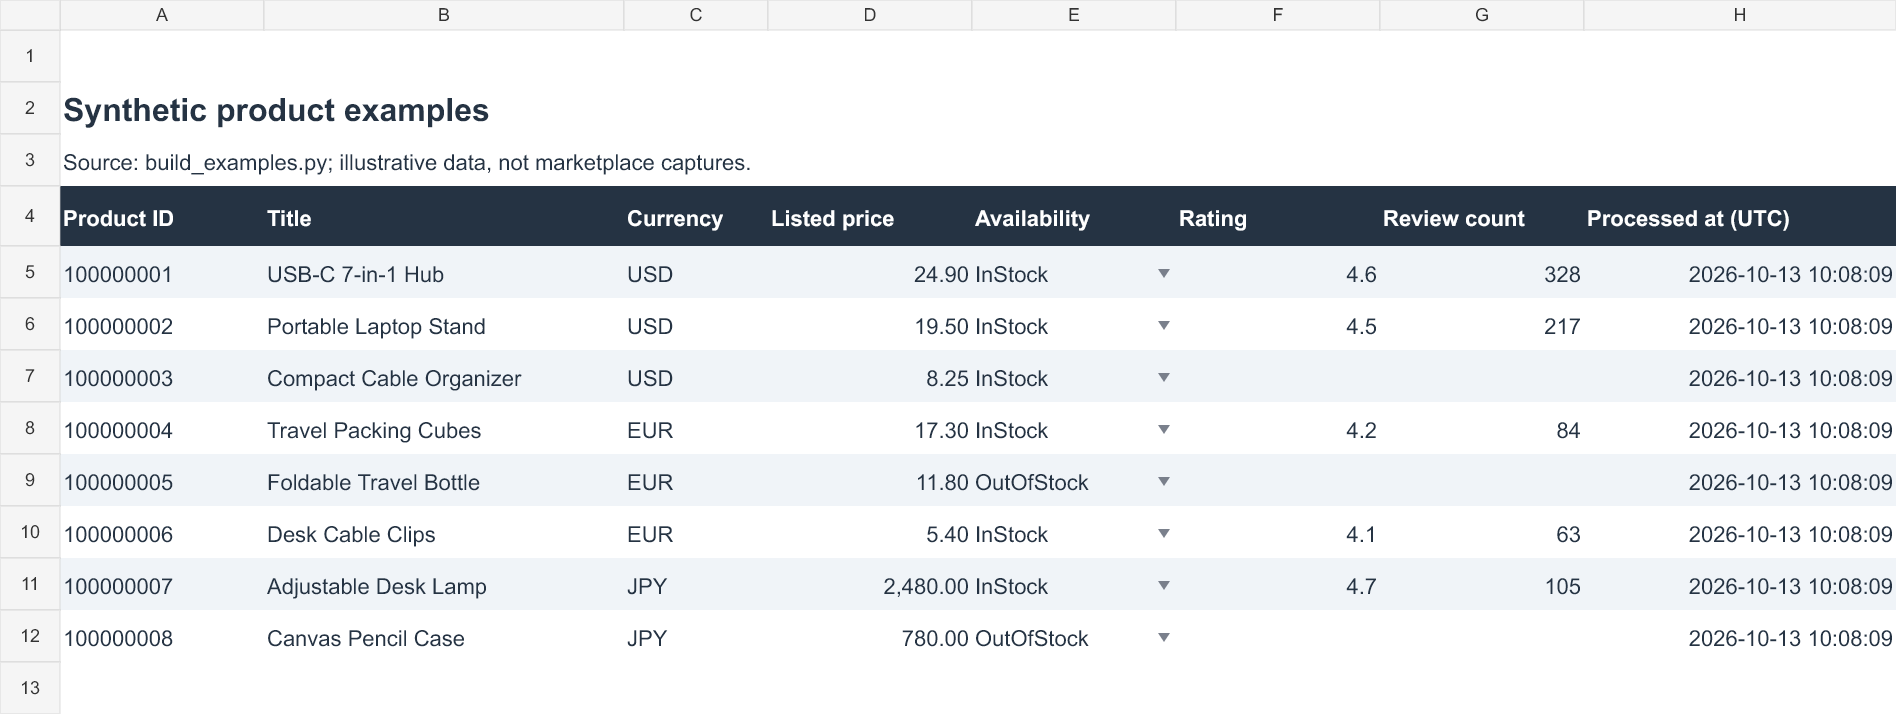
通貨別・在庫状況別の件数を数える
Product FieldsのC列が通貨、E列が在庫状況です。SummaryのA4:E4に「通貨」「在庫あり」「在庫切れ」「不明」「合計」を配置し、A5:A7にUSD、EUR、JPYを入力します。
B5には、在庫ありの件数を数える式を入力します。
=COUNTIFS('Product Fields'!$C$5:$C$12,$A5,'Product Fields'!$E$5:$E$12,"InStock")
続いて、次の順で集計範囲を作成します。
- C5には、上の式の
"InStock"を"OutOfStock"に変えた式を入力します。 - D5には、同じ箇所を
"Unknown"に変えた式を入力します。 - E5に
=SUM(B5:D5)を入力します。 - B5:E5を7行目までコピーします。
- B8に
=SUM(B5:B7)を入力し、E8まで右にコピーします。
サンプルの結果は次のとおりです。
通貨 |
在庫あり |
在庫切れ |
不明 |
合計 |
|---|---|---|---|---|
USD |
3 |
0 |
0 |
3 |
EUR |
2 |
1 |
0 |
3 |
JPY |
1 |
1 |
0 |
2 |
合計 |
6 |
2 |
0 |
8 |
在庫情報の欠損や未対応の状態は、解析時にUnknownへ変換します。在庫切れとして数えることはありません。
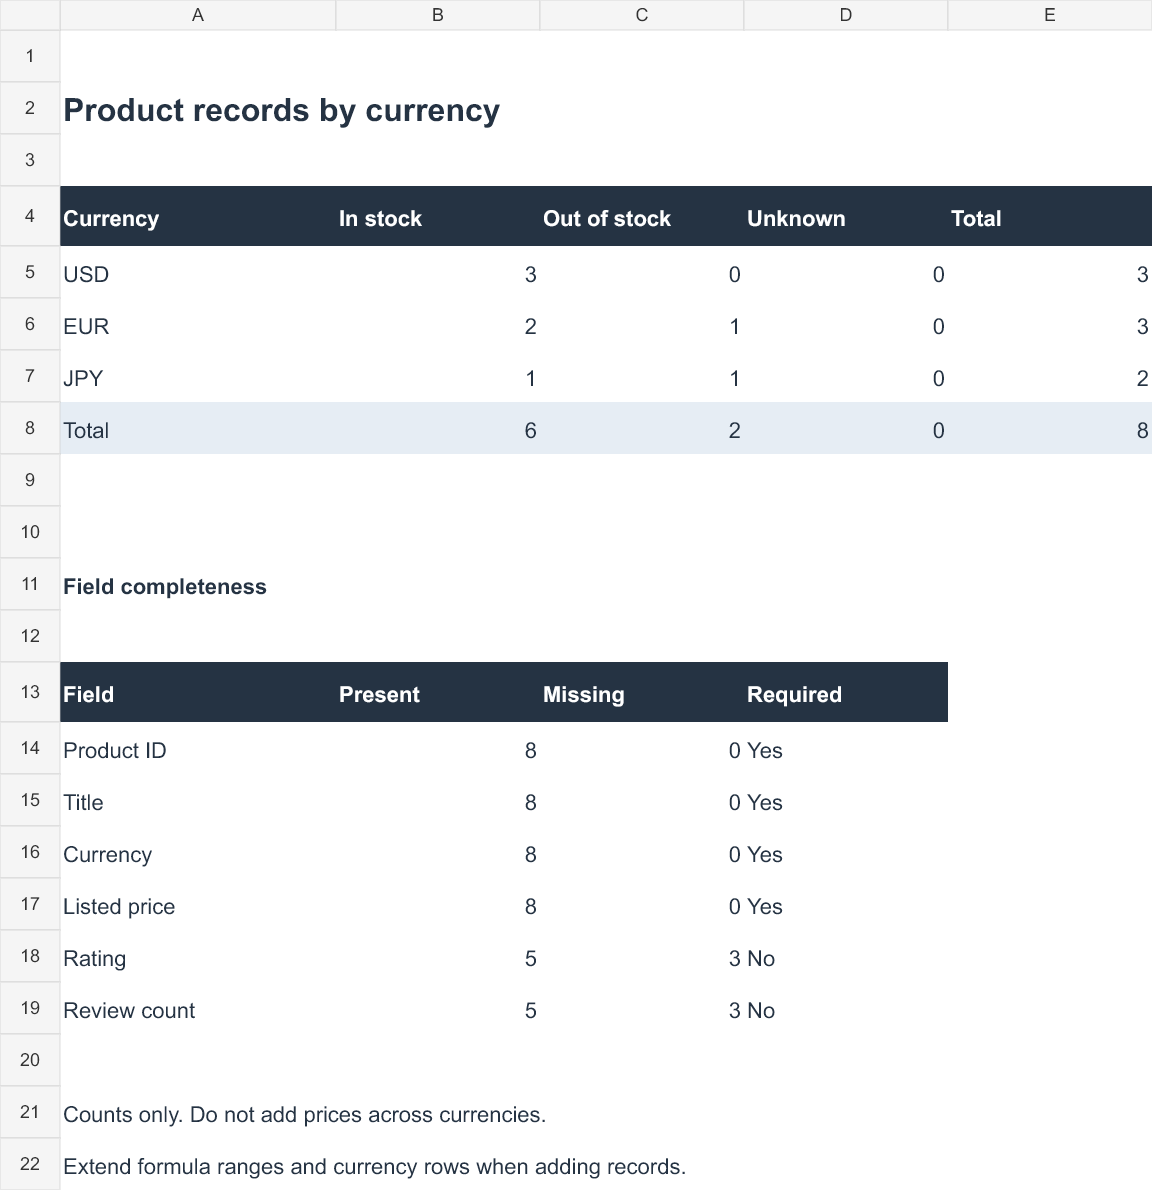
データを追加したら、数式の参照範囲を広げ、新しい通貨も集計表に追加します。CSVの内容を手作業で置き換える場合も、在庫状況はInStock、OutOfStock、Unknownに統一してください。
入力のばらつきを防ぐには、Product FieldsのE5:E12を選び、[データ]→[データの入力規則]→[リスト] で、元の値にInStock,OutOfStock,Unknownを指定します。
欠損値を0に置き換えずに確認する
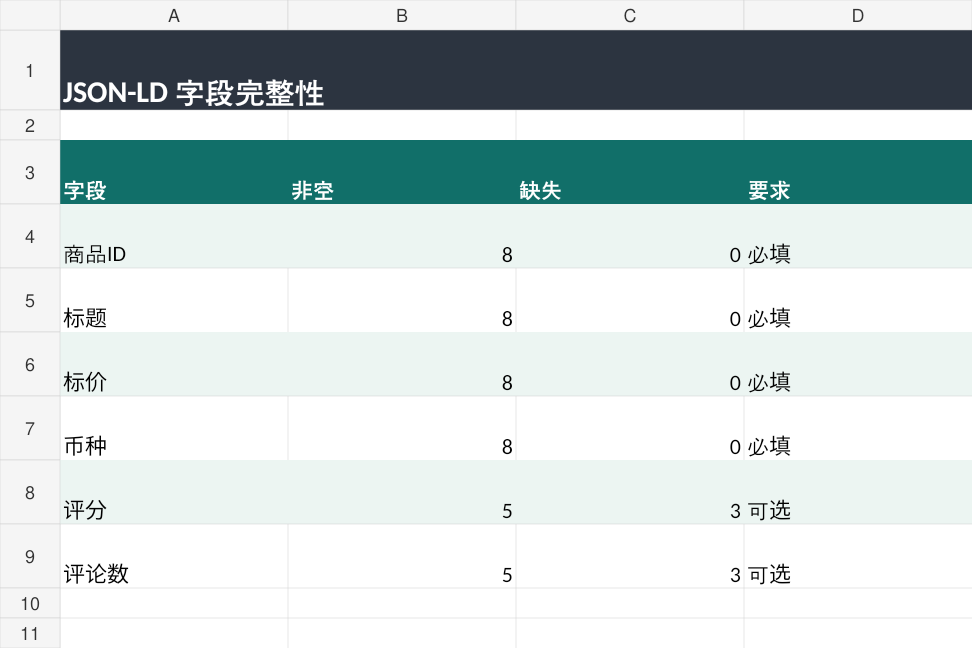
8件すべてに商品ID、商品名、通貨、価格があります。評価とレビュー件数があるのは5件で、残り3件は空欄です。評価の欠損件数は次の式で確認できます。
=COUNTBLANK('Product Fields'!F5:F12)
図3のように入力済み件数も出す場合は、=ROWS('Product Fields'!F5:F12)-COUNTBLANK('Product Fields'!F5:F12)を使います。A〜D列とG列についても、同様に空欄と入力済みの件数を確認してください。数値の0は、有効な値として残します。
大量の商品を比較する場合は、通貨、バリエーション、市場、取得期間などの条件をそろえてから価格統計を計算します。
6. AliExpressのスクレイピングでエラーが出る場合の対策
処理の成功はHTTPステータスだけで判断せず、対象商品の一致と必須項目の検証まで確認します。まずローカルで異常な入力を試すと、誤ったデータをCSVに書き込まないかを確かめられます。
自分のHTMLに適用する前に、8件のサンプルを実行し、図1と件数が一致するか確認してください。その後、生成したHTMLのコピーで次のチェックを行います。
- 価格を
"NaN"に変更し、第2章の単一ファイル用コマンドを実行します。 - 入力を元に戻し、
ProductのURLを別の商品IDに変更して、もう一度実行します。 - どちらも終了コード
1となり、既存のCSVが更新されないことを確認します。 - 入力を元に戻して在庫情報を削除し、
Unknownになることを確認します。 - 任意の評価項目を削除し、空欄になることを確認します。
これらのチェックは、AliExpressにアクセスせず実施できます。
| 症状 | 確認する箇所 | 対処 |
|---|---|---|
対象のProductが1件に定まらない |
url、@id、重複オブジェクト、HTMLの内容 |
保存したページを確認します。おすすめ商品の情報で補いません |
| HTTP 200でも商品情報を取得できない | ログイン画面、認証画面、最終URL | 処理を停止します。HTTP 200だけでは成功と判断できません |
| 価格がない、または価格帯になっている | Offerの構造と選択したバリエーション |
対象を出力から除外するか、バリエーションに対応した別のパーサーを設計します |
| HTTP 403 | アクセス権限とページの利用条件 | 現在のリクエストを停止します |
| HTTP 429 | Retry-Afterとリクエスト頻度 |
停止し、許可された次回の取得時刻を調整します |
HTTP 407、ProxyError |
プロキシの認証情報、プロトコル、ホスト、ポート | パスワードを公開せず、ローカルで設定を確認します |
| 接続・読み取りのタイムアウト | 通信経路と応答状況 | 原因を調べてから再実行します |
一括処理では、全レコードの解析を終えてから商品CSVを置き換えます。各CSVは一時ファイルに書き込み、os.replaceで差し替えますが、JSONは直接書き込みます。3つの出力全体を一括で確定する仕組みではないため、実行結果を確認する際は日時と件数も照合してください。
CSV出力時には、数式のように見える商品名などの先頭にアポストロフィを付け、数式として解釈されるリスクを抑えます。扱いは表計算ソフトや取り込み方法によって異なるため、外部データは文字列として取り込み、表示結果も確認してください。
7. 権限のある商品ページをオンラインで取得する方法
商品ページへのアクセスが認められている場合は、オンライン応答にも同じパーサーを使えます。保存済みHTMLの処理だけであれば、プロキシもオンライン取得も不要です。
python article_ali_scraper.py "https://www.aliexpress.com/item/PRODUCT_ID.html" --authorized --output online-product.csv
PRODUCT_IDは実際の対象商品のIDに置き換えます。実行前に、サイトの最新のアクセスルールと、対象業務で認められている範囲を確認してください。--authorizedは実行する意思を指定するフラグであり、プラットフォームから許可を取得する機能ではありません。
取得処理の設定は次のとおりです。
| 項目 | 設定・動作 |
|---|---|
| リダイレクト | 最大5回。すべて許可ホスト上の同じ商品に限定します |
| 接続タイムアウト | 10秒 |
| 読み取りタイムアウト | 20秒 |
| 応答サイズ | iter_content()で受け取る、HTTPの圧縮を展開した後のデータを最大5,000,000バイト(5 MB)に制限します。文字コードのデコードは、その後に行います |
| HTTPエラー | 自動再試行せず停止します |
| HTTP 429 | Retry-Afterを表示して終了します |
読み取りタイムアウトは、データ受信を待つ時間の制限です。処理全体が20秒以内に終わることを保証するものではありません。
このサンプルはHTTPエラー時に自動再試行しません。別途Python Requestsのリトライ設定を組み込む場合は、対象サイトのルールとRetry-Afterに合わせて、試行回数と待機時間を制限します。
Requestsは応答HTMLを取得しますが、JavaScriptは実行しません。対応するProductがHTMLに含まれていなければエラーにします。認証を解いたり、不足項目を生成したりする機能はありません。また、コード内の認証画面の判定文字列は一例であり、すべての確認画面を検出できるわけではありません。
8. Pythonのプロキシ設定とRola IPの使いどころ
通信の出口として住宅用プロキシを使う場合も、商品IDや価格の検証はパーサー側で行います。Rola IPを利用する際は、管理画面で発行した接続情報を設定します。
商品IDや各項目の検証は、接続手段とは別にパーサーで行います。対象市場、バリエーション、配送先、通貨も、それぞれ明示的に記録する必要があります。
RequestsはHTTPS_PROXY環境変数に対応しています。詳細はRequests公式ドキュメントのプロキシ設定を参照してください。接続情報には、管理画面で発行した値を使います。
macOS・Linuxでプロキシを設定する
シェルで次の環境変数を設定します。
export HTTPS_PROXY="http://USERNAME:PASSWORD@HOST:PORT"
Windows PowerShellでプロキシを設定する
Pythonを起動するPowerShellで、次のように指定します。
$env:HTTPS_PROXY = "http://USERNAME:PASSWORD@HOST:PORT"
大文字のプレースホルダーは、すべて実際の接続情報に置き換えます。ユーザー名やパスワードにURLの予約文字が含まれる場合は、パーセントエンコードしてください。
実際の認証情報は、共有スクリプト、ターミナルのスクリーンショット、コマンド履歴のエクスポートに残さないようにします。NO_PROXYの設定で対象ホストがプロキシを経由しない場合もあるため、実際の通信の出口を確認してください。PowerShell自体のプロキシ設定と、そこから起動するPythonプロセスの設定も区別します。
HTTP 503の発生元は、対象サイト、CDN、プロキシ経路のいずれの場合もあります。設定を変更する前に、どこで応答が返っているかを確認します。出口IPを変えるだけで、アカウントの制限、セッションの状態、ページ構造の違いまで解消できるわけではありません。
まとめ:商品を照合してから価格を比較する
AliExpressのスクレイピングでは、商品IDの照合、単一価格の検証、欠損値の区別を先に固めることが大切です。まずは8件のサンプルでCSV出力と異常時の挙動を確認し、その後、処理する権限のある商品HTMLに適用してください。
実際の比較では、データの由来と取得条件を残し、Excelで項目の充足状況と通貨別の件数を確認します。バリエーションや配送先、取得時期までそろえると、表示価格を比較するための土台が整います。