
Python Requestsのリトライ設定:再試行回数・待機時間・プロキシエラーを制御する
2026年10月13日 · トラブルシューティング · 約19分で読める
Python Requestsでリトライを実装する基本形は、SessionにHTTPAdapterを登録し、urllib3.Retryで再試行条件を指定する方法です。 一時的な接続障害や503には回数を制限して再試行し、429ではRetry-Afterを尊重します。認証情報の誤りや証明書エラーは、回数を増やす前に原因を修正してください。
この記事では、API連携や定期的なデータ取得を担当する開発者向けに、GETの再試行、タイムアウト、バックオフ、プロキシ接続の切り分けを解説します。外部サイトに障害テストを送る必要はありません。ローカルサーバーで503・429・404を再現し、実際のリクエスト回数を確認できます。
最初に押さえるポイント
total=4は「初回を除く最大4回の再試行」です。合計では最大5回になります。timeout=(5, 20)は接続と読み取り待機の指定であり、処理全体を25秒以内に終わらせる設定ではありません。allowed_methodsは主にステータスコードや読み取りエラーの再試行対象を制限します。対象外のメソッドでも、接続段階の再試行がすべて禁止されるわけではありません。- レスポンス本文の読み取りで後から発生するエラーは、Adapterの再試行だけでは回復できない場合があります。
- POSTなどの書き込み処理は、冪等性キーや重複排除の契約がない状態で自動再送しません。
- Requestsの
Sessionと、プロキシ事業者のスティッキーセッションは別物です。Sessionを使っても出口IPの固定は保証されません。
Python Requestsのリトライとは?
リトライとは、一時的な失敗に対して、条件・回数・待機時間を決めたうえでリクエストを再送する仕組みです。無制限のwhile Trueは、障害中のサーバーに負荷を重ね、処理時間や課金トラフィックも増やします。
設計時には「何を再試行するか」「何回までか」「いつ再開するか」「同じプロキシ出口を維持するか」「最終失敗をどう通知するか」を決めます。RequestsのHTTPAdapter公式リファレンスにある整数のmax_retriesは、主に接続段階の障害に対する指定です。HTTPステータス、メソッド、待機時間まで制御する場合は、Retryオブジェクトを渡します。
Python RequestsでGETを再試行するには?
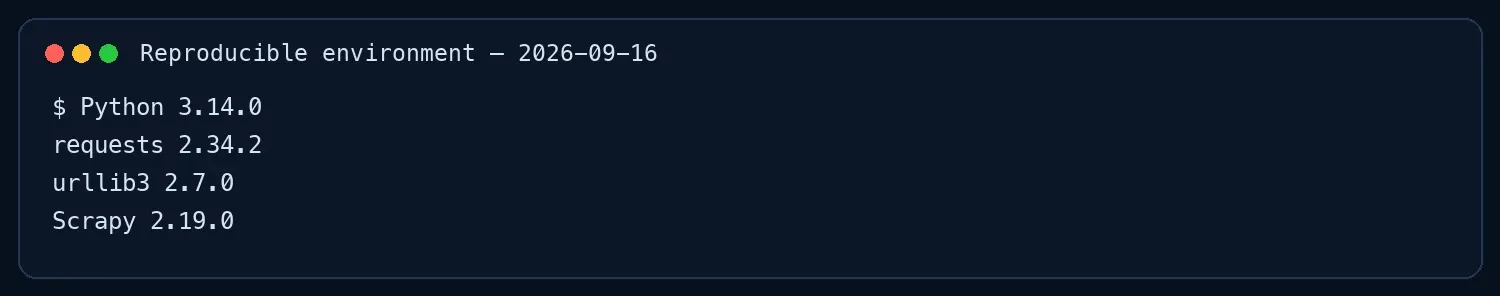
1. 仮想環境と依存ライブラリを準備する
macOS・Linuxでは次のコマンドを使用します。
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requests==2.34.2 urllib3==2.7.0
WindowsのPowerShellでは、アクティベーションを使わずに仮想環境のPythonを直接呼び出せます。
py -m venv .venv
.\.venv\Scripts\python.exe -m pip install requests==2.34.2 urllib3==2.7.0
以降のpythonは、依存関係をインストールした環境のPythonを指します。Windowsでは必要に応じて.\.venv\Scripts\python.exeに置き換えてください。
2. HTTPAdapterを設定する
次をhttpadapter_demo.pyとして保存します。接続先は後述するローカルサーバーです。
import requests
from requests.adapters import HTTPAdapter
from urllib3.util import Retry


def build_session() -> requests.Session:
    retry = Retry(
        total=4,
        connect=4,
        read=4,
        status=4,
        other=0,
        allowed_methods=frozenset({"GET", "HEAD", "OPTIONS"}),
        status_forcelist={429, 500, 502, 503, 504},
        backoff_factor=0.25,
        backoff_jitter=0.1,
        respect_retry_after_header=True,
        raise_on_status=False,
    )

    adapter = HTTPAdapter(
        max_retries=retry,
        pool_connections=10,
        pool_maxsize=10,
    )
    session = requests.Session()
    session.trust_env = False
    session.mount("http://", adapter)
    session.mount("https://", adapter)
    return session


if __name__ == "__main__":
    import sys
    path = sys.argv[1] if len(sys.argv) > 1 else "/flaky"
    if path not in {"/flaky", "/rate-limit", "/missing"}:
        raise SystemExit("/flaky、/rate-limit、/missingのいずれかを指定してください")
    with build_session() as session:
        response = session.get("http://127.0.0.1:8877" + path, timeout=(5, 20))
        print("再試行履歴:", [h.status for h in response.raw.retries.history])
        print("最終ステータス:", response.status_code)
        response.raise_for_status()
        print("JSON:", response.json())
raise_on_status=Falseにより、ステータスコードに対する再試行回数を使い切った場合も、最後のレスポンスを受け取れます。その後のraise_for_status()でHTTPエラーを明示的に扱います。接続失敗までレスポンスとして返るわけではなく、通信例外は別途発生します。
trust_env=Falseは、このローカル検証を環境変数のプロキシ設定から切り離すための指定です。本番で使う場合は、環境変数によるプロキシ、CAバンドル設定、.netrc由来の認証にも影響する点を確認してください。社内CAが必要ならverifyで正しいCAファイルを指定し、verify=Falseで回避しないでください。
Python Requestsのエラー解決:再試行すべき障害を見分ける
| 障害の段階 | 主な症状 | 自動再試行の判断 | 最初に確認すること |
|---|---|---|---|
| DNS・ネットワーク | ConnectionError、名前解決失敗 |
一時的な障害なら限定的に実施 | ドメイン、DNS、経路 |
| 接続 | ConnectTimeout |
読み取り用途では候補 | 接続先、ポート、ファイアウォール |
| 読み取り | ReadTimeout、本文取得中のConnectionError |
再送の安全性と発生段階による | 応答時間、本文サイズ、読み取り待機時間 |
| TLS | SSLError |
原則として原因を修正 | 証明書チェーン、時刻、社内CA |
| プロキシ接続 | ProxyError、接続拒否 |
原因を確認してから判断 | ゲートウェイ、ポート、サービス状態 |
| プロキシ認証 | 407、トンネル接続時のProxyError |
盲目的に再試行しない | ユーザー名、パスワード、許可IP、文字のエンコード |
| クライアント側 | 400、401、403、404、422 | 通常は設定・権限を修正 | パラメータ、認可、URL |
| レート制限 | 429 | 待機指示と上限の範囲内 | Retry-After、クォータ、同時実行数 |
| サーバー側 | 500、502、503、504 | 一時的なら限定的に実施 | 継続時間、上流障害、停止条件 |
| 業務データ | 200なのにログイン画面や必須項目欠落 | HTTP再試行とは分ける | Content-Type、JSONスキーマ、ログイン状態 |
timeoutを指定しても処理全体が長引くのはなぜですか?
timeout=(5, 20)の5秒は接続、20秒は読み取り時にデータを待つ時間の設定です。本文が少しずつ届き続けるケースや、DNS解決、複数回の接続・待機を含む処理全体に対する厳密な締め切りではありません。
処理全体の上限は、ジョブ管理側で別に設けます。再試行の間に残り時間を確認するだけでは、進行中の同期リクエストを必ず中断できるとは限りません。厳密な終了期限が必要なら、実行プロセスの管理なども含めて設計してください。
HTTP 200なら成功として扱ってよいですか?
HTTP 200だけでは、必要なデータを取得できたとは判断できません。JSONを想定しているならContent-Type、JSON解析、必須フィールド、値の範囲まで確認します。HTMLの場合も、ログイン画面や確認画面を正しいデータとして保存しないようにします。通信層の再試行と業務データの検証は、それぞれ必要です。
POST・PUT・DELETEも再試行してよいですか?
| メソッド・操作 | 基本方針 | 注意点 |
|---|---|---|
| GET・HEAD・OPTIONS | 読み取り用途なら再試行の候補 | 実際のAPI契約とアクセス制限を確認 |
| PUT・DELETE | 個別判断 | HTTP上は冪等でも、実装や付随処理を確認 |
| POST | 原則として自動再送しない | レコード、注文、ジョブが二重作成される可能性 |
| 決済・注文・通知送信 | 曖昧な失敗をそのまま再送しない | 操作ID、冪等性キー、処理結果照会が必要 |
冪等性とは、同じ操作を繰り返しても、意図した最終結果が変わらない性質です。 タイムアウトしても、サーバー側では処理が完了している場合があります。APIがIdempotency-Keyなどに対応しているなら、同じ論理操作には同じキーを使用し、結果を照会できるようにします。
allowed_methodsにPOSTを追加しても、業務処理が安全になるわけではありません。また、この集合は接続段階の再試行を一律に禁止する機能ではないため、「POSTを絶対に自動再送しない」経路には再試行を無効にした専用Adapterを使い、キューや外側のループも確認してください。
ローカルサーバーで503・429・404を再現する
検証環境と確認範囲
| 項目 | 今回の検証 |
|---|---|
| 実行日 | 2026年10月13日 |
| OS | Windows 11、ビルド26200 |
| Python | 3.14.7 |
| Requests / urllib3 | 2.34.2 / 2.7.0 |
| 通信先 | 127.0.0.1:8877のみ |
| 確認した処理 | HTTPAdapter、手動ループ、429待機、404の非再試行、試行上限、Retry-After解析 |
| 検証対象外 | Rola IP実回線、外部API、POST、本文途中の切断、Scrapy実行 |
ここでの成功は「指定したローカル応答に対して想定回数で終了すること」です。外部サービスへの接続成功や本番環境の安定性を示すものではありません。
1. 障害応答を返すサーバーを作る
次をflaky_server.pyとして保存します。
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer
import json
from threading import Lock

COUNTS = {"flaky": 0, "rate-limit": 0}
LOCK = Lock()


class Handler(BaseHTTPRequestHandler):
    def send_json(self, status, payload, headers=None):
        body = json.dumps(payload).encode("utf-8")
        self.send_response(status)
        self.send_header("Content-Type", "application/json; charset=utf-8")
        self.send_header("Content-Length", str(len(body)))
        for name, value in (headers or {}).items():
            self.send_header(name, value)
        self.end_headers()
        self.wfile.write(body)

    def do_GET(self):
        if self.path == "/reset":
            with LOCK:
                COUNTS.update({"flaky": 0, "rate-limit": 0})
            self.send_json(200, {"ok": True, "message": "counters reset"})
            return

        if self.path == "/flaky":
            with LOCK:
                COUNTS["flaky"] += 1
                attempt = COUNTS["flaky"]
            status = 503 if attempt <= 2 else 200
            self.send_json(status, {"ok": status == 200, "attempt": attempt})
            return

        if self.path == "/rate-limit":
            with LOCK:
                COUNTS["rate-limit"] += 1
                attempt = COUNTS["rate-limit"]
            if attempt == 1:
                self.send_json(
                    429,
                    {"ok": False, "attempt": attempt},
                    {"Retry-After": "1"},
                )
            else:
                self.send_json(200, {"ok": True, "attempt": attempt})
            return

        self.send_json(404, {"ok": False, "message": "not found"})

    def log_message(self, fmt, *args):
        print(f"サーバー {self.command} {self.path} -> {args[1]}", flush=True)


if __name__ == "__main__":
    server = ThreadingHTTPServer(("127.0.0.1", 8877), Handler)
    print("待ち受け開始: http://127.0.0.1:8877", flush=True)
    server.serve_forever()
/flakyは最初の2回が503、3回目が200です。/rate-limitは初回に429とRetry-After: 1、2回目に200を返します。/resetは検証専用であり、本番APIに状態を変更するGETを設けるための例ではありません。
2. ターミナルを2つ開く
1つ目でサーバーを起動します。
python flaky_server.py
2つ目でカウンターを初期化してからクライアントを実行します。サーバー起動コマンドが動き続けるため、同じターミナルに続けて入力しないでください。
curl --fail --show-error http://127.0.0.1:8877/reset
python httpadapter_demo.py /flaky
PowerShellでcurlが別コマンドに割り当てられている場合はcurl.exeを使います。8877番ポートが使用中ならサーバーとクライアントの両方を同じ空きポートに変更します。終了はサーバー側でCtrl+Cです。
3. 再試行履歴と最終結果を確認する
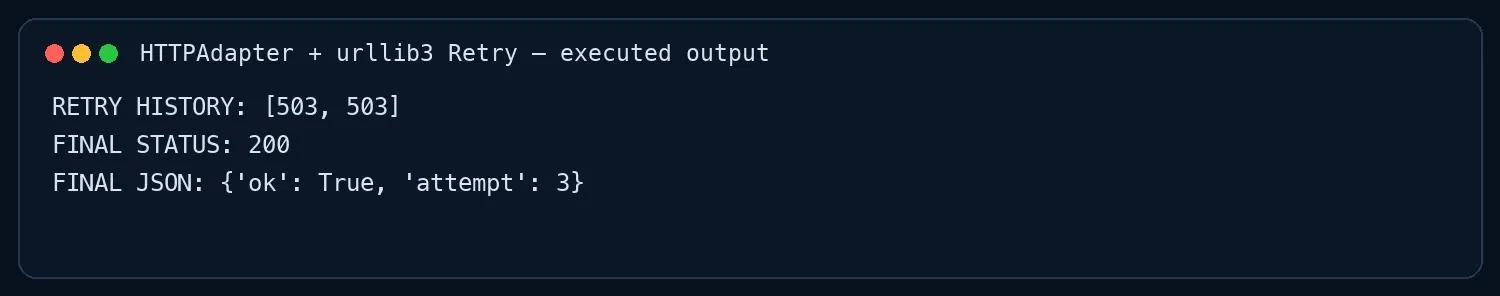
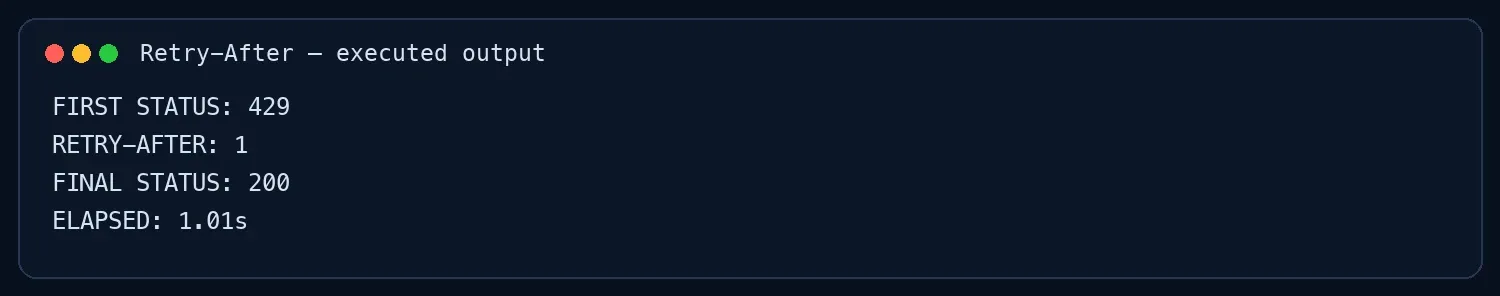
今回の/flaky検証では、履歴が[503, 503]、最終ステータスが200、JSONのattemptが3でした。/rate-limitでは履歴が[429]、最終ステータスが200となり、処理時間は約1.035秒でした。時間は実行環境で変わるため、同じ小数値を成功条件にしません。
curl --fail --show-error http://127.0.0.1:8877/reset
python httpadapter_demo.py /rate-limit
python httpadapter_demo.py /missing
/missingは404、再試行履歴は空です。サンプルのraise_for_status()が例外を出して終了するのが想定動作です。実測の項目別結果は ローカル検証記録で確認できます。
Python Requestsの再試行を手動ループで実装する
独自の判定が必要な場合は、回数を制限したループでも実装できます。以下のbasic_retry.pyはGET専用で、指定した5xxと通信エラーを対象にします。429、TLSエラー、プロキシエラーは自動再試行せず、呼び出し側に判断を返します。
import random
import time
import requests

RETRYABLE_STATUSES = {500, 502, 503, 504}


def _get_with_basic_retry(session, url: str, attempts: int) -> requests.Response:
    if attempts < 1:
        raise ValueError("attemptsには1以上を指定してください")

    last_error = None
    for attempt in range(1, attempts + 1):
        try:
            response = session.get(url, timeout=(5, 20), allow_redirects=False)
            if response.status_code not in RETRYABLE_STATUSES:
                response.raise_for_status()
                return response
            response.close()
            last_error = requests.HTTPError(
                f"retryable HTTP {response.status_code}", response=response
            )
        except requests.exceptions.SSLError:
            raise
        except requests.exceptions.ProxyError:
            raise
        except (
            requests.exceptions.ConnectTimeout,
            requests.exceptions.ReadTimeout,
            requests.exceptions.ConnectionError,
        ) as exc:
            last_error = exc

        if attempt < attempts:
            delay = 0.5 * (2 ** (attempt - 1)) + random.uniform(0, 0.1)
            time.sleep(delay)

    raise RuntimeError(f"{attempts}回の試行でリクエストに失敗しました") from last_error

def get_with_basic_retry(url: str, attempts: int = 3) -> requests.Response:
    with requests.Session() as session:
        session.trust_env = False
        return _get_with_basic_retry(session, url, attempts)


if __name__ == "__main__":
    response = get_with_basic_retry("http://127.0.0.1:8877/flaky")
    print("最終ステータス:", response.status_code)
    print("JSON:", response.json())
実行前に/resetを呼び、次を実行します。
python basic_retry.py
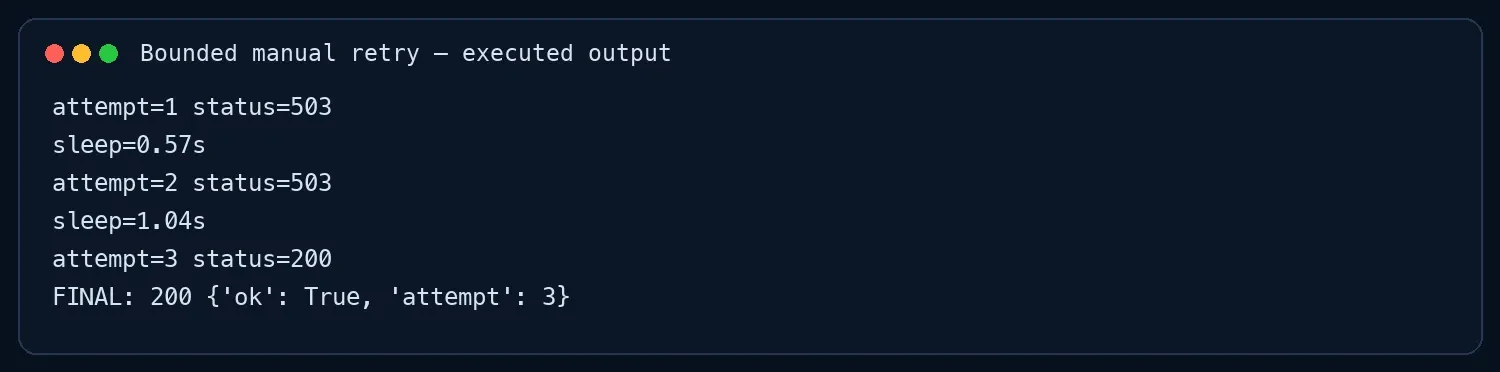
今回の検証では3回目で200になり、attempts=0はValueError、attempts=2は503が続いてRuntimeErrorになりました。これは試行回数の上限が働いた結果です。
SSLErrorとProxyErrorは、広いConnectionErrorより先に捕捉します。順序を逆にすると、証明書や認証の問題まで再試行対象に混ざるおそれがあります。この簡易ループは処理全体の厳密な締め切りや通知機能までは実装していません。また、本番ログに例外全体をそのまま保存するとURL等が含まれる場合があるため、出力項目を限定してください。
HTTPAdapterとRetryの主要パラメータ
| パラメータ | 本文の値 | 意味と限界 |
|---|---|---|
total |
4 | 全体の再試行上限。初回を加えて最大5回 |
connect |
4 | 接続段階の失敗に対する予算 |
read |
4 | urllib3の再試行経路で扱える読み取りエラーの予算 |
status |
4 | 再試行対象ステータスに対する予算 |
other |
0 | 未分類のエラーを自動再試行しない |
allowed_methods |
GET / HEAD / OPTIONS | 主にステータスと読み取りエラーの対象メソッドを制限 |
status_forcelist |
429、500、502、503、504 | 明示的に対象とするステータス |
raise_on_status |
False | 上限到達時は最終レスポンスを受け取り、アプリで判定 |
respect_retry_after_header |
True | 対応する応答のRetry-Afterを尊重 |
各分類の4回を足して16回になるわけではありません。totalも同時に上限として働きます。さらに、Retry-Afterがある場合の再試行判定はstatus_forcelistだけで決まるとは限りません。厳密なステータス制限が必要なら、使用バージョンの仕様とテストで確認します。
pool_connectionsは保持する接続プール数、pool_maxsizeは各プールで保持する接続数の設定です。デフォルトの非ブロッキング動作では、pool_maxsize=10をサービス全体の同時実行上限10と解釈できません。ワーカーやセマフォによる制御を別に行います。
read=4なのにReadTimeoutが再試行されないのはなぜですか?
Requestsがレスポンス本文を読み取る段階のエラーは、Adapterによる再送の範囲外になることがあります。 urllib3内でレスポンスを待っている段階と、その後Requestsが本文を消費する段階を区別してください。
後者ではReadTimeoutではなくConnectionErrorとして表面化する場合もあります。read=4は「ダウンロードが途中で切れたら必ず4回再開する」という意味ではありません。
アプリ側で全体を再実行するなら、Adapter側と合わせた回数・時間の予算を設けます。大きなファイルでは、サーバーが対応している場合に限りRangeリクエストや再開ダウンロードを使い、ETag等で同じ内容か確認します。何度も先頭から取得すると、転送量が膨らみます。
指数バックオフ・ジッター・Retry-Afterをどう組み合わせるか
指数バックオフは、連続失敗に応じて待機時間を延ばす方法です。ジッターは待機時間に乱数を加え、多数のワーカーが一斉に再送するのを抑えます。
urllib3 2.7.0でbackoff_factor=0.25、ジッターなし、Retry-Afterなしの通常の経路では、初回失敗後の待機は0秒、その後は0.5秒、1.0秒、2.0秒と増えます。手動ループの初回待機0.5秒とは同じではありません。backoff_maxは通常の指数バックオフの上限で、ジッターを加えた結果にも適用されます。Retry-Afterや処理全体の時間を一律に制限する設定ではありません。 詳細はurllib3のRetryリファレンスを使用バージョンに合わせて確認してください。
Retry-Afterが残り時間を超えたらどうする?
その場で再試行を打ち切るか、後のジョブに回します。たとえば残り10秒に対しRetry-After: 60なら、10秒後に前倒しで送信せず、今回のジョブを終了します。
RFC 9110のRetry-After定義では、秒数またはHTTP日時を指定できます。日時形式は時計のずれにも影響されるため、実行環境の時刻を同期してください。
次のretry_after.pyは、アプリ側で待機を判断するための補助関数です。
from datetime import datetime, timezone
from email.utils import parsedate_to_datetime


def retry_after_seconds(response):
    value = response.headers.get("Retry-After")
    if not value:
        return None
    value = value.strip()
    if value.isascii() and value.isdigit():
        return max(0.0, float(value))

    try:
        retry_at = parsedate_to_datetime(value)
    except (TypeError, ValueError, OverflowError):
        return None

    if retry_at.tzinfo is None:
        retry_at = retry_at.replace(tzinfo=timezone.utc)
    return max(0.0, (retry_at - datetime.now(timezone.utc)).total_seconds())
不正な値ではNoneを返します。呼び出し側は、停止・再スケジュール・保守的なバックオフのどれを使うか明示します。この関数は前述のAdapterへ自動接続されるものではありません。Adapterに待機を任せる方式と、max_retries=0にしてアプリが一元管理する方式を混ぜないでください。
Python Requestsでプロキシを使うときのリトライとエラー解決
プロキシ経由の失敗は、ゲートウェイ接続、認証、出口から先の通信、対象サイトの応答に分けて調べます。ProxyErrorだけでIP品質が悪いと断定しないことが重要です。
| 症状 | 確認順序 | 対処 |
|---|---|---|
| 接続拒否・ProxyError | ホスト→ポート→通信経路→サービス状態 | 一時的な接続障害と確認できた場合だけ限定的に再試行 |
| 407 | ユーザー名→パスワード→許可IP→予約文字 | 認証を修正。出口変更では通常解決しない |
| IP確認は成功、対象は403 | 認可→URL・要求内容→対象側の制限 | アクセス条件を見直す。拒否を避ける目的でIPを回し続けない |
| 429 | Retry-After→クォータ→同時実行数 | 待機・頻度低減・再スケジュール |
| 502・503・504 | ゲートウェイ由来か対象由来か | 識別できるログを残し、回数制限と遮断条件を適用 |
HTTPSのCONNECTトンネル確立時に認証が失敗すると、通常の407レスポンスではなくProxyErrorになる場合があります。記録するのはエラー分類や非機密のジョブIDなどに限定し、プロキシURL全体や認証ヘッダーを出力しないでください。
Rola IPとリトライを組み合わせる手順
Rola IPは通信経路を提供し、再試行コードは一時的な失敗を制御します。認証情報、対象APIの権限、レスポンスの内容、サーバー側の障害をプロキシだけで修正することはできません。以下は利用権限のある対象に接続するための設定例で、今回Rola IPの実回線テストは行っていません。
1. 接続情報を管理画面から取得する
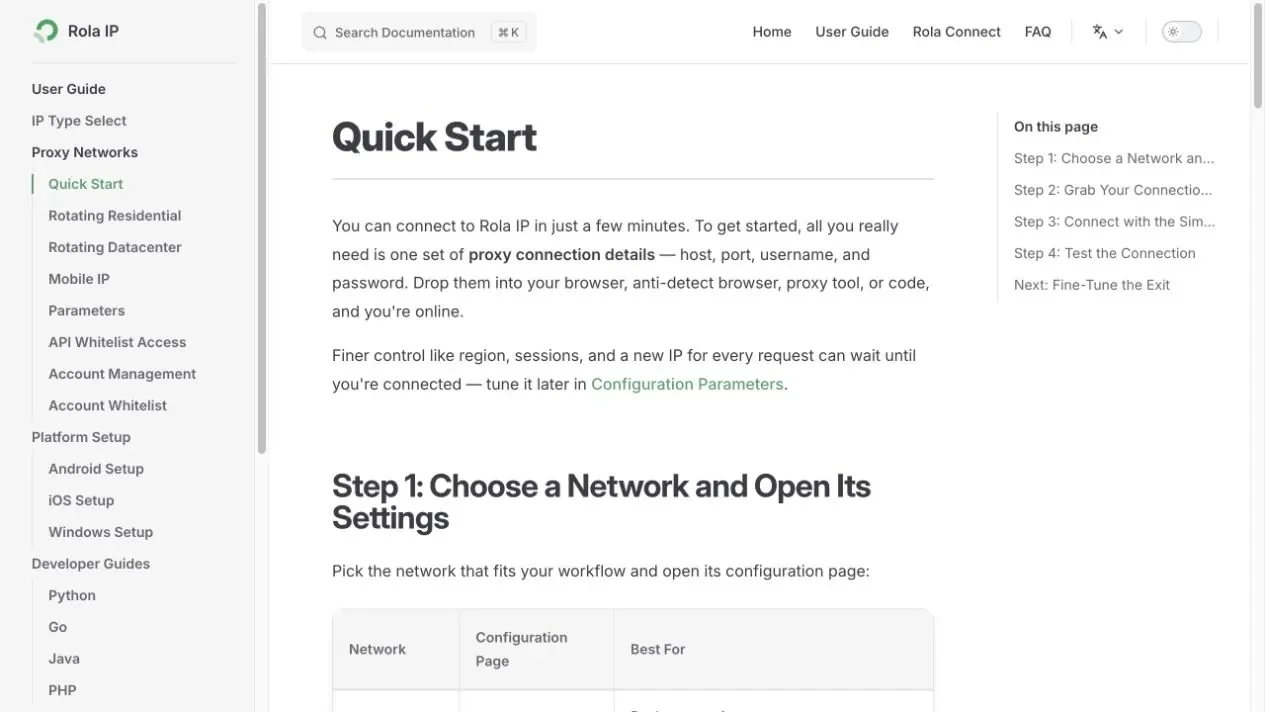
Rola IPの接続ガイドで対象ネットワークの設定画面を開き、ホスト、ポート、ユーザー名、パスワードを取得します。ユーザー名に地域やセッションの指定が含まれることがあるため、画面で生成された完全な値を使います。
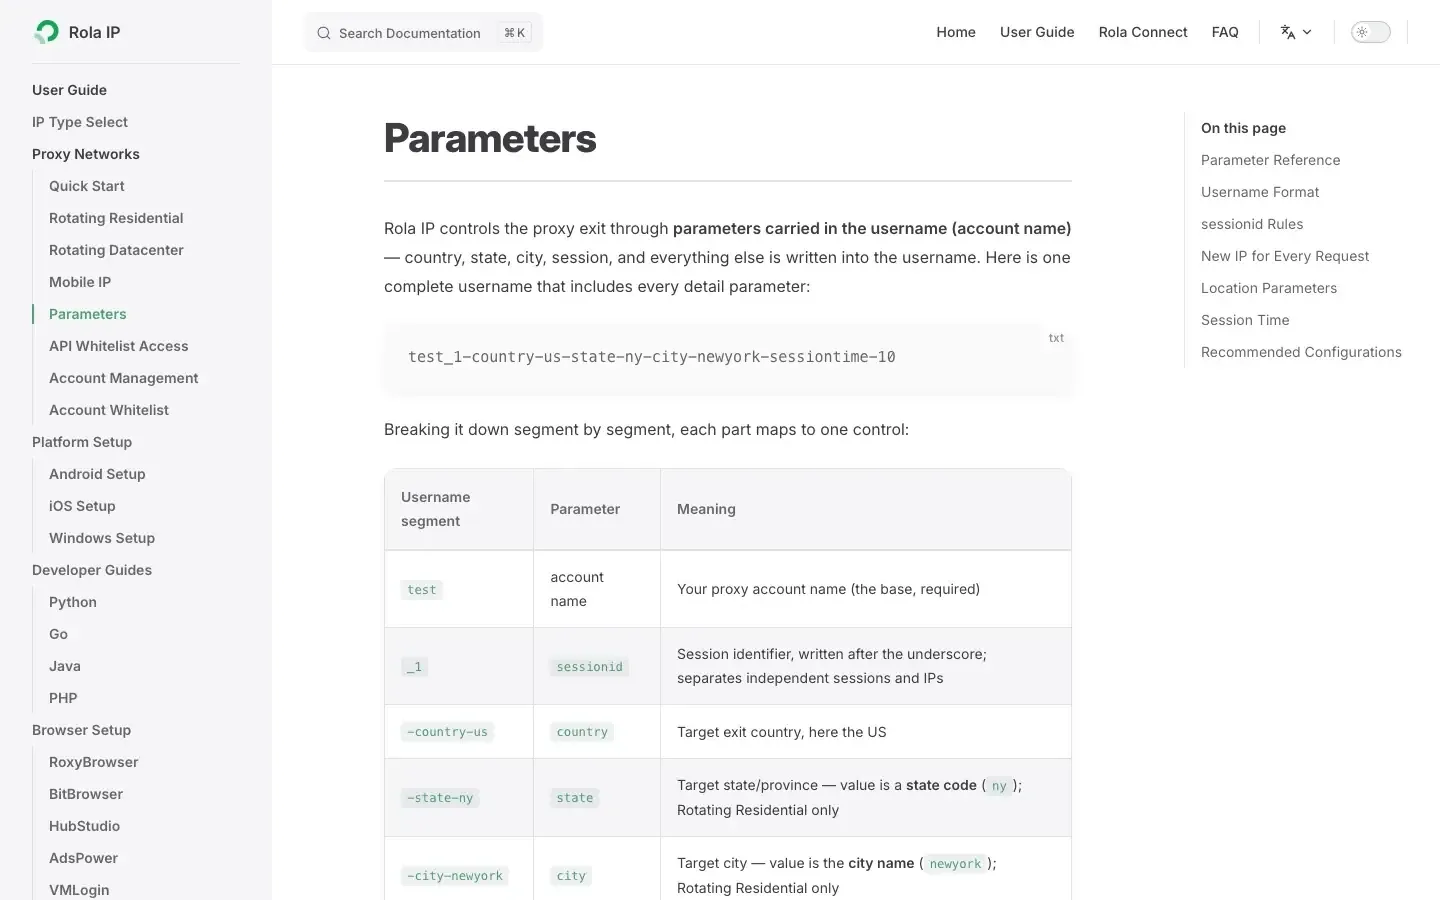
地域・セッションを追加指定する場合は、Rola IPの接続パラメータで対象製品の対応範囲を確認します。国や都市の指定は、APIの業務データやログイン状態を自動的に変更する機能ではありません。
2. 認証情報を環境変数に設定する
以下は置換が必要な例です。実際の認証情報を記事、Git、共有ログに保存しないでください。対話シェルでは履歴にも注意し、本番ではシークレット管理から注入します。
export ROLA_PROXY_HOST="proxy.example"
export ROLA_PROXY_PORT="1000"
export ROLA_PROXY_USERNAME="管理画面で生成した完全なユーザー名"
export ROLA_PROXY_PASSWORD="管理画面のパスワード"
PowerShellの場合:
$env:ROLA_PROXY_HOST="proxy.example"
$env:ROLA_PROXY_PORT="1000"
$env:ROLA_PROXY_USERNAME="管理画面で生成した完全なユーザー名"
$env:ROLA_PROXY_PASSWORD="管理画面のパスワード"
3. 出口IPを確認してから対象APIへ進む
次をproxy_check.pyとしてhttpadapter_demo.pyと同じ場所に保存します。初期診断では自動再試行を無効にし、認証やTLSの失敗を繰り返さない構成にしています。
import os
from urllib.parse import quote
import requests
from requests.adapters import HTTPAdapter


def build_proxy_url():
    names = ("ROLA_PROXY_HOST", "ROLA_PROXY_PORT",
             "ROLA_PROXY_USERNAME", "ROLA_PROXY_PASSWORD")
    if any(not os.environ.get(name) for name in names):
        raise ValueError("必要なプロキシ環境変数が未設定です")
    host = os.environ["ROLA_PROXY_HOST"]
    port = int(os.environ["ROLA_PROXY_PORT"])
    if not 1 <= port <= 65535 or any(c in host for c in "/@?# "):
        raise ValueError("ホストまたはポートを確認してください")
    username = quote(os.environ["ROLA_PROXY_USERNAME"], safe="")
    password = quote(os.environ["ROLA_PROXY_PASSWORD"], safe="")
    return f"http://{username}:{password}@{host}:{port}"


def main():
    try:
        proxy_url = build_proxy_url()
        with requests.Session() as session:
            session.trust_env = False
            session.mount("https://", HTTPAdapter(max_retries=0))
            response = session.get(
                "https://api64.ipify.org?format=json",
                proxies={"http": proxy_url, "https": proxy_url},
                timeout=(10, 30),
                allow_redirects=False,
            )
            if response.status_code != 200:
                raise SystemExit(f"停止: HTTP {response.status_code}")
            if "application/json" not in response.headers.get("Content-Type", ""):
                raise ValueError("JSON以外の応答です")
            data = response.json()
            import ipaddress
            ipaddress.ip_address(data["ip"])
            print("出口確認サービスへの接続に成功しました。IPはログに出力していません。")
    except requests.exceptions.ProxyError:
        raise SystemExit("停止: プロキシ接続または認証を確認してください") from None
    except requests.exceptions.SSLError:
        raise SystemExit("停止: TLS証明書とCA設定を確認してください") from None
    except requests.exceptions.Timeout:
        raise SystemExit("停止: 通信がタイムアウトしました") from None
    except requests.RequestException:
        raise SystemExit("停止: 通信エラーが発生しました") from None
    except (ValueError, KeyError, TypeError):
        raise SystemExit("停止: 環境変数または応答データを確認してください") from None


if __name__ == "__main__":
    main()
python proxy_check.py
成功時の表示は出口確認用サービスに接続できたことだけを示します。対象APIへのアクセス権、地理情報、固定IPの継続性まで証明するものではありません。必要ならIPを非公開環境で別途確認し、実際の出口・国・セッション継続を記録します。
http://のプロキシURLは、プロキシへの接続方式を表します。HTTPSサイトへは通常CONNECTトンネルを張りますが、プロキシゲートウェイとの接続自体がTLSで保護されるとは限りません。 対象がHTTPSでも、HTTPプロキシへの認証を含むすべての区間が暗号化されると考えないでください。対応方式は利用するサービスで確認します。
RequestsのSessionは接続プールやCookieを再利用します。出口の維持には、製品側のスティッキーセッションや固定IPの契約条件が別途必要です。ログインを伴う一連の操作では同じ出口が必要か確認し、独立した要求であっても必要がなければローテーションしません。用途の整理にはRola IPのWebスクレイピング向けプロキシも参照できます。
再試行とプロキシ切り替えの回数・通信量を計算する
最大3つの出口を順番に使い、それぞれ初回に加えて4回再試行する設計なら、1ジョブの上限は次のとおりです。
3 ×(初回1回+再試行4回)=最大15試行
50ジョブ × 15試行=累計最大750試行
これは750件の同時通信を意味しません。また、接続前に失敗した試行は対象サーバーまで届かないことがあります。累計試行数、実行中リクエスト数、毎秒の要求数、対象から受け取った応答数を分けて計測します。
通信量の概算は「試行数×1試行の平均転送量」が出発点です。本文の途中まで受信して失敗した場合や、プロキシ側の計測範囲で変わるため、実際の課金対象と失敗通信の扱いを確認します。キュー、アプリ、Adapter、プロキシ切り替えの各層が独立に再試行すると、回数が掛け算で増えます。全体予算を管理する責任を一か所に集約してください。
ScrapyのRetryMiddlewareはRequestsとは別に設定する
Scrapyを使用するプロジェクトでは、RetryMiddlewareの公式ドキュメントに従って設定します。以下はSpiderのクラス内に置く設定例で、Requestsに適用するコードではありません。
custom_settings = {
    "RETRY_ENABLED": True,
    "RETRY_TIMES": 2,
    "RETRY_HTTP_CODES": [429, 500, 502, 503, 504],
}
RETRY_TIMES=2は初回に加えて最大2回の再試行です。この指定だけでRequestsの例と同じバックオフ、ジッター、Retry-After、プロキシ復旧が実装されるわけではありません。特に429を含めるなら待機を管理する仕組みを別途設け、使用バージョンのミドルウェア動作を確認します。本記事ではScrapyの実行検証は行っていません。
よくある実装ミスと修正方針
| ミス | 修正方針 |
|---|---|
| 403・407・503を同じルールで再試行 | 権限、プロキシ認証、一時的障害を分ける |
| リトライだけ設定し、timeoutを省略 | 接続・読み取り待機とジョブ全体の期限を設ける |
| Sessionを使えば出口が固定されると考える | 製品のセッション設定と実際の出口変化を確認 |
| POSTを機械的に再送 | 冪等性キー、重複排除、操作IDによる結果照会を用意 |
| 最終失敗を握りつぶす | 上位層へ失敗を伝え、試行数、経過時間、最終状態を記録 |
| 200ならそのまま保存 | Content-Type、必須フィールド、業務状態を検証 |
継続的に失敗する場合は、一定時間新規要求を停止するサーキットブレーカーも検討します。エラーを無期限に再試行して成功率を見かけ上高くするより、停止理由が分かる設計のほうが運用に役立ちます。
用途別の初期設定の目安
用途 |
再試行回数 |
接続/読み取り待機 |
対象候補 |
補足 |
|---|---|---|---|---|
低頻度の読み取りAPI |
2〜3回 |
(3, 15) |
429、500、502、503、504 |
Retry-AfterとAPI契約を確認 |
許可されたバッチ取得 |
3〜4回 |
(5, 30) |
同上 |
同時実行・全体期限・通信量を制限 |
プロキシ初期診断 |
0回から開始 |
(10, 30) |
原因確認後に判断 |
一時障害なら1〜2回を検討。407は認証修正 |
書き込みAPI |
原則0回 |
APIの処理時間に合わせる |
契約次第 |
冪等性が保証される場合に個別設計 |
数値は初期検討用であり、サービス共通の推奨値ではありません。遅延、失敗率、上流の制限、予算を測って調整します。今回のローカル例でも、待機と試行回数は確認できましたが、外部サイトに対する成功率は測定していません。
まとめ
Python Requestsのリトライは、再試行対象、回数、待機時間、再送の安全性を明示して実装します。HTTPAdapterとRetryを起点に、429のRetry-After、本文読み取りの失敗、POSTの重複実行まで考慮すると、失敗時の動作を予測しやすくなります。
プロキシを使う場合も、通信経路の問題と対象サイトの問題を切り分け、キュー・アプリ・Adapterを通じた予算を統一します。まずローカルで成功・上限到達・再試行対象外の動作を確認し、その後、許可された接続先で小規模に検証してください。