
Redditスクレイピングのやり方|Pythonで投稿・コメントを取得してCSVに保存する方法
2026年10月15日 · ガイド · 約20分で読める
Redditスクレイピングで投稿やコメントを継続的に収集するなら、利用が承認されたReddit Data APIとPythonライブラリのPRAWを使う方法が基本です。投稿IDや返信先のIDを残しておけば、話題の傾向だけでなく、どの発言にどの返信がついたかも分析できます。
本記事では、Reddit APIの使い方から、サブレディット内の投稿取得、キーワード検索、コメントと返信の収集、CSV出力までを順に説明します。公開ページのHTML解析や、Rola-IPのプロキシを組み込む場合の設定も扱います。
Redditスクレイピングで最初に押さえるポイント
構造化データを取得する場合は、承認済みのAPIアプリケーションをPRAWから利用します。コメントの出力件数と追加取得の回数は別々に管理し、取得範囲を記録することが重要です。
- 取得方法: まずAPIの利用承認と認証情報を確認します。PRAWの導入だけでは利用許可を得たことにはなりません。
- 返信の構造:
post_id、comment_id、parent_idを保存します。 - 日時: 投稿日時と収集日時をUTCで記録します。
- APIの負荷: コメントを50件だけCSVに保存しても、事前の展開処理で多くのリクエストが発生する場合があります。
- プロキシの役割: 通信の出口を変更するための設定です。APIの利用権限や割り当てられた上限は増えません。
掲載する完全版スクリプトは、Windows・Python 3.12.10でオフラインの合成データを使って確認しています。
Redditから取得できるデータと活用例
Redditでは、サブレディットの公開情報、投稿、コメント、返信などを取得できます。ただし、取得できる範囲は利用権限や公開状態によって異なり、画面上のコメント数とCSVの行数が一致するとは限りません。
| 対象 | 主な項目 | 活用例 |
|---|---|---|
| サブレディット | 名前、説明、メンバー数、公開属性 | 調査対象の選定、コミュニティの特徴の把握 |
| 投稿 | タイトル、本文、投稿者、投稿日時、スコア、コメント数、URL | 話題の調査、コンテンツ動向の把握、課題の分類 |
| コメント・返信 | 本文、投稿者、日時、スコア、post_id、parent_id |
フィードバック分析、会話の構造や頻出する質問の把握 |
| ユーザーの公開活動 | 公開投稿・コメントとそのリンク | 承認済みの範囲内での公開情報の分析 |
スコアやコメント数は取得後も変化します。また、削除済みの内容や運営側が削除した内容は取得できない場合があります。出典を後から確認できるように、各行には元のURL、収集日時、サブレディット名を残しておきます。
後述の完全版スクリプトでは、初期設定で投稿者名を出力しません。承認された目的に必要な場合だけ有効にし、収集前に保存期間と削除依頼への対応方法を決めておきます。
Redditスクレイピングの方法を比較:API・HTML解析・ノーコード
継続的に投稿や返信を収集するなら、項目が安定し、エラーの原因も追いやすいData APIとPRAWの組み合わせが適しています。少数の公開ページを確認する用途では、許可された範囲でHTML解析やノーコードツールを検討できます。
| 方法 | 適した用途 | 確認すべき点 |
|---|---|---|
| Data API+PRAW | 承認済みのOAuth認証情報を使った定期収集・一括出力 | 公式のレート制限を守ります。オブジェクトの扱いやページ送りはPRAWが支援します |
| HTML+BeautifulSoup | 閲覧が許可された少数の公開ページから、表示情報を確認 | ページの実内容とセレクターを確認します。HTML構造の変更に影響されやすい方法です |
| ノーコードのテンプレート | URLが分かっている少数の投稿をExcelやCSVに出力 | 対応URL、返信の階層、出力項目を事前に確認します |
HTTPステータスが200でも、投稿の代わりにログイン画面やアクセス確認画面が返ることがあります。ステータスコードだけで取得成功と判断せず、必要な投稿データが含まれているかを確認してください。
方式の選定については、スクレイピングとAPIの違いも参考になります。投稿・コメント・返信関係を構造化して取得する場合は、以下のAPIを使う手順を基本にしてください。
実行前に、Reddit Data API利用規約、承認済みの用途、データ保存に関する要件を確認します。
Reddit APIの使い方:PythonとPRAWの準備・認証確認
PRAWを使うには、Python 3.10以降と、用途に適したRedditの認証情報が必要です。接続確認では実際に投稿一覧を取得し、APIから応答が返ることを確かめます。
PRAWをインストールして認証情報を設定する
- Python 3.10以降を用意します。
- Redditの現行の申請手順に従い、外部スクリプトでの利用に適した認証情報を取得します。
- クライアントID、クライアントシークレット、用途を識別できるUser-Agentを用意します。
- 認証情報は環境変数またはシークレット管理ツールから渡します。
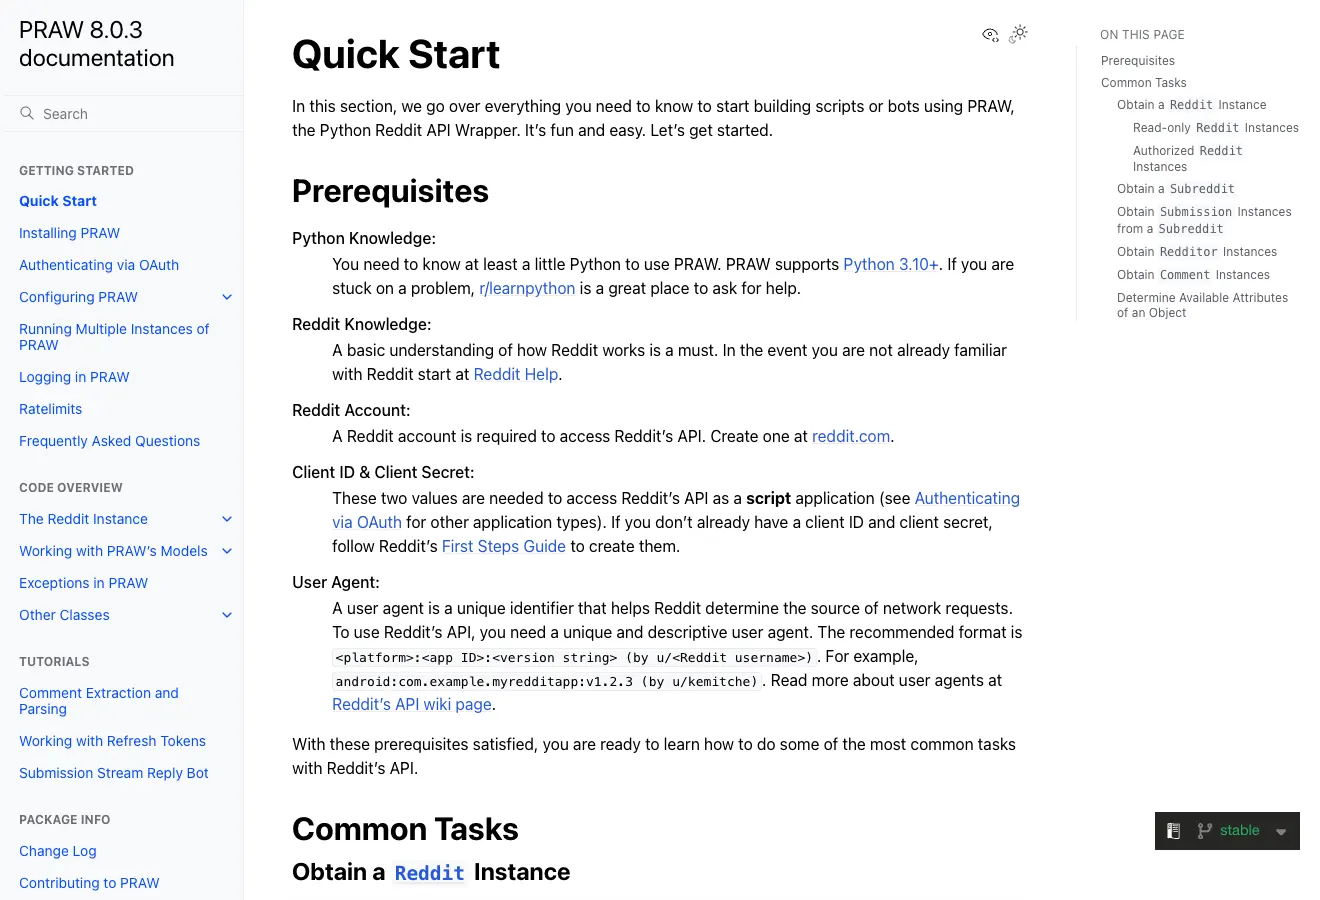
図1:PRAWのクイックスタートに掲載された認証情報の説明です。
認証項目と読み取り専用インスタンスの設定は、PRAWクイックスタートで確認できます。
以下はmacOS・Linux向けのコマンドです。PowerShellでは、$env:REDDIT_CLIENT_ID="your_client_id"の形式を使い、REDDIT_CLIENT_SECRETとREDDIT_USER_AGENTも同様に設定します。サンプルの値はプレースホルダーです。実際の秘密情報を、履歴に残るコマンドへ直接入力することは避けてください。
コード1:依存パッケージのインストールと環境変数の設定
python -m pip install beautifulsoup4==4.15.0 certifi==2026.7.22 charset-normalizer==3.5.1 defusedxml==0.7.1 idna==3.20 praw==8.0.3 prawcore==4.0.0 requests==2.34.2 soupsieve==2.10 typing_extensions==4.16.0 update_checker==1.0.0 urllib3==2.8.0 websocket-client==1.9.2
export REDDIT_CLIENT_ID="your_client_id"
export REDDIT_CLIENT_SECRET="your_client_secret"
export REDDIT_USER_AGENT="macos:research-export:1.0 (by u/your_name)"
投稿を1件取得してAPI接続を確認する
コード2:APIへのアクセス確認
import os
import praw

reddit = praw.Reddit(
    client_id=os.environ["REDDIT_CLIENT_ID"],
    client_secret=os.environ["REDDIT_CLIENT_SECRET"],
    user_agent=os.environ["REDDIT_USER_AGENT"],
    timeout=20,
    ratelimit_seconds=0,
    check_for_updates=False,
)
try:
    posts = list(reddit.subreddit("Python").new(limit=1))
    if posts:
        print("API returned post:", posts[0].id)
    else:
        print("Listing returned no posts; inspect scope and community.")
except Exception as exc:
    # Avoid printing raw exception URLs or credentials.
    print("API check failed:", type(exc).__name__)
    raise SystemExit(1)
サブレディット名を表示できただけでは接続確認になりません。PRAWは、データを取得せずに名前を保持できるためです。この例では投稿一覧を実際に読み込み、取得できた投稿のIDを表示します。
結果が空でも、認証エラーとは限りません。対象コミュニティや取得範囲を確認します。401・403が返る場合は、アプリケーションの承認状況、認証情報、許可された範囲から調べてください。
PythonでRedditの投稿を取得する方法:並び順とページネーション
サブレディットの投稿一覧は、PRAWのnew、hot、topなどで取得できます。ページ送りはPRAWがAPIのカーソルを使って処理するため、ページ番号付きのURLを手作業で組み立てる必要はありません。
- 対象と並び順を決めます。 新着なら
new、現在の人気順ならhot、期間内の高スコア投稿ならtopを使います。 - 期間と件数を設定します。
topではweekやmonthを指定できます。limitを大きくする場合も、承認済みの利用枠を守ります。 - 出典をたどれる項目を保存します。 投稿ID、本文、URL、投稿日時などを記録します。
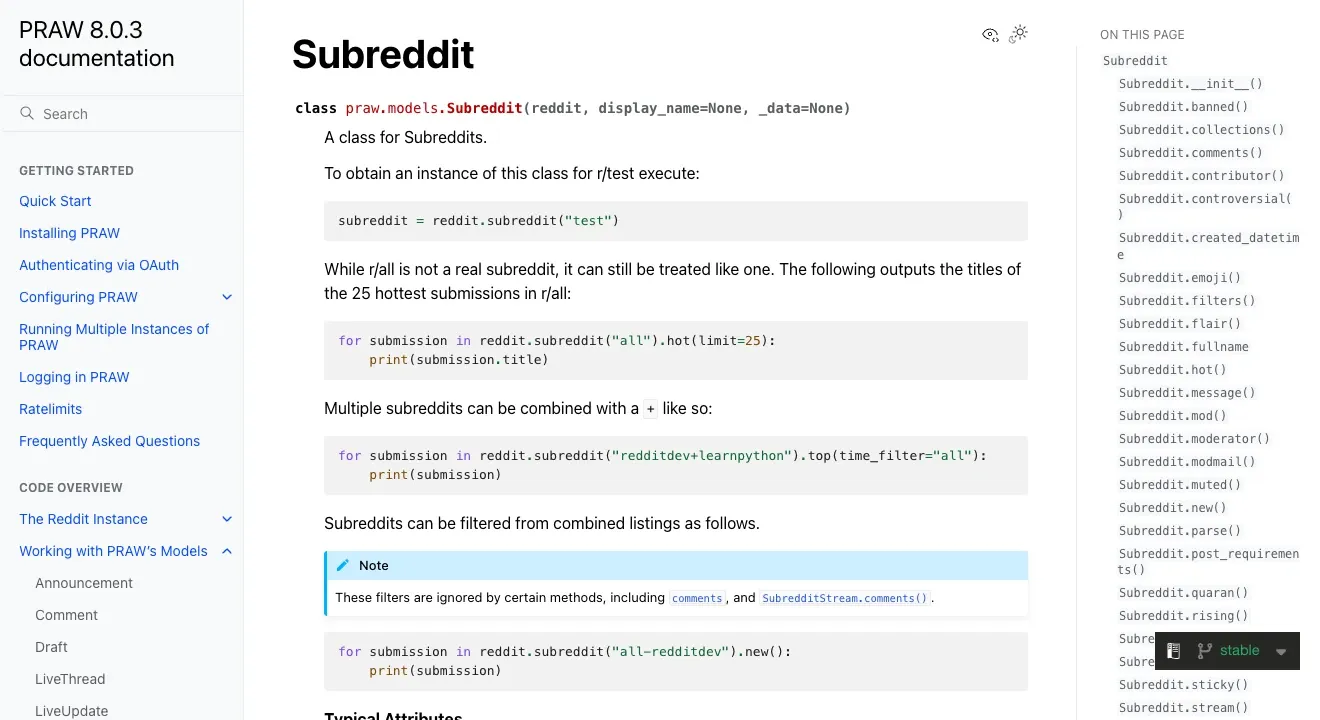
図2:投稿一覧や検索の入口となるPRAWのSubredditドキュメントです。
コード3:新着投稿と、今週の高スコア投稿を取得する
subreddit = reddit.subreddit("Python")
for post in subreddit.new(limit=10):
    print(post.id, post.title, post.score, post.num_comments)

for post in subreddit.top(time_filter="week", limit=10):
    print(post.id, post.title)
投稿だけが必要なら、コメントを展開する処理は不要です。タイトル、本文、リンク先URLは別々の項目として扱います。
selftext:テキスト投稿の本文です。リンク投稿では空の場合があります。url:投稿で指定されたリンク先やメディアのURLです。permalink:Reddit上の投稿ページへのリンクです。
本文が空でも、投稿自体が空とは限りません。本文とURLの両方を保存しておくと、分析時の誤判定を防げます。
コード4:投稿の主要項目を取り出す
from datetime import datetime, timezone

row = {
    "post_id": post.id,
    "title": post.title,
    "body": post.selftext or "",
    "url": post.url,
    "permalink": "https://www.reddit.com" + post.permalink,
    "created_at_utc": datetime.fromtimestamp(post.created_utc, timezone.utc).isoformat(),
}
Redditの投稿をキーワード検索で取得する方法
特定の話題を調べる場合は、サブレディットを絞ってsearch()を使います。検索結果は過去の全投稿を網羅するアーカイブではないため、最初に数件を確認してから取得件数を増やします。
- 調査対象のサブレディットを選びます。
- 検索語、並び順、期間を指定します。
- 結果の関連性を確認し、必要な範囲で件数を調整します。
コード5:過去1か月の投稿をキーワードで検索する
results = reddit.subreddit("Python").search(
    "proxy", sort="new", time_filter="month", limit=20)
for post in results:
    print(post.id, post.title, post.permalink)
proxyは検索語の例です。実際には調査テーマに合う語句へ置き換えてください。検索結果は、インデックスの状況、閲覧権限、削除の有無などに左右されます。複数のコミュニティを比較するときは、検索条件をそろえて記録します。
投稿IDから本文とサブレディットの公開情報を取得する
投稿IDが分かっている場合は、reddit.submission(id=...)で直接取得できます。特定のスレッドを確認する用途では、投稿一覧から探し直すよりも対象を明確に指定できます。
投稿IDは、URLの/comments/に続く識別子です。idにはURL全体を渡しません。コミュニティの背景も必要なら、サブレディットの公開説明などを別途取得します。コミュニティによっては、一部の項目が空になることがあります。
コード6:単一投稿とコミュニティの公開情報を取得する
post = reddit.submission(id="replace_with_post_id")
print(post.title)
print(post.selftext)
print(post.url)
print(post.score, post.num_comments)

community = reddit.subreddit("Python")
print(community.display_name, community.public_description)
PythonでRedditのコメントを取得する方法:返信の階層を残す
コメントと返信は、展開回数を制限して読み込み、post_id・comment_id・parent_idを保存します。この3項目があれば返信関係をたどれますが、件数制限によって親コメントが出力対象から外れる場合があります。
- 対象の投稿を読み込みます。
replace_more(limit=2)などで追加取得の上限を指定します。追加取得を行わない場合はlimit=0を使います。comments.list()でコメントツリーを平坦な一覧にし、必要な項目を保存します。
MoreCommentsは、まだ読み込んでいないコメント群を表すプレースホルダーです。replace_more()はこれを展開し、追加のコメントを取得します。
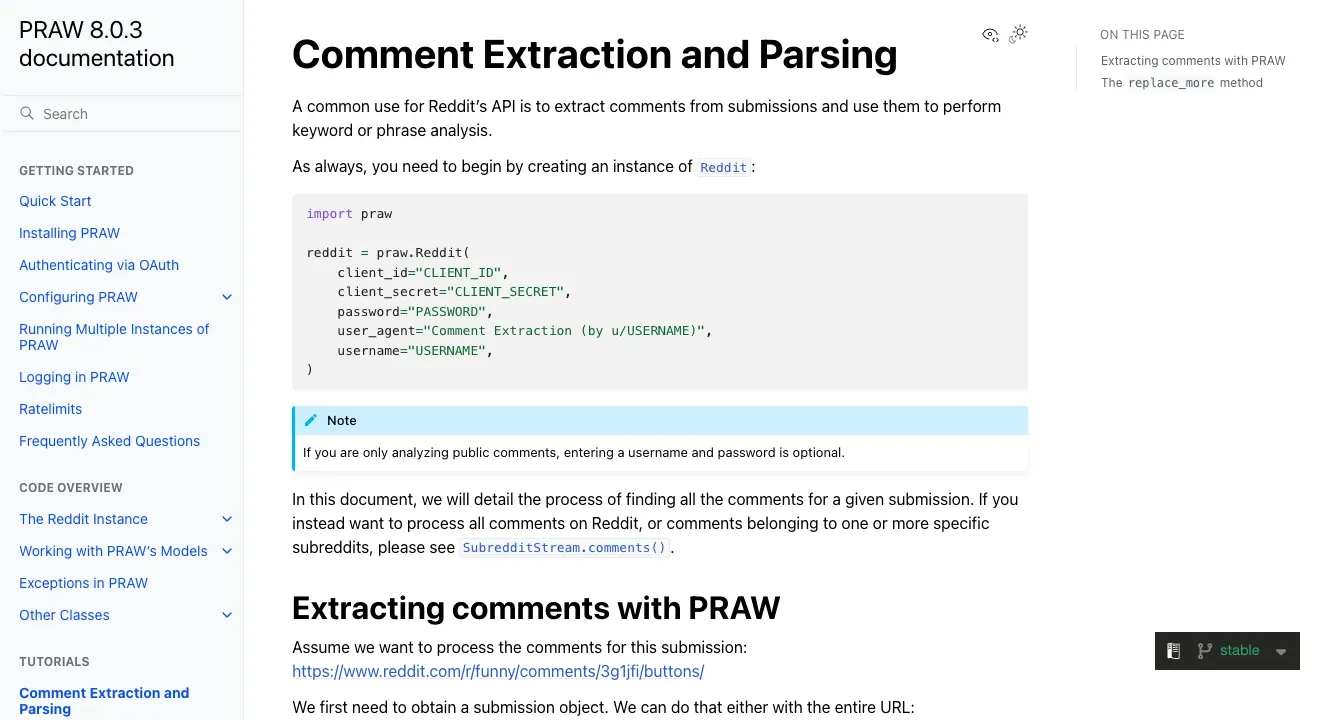
図3:クライアント設定や投稿の読み込みを説明するPRAWのコメント取得ドキュメントです。
コード7:コメントを展開し、返信先のIDを保存する
post = reddit.submission(id="replace_with_post_id")
post.comments.replace_more(limit=2)
for comment in post.comments.list()[:50]:
    print({
        "post_id": post.id,
        "comment_id": comment.id,
        "parent_id": comment.parent_id,
        "body": comment.body,
        "permalink": "https://www.reddit.com" + comment.permalink,
    })
| 設定・項目 | 意味 | 注意点 |
|---|---|---|
replace_more(limit=0) |
追加取得せず、プレースホルダーを除去します | 読み込み済みの範囲に限られます |
replace_more(limit=2) |
プレースホルダーの展開数に上限を設けます | 総HTTPリクエスト数の上限ではありません |
replace_more(limit=None) |
可能な限り展開を試みます | 大規模なスレッドでは追加リクエストが増え、時間がかかります |
comments.list()[:50] |
展開後の一覧から最大50件を取り出します | すでに発生した展開処理の通信量は減りません |
parent_idのt3_ |
親が投稿であることを示します | 通常、投稿に直接ついたコメントです |
parent_idのt1_ |
親がコメントであることを示します | コメントへの返信です |
投稿者名は必要な場合だけ保存し、削除された内容の復元は試みません。parent_idを残していても、対応する親の行がCSV内に存在するとは限らない点にも注意してください。
詳しい仕様は、PRAWのコメント取得・解析ガイドで確認できます。
Redditの投稿・コメントをCSVに保存する完全版スクリプト
投稿とコメントは、1投稿につき1行のreddit_posts.csvと、1コメントにつき1行のreddit_comments.csvに分けて保存すると扱いやすくなります。2つのファイルはpost_idで結合し、返信の階層はparent_idで確認します。
以下には、インポート、設定、CSV出力、エラー処理をまとめています。UTF-8のファイルreddit_scraper_v2.pyとして保存してください。前のコード例をつなぎ合わせる必要はありません。
コード8:CSV出力用の完全版スクリプト
"""Small authorized Reddit exports. No credentials or raw exception URLs are logged."""
import argparse
import csv
import json
import logging
import os
import sys
import time
from datetime import datetime, timezone
from pathlib import Path

import praw
import requests

POST_FIELDS = ["subreddit", "post_id", "title", "body", "author", "created_at_utc",
               "collected_at_utc", "score", "num_comments", "url", "permalink"]
COMMENT_FIELDS = ["subreddit", "post_id", "comment_id", "parent_id", "body",
                  "author", "created_at_utc", "collected_at_utc", "score", "permalink"]


def utc(seconds=None):
    return datetime.fromtimestamp(seconds if seconds is not None else time.time(),
                                  timezone.utc).isoformat()


def post_row(post, include_authors=False):
    return dict(subreddit=post.subreddit.display_name, post_id=post.id,
                title=post.title, body=post.selftext or "",
                author=str(post.author) if include_authors and post.author else "",
                created_at_utc=utc(post.created_utc), collected_at_utc=utc(),
                score=post.score, num_comments=post.num_comments, url=post.url,
                permalink="https://www.reddit.com" + post.permalink)


def comment_row(comment, post, include_authors=False):
    return dict(subreddit=post.subreddit.display_name, post_id=post.id,
                comment_id=comment.id, parent_id=comment.parent_id, body=comment.body,
                author=str(comment.author) if include_authors and comment.author else "",
                created_at_utc=utc(comment.created_utc), collected_at_utc=utc(),
                score=comment.score, permalink="https://www.reddit.com" + comment.permalink)


def safe_cell(value):
    # Protect spreadsheet users from untrusted formula-like text.
    if isinstance(value, str) and value.lstrip().startswith(("=", "+", "-", "@")):
        return "'" + value
    return value


def write_csv(path, fields, rows):
    with path.open("w", encoding="utf-8-sig", newline="") as handle:
        writer = csv.DictWriter(handle, fieldnames=fields)
        writer.writeheader()
        writer.writerows({key: safe_cell(value) for key, value in row.items()} for row in rows)


def make_client():
    # Library retry messages may include request details; emit only our sanitized errors.
    logging.getLogger("prawcore").disabled = True
    logging.getLogger("praw").disabled = True
    names = ["REDDIT_CLIENT_ID", "REDDIT_CLIENT_SECRET", "REDDIT_USER_AGENT"]
    if any(not os.environ.get(name) for name in names):
        raise ValueError("Set REDDIT_CLIENT_ID, REDDIT_CLIENT_SECRET and REDDIT_USER_AGENT.")
    session = requests.Session()
    session.trust_env = False  # Explicit proxy configuration; no accidental inherited route.
    proxy = os.environ.get("ROLA_PROXY_URL")
    if proxy:
        if not proxy.startswith(("http://", "https://")):
            raise ValueError("ROLA_PROXY_URL must be an HTTP(S) proxy URL.")
        session.proxies.update(http=proxy, https=proxy)
    return praw.Reddit(client_id=os.environ[names[0]], client_secret=os.environ[names[1]],
                       user_agent=os.environ[names[2]], requestor_kwargs={"session": session},
                       timeout=20, ratelimit_seconds=0, check_for_updates=False)


def export(reddit, args):
    # Refuse to overwrite an existing export, including one from a failed attempt.
    folder = Path(args.output_dir)
    folder.mkdir(parents=True, exist_ok=False)
    posts, comments = [], []
    start = time.monotonic()
    state = {"status": "running", "started_at_utc": utc(),
             "mode": "single" if args.post_id else "search" if args.query else "new",
             "post_limit": args.limit, "comments_per_post": args.comments_per_post,
             "more_limit": args.more_limit, "include_authors": args.include_authors,
             "proxy_enabled": bool(os.environ.get("ROLA_PROXY_URL")),
             "coverage": "bounded sample; not a complete archive"}
    failure = None
    try:
        if args.post_id:
            source = [reddit.submission(id=args.post_id)]
        elif args.query:
            source = reddit.subreddit(args.subreddit).search(
                args.query, sort="new", time_filter="month", limit=args.limit)
        else:
            source = reddit.subreddit(args.subreddit).new(limit=args.limit)
        for post in source:
            if time.monotonic() - start >= args.max_seconds:
                state["status"] = "stopped_at_time_budget"
                break
            posts.append(post_row(post, args.include_authors))  # Forces server attributes.
            if args.comments_per_post:
                post.comments.replace_more(limit=args.more_limit)
                for comment in post.comments.list()[:args.comments_per_post]:
                    comments.append(comment_row(comment, post, args.include_authors))
        else:
            state["status"] = "completed" if posts else "completed_empty"
    except Exception as exc:
        failure = exc
        state["status"] = "failed_partial"
        state["error_type"] = type(exc).__name__
        response = getattr(exc, "response", None)
        if response is not None:
            state["http_status"] = response.status_code
            state["retry_after"] = response.headers.get("Retry-After")
    finally:
        write_csv(folder / "reddit_posts.csv", POST_FIELDS, posts)
        write_csv(folder / "reddit_comments.csv", COMMENT_FIELDS, comments)
        state.update(finished_at_utc=utc(), posts=len(posts), comments=len(comments))
        (folder / "run_metadata.json").write_text(json.dumps(state, indent=2), encoding="utf-8")
    if failure:
        # Do not print exception messages that can contain credentials or URLs.
        print("Export stopped: " + type(failure).__name__ +
              ". Inspect run_metadata.json; partial files are not a successful run.", file=sys.stderr)
        return 1
    print(json.dumps(state, indent=2))
    return 0 if state["status"] in ("completed", "completed_empty") else 2


def parser():
    result = argparse.ArgumentParser(description=__doc__)
    mode = result.add_mutually_exclusive_group()
    mode.add_argument("--query")
    mode.add_argument("--post-id")
    result.add_argument("--subreddit", default="Python")
    result.add_argument("--limit", type=int, default=10)
    result.add_argument("--comments-per-post", type=int, default=50)
    result.add_argument("--more-limit", type=int, default=0)
    result.add_argument("--max-seconds", type=int, default=120)
    result.add_argument("--include-authors", action="store_true")
    result.add_argument("--output-dir", default="reddit_output")
    return result


def main():
    arg_parser = parser()
    args = arg_parser.parse_args()
    for name, low, high in [("limit", 1, 100), ("comments_per_post", 0, 500),
                            ("more_limit", 0, 10), ("max_seconds", 1, 600)]:
        if not low <= getattr(args, name) <= high:
            arg_parser.error(f"{name} must be between {low} and {high}")
    try:
        with make_client() as reddit:
            return export(reddit, args)
    except ValueError as exc:
        print(str(exc), file=sys.stderr)
    except FileExistsError:
        print("Output directory already exists. Choose a new --output-dir.", file=sys.stderr)
    except Exception as exc:
        print("Stopped: " + type(exc).__name__, file=sys.stderr)
    return 1


if __name__ == "__main__":
    raise SystemExit(main())
CSV出力の実行方法:一覧・検索・単一投稿の3モード
スクリプトを保存したフォルダーでターミナルを開き、設定済みのPython環境と認証情報を使って実行します。実行のたびに、新しい出力先ディレクトリを指定してください。
POST_IDは、コード2などで取得した、アクセスが許可された投稿IDへ置き換えます。既定のサブレディットはPythonです。一覧取得と検索では、--subreddit NAMEで変更できます。
python reddit_scraper_v2.py --limit 10 --comments-per-post 0 --output-dir reddit_posts_run
python reddit_scraper_v2.py --query proxy --limit 10 --more-limit 2 --output-dir reddit_search_run
python reddit_scraper_v2.py --post-id POST_ID --more-limit 2 --output-dir reddit_thread_run
| 実行例 | 処理内容 |
|---|---|
| 1行目 | 新着投稿を最大10件取得し、コメントは取得しません |
| 2行目 | 過去1か月の投稿をproxyで検索し、投稿ごとのコメント展開上限を2に設定します |
| 3行目 | 指定した1投稿のコメントを、展開上限2で取得します |
取得件数と処理時間の設定
| オプション | 既定値 | 指定できる範囲・役割 |
|---|---|---|
--limit |
10 |
一覧・検索の投稿件数です。1〜100を指定できます |
--comments-per-post |
50 |
投稿ごとに出力するコメントの上限です。0〜500を指定できます |
--more-limit |
0 |
投稿ごとのMoreComments展開上限です。0〜10を指定できます |
--max-seconds |
120 |
投稿の処理間で確認する経過時間の目安です。1〜600秒を指定できます |
--include-authors |
無効 | 指定すると、取得可能な投稿者名を出力します |
--output-dir |
reddit_output |
新規作成する出力先です。既存ディレクトリへの上書きは行いません |
--max-secondsは、処理を必ず指定秒数で打ち切る設定ではありません。次の一覧ページの取得、処理中の投稿、ライブラリ内の待機などによって、指定時間を超える場合があります。
CSVと実行結果を確認する
出力先には2つのCSVとrun_metadata.jsonが作成されます。分析へ進む前に、各CSVの先頭5行を確認します。5行未満なら全行を確認してください。
- 投稿とコメントの
post_idが対応しているか。 parent_idが投稿または返信先のコメントを示しているか。親の行が欠けている場合は、取得範囲の制限も確認します。created_at_utcが、+00:00のオフセットを持つISO 8601形式になっているか。permalinkから元のスレッドを開けるか。- メタデータに記録された状態と行数が、意図した結果に合っているか。
| メタデータの状態 | 意味 |
|---|---|
completed |
設定した範囲の処理が完了しました。全履歴の取得を意味するものではありません |
completed_empty |
投稿一覧が空でした。目的のデータを取得できた証明にはなりません |
stopped_at_time_budget |
投稿の処理間で時間上限に達し、処理を停止しました |
failed_partial |
途中で失敗しました。保存済みの行は部分的な結果です |
途中で失敗した場合も、それまでに取得した行を保存し、異常終了します。CSVが存在するだけで成功と判断しないでください。scoreとnum_commentsは取得時点の値で、その後も変わります。
CSVの文字コードはutf-8-sigです。また、表計算ソフトが数式として解釈しそうな文字列には、先頭にアポストロフィを付けます。
APIを使わずにRedditをスクレイピングする方法と限界
公開ページの取得が許可され、画面に表示される項目だけで足りる場合は、BeautifulSoupでHTMLを解析できます。ただし、Redditの動的な画面やアクセス確認の影響を受けるため、投稿要素が実際に含まれているかを確認する必要があります。
前述のインストールコマンドにはBeautifulSoupも含まれています。以下のHTML解析例だけを使う場合は、python -m pip install beautifulsoup4==4.15.0でインストールできます。
コード9:取得が許可されたHTMLレスポンスを解析する
"""Parse an already-permitted HTML response and fail on challenge/changed markup."""

from bs4 import BeautifulSoup


def parse_visible_posts(html):
    soup = BeautifulSoup(html, "html.parser")
    rows = []
    for tag in soup.select("shreddit-post"):
        title = tag.get("post-title")
        permalink = tag.get("permalink")
        if title and permalink:
            rows.append({"title": title, "permalink": permalink})
    if not rows:
        raise ValueError("No post elements; inspect page or challenge response")
    return rows
このコードは、受け取ったHTMLを解析する例です。HTMLそのものを取得する処理は含みません。shreddit-postは公開ページの構造例に基づくセレクターで、今後も有効とは限りません。
対象要素が見つからないときは、ログイン画面、アクセス確認画面、HTML構造の変更を確認します。構造変更を検知できるテストも用意してください。コメントの取得や返信関係の維持、多数のページからの安定した収集には、承認済みのData APIを優先します。
Rola-IPのプロキシをPython・PRAWに設定する方法
プロキシは、許可された公開ページの地域別表示を確認する場合や、承認済みの収集処理で通信の出口を管理する場合に設定します。APIの利用許可やレート制限を変更する機能はありません。
Rola-IPでは、住宅用プロキシや静的住宅用プロキシなどを提供しています。選定時は、対象地域、接続の安定性、通信量に応じた費用、対象サービスのルールを確認します。
| 種類 | 適した用途 | 選定時のポイント |
|---|---|---|
| ローテーション型の住宅用プロキシ | 相互に独立した短いリクエスト | IP切り替えの条件と、用途上の必要性を確認します |
| 静的住宅用プロキシ | 同じ出口IPを維持したいセッション | IPの固定性と接続の安定性を確認します |
対応地域、セッション方式、プランは、Rola-IPの住宅用プロキシとスクレイピング向けプロキシで確認できます。実際の接続先や現在の設定値は、アカウントの管理画面を参照してください。
プロキシの認証情報を設定する
完全版スクリプトは、ROLA_PROXY_URLが設定されている場合に、RequestsのセッションをPRAWへ渡してHTTP・HTTPS通信をプロキシ経由にします。未設定なら直接接続し、他の環境変数から引き継いだプロキシ設定は使用しません。
- ユーザー名・パスワード認証:
http://USERNAME:PASSWORD@HOST:PORTの形式を使います。ユーザー名やパスワードに特殊文字がある場合はURLエンコードします。 - 接続元IPによる許可リスト認証: ユーザー名とパスワードの部分を省略し、現在のグローバルIPが許可リストに登録されていることを確認します。
- 秘密情報の扱い: 実際の値は安全な環境変数設定やシークレット管理ツールで渡し、プロキシURLをログへ出力しません。
PowerShellでの設定形式は次のとおりです。値はプレースホルダーです。
$env:ROLA_PROXY_URL="http://USERNAME:PASSWORD@HOST:PORT"
出口IPを確認して接続経路を切り分ける
ROLA_PROXY_URLを設定した後、IP確認サービスでプロキシ経由の出口IPを確認します。次のコードが設定するのは、この確認リクエストの経路だけです。PRAW側の設定はコード8が別途行います。
コード10:Rola-IP経由の出口IPを確認する
import os
import requests

from ipaddress import ip_address

try:
    proxy = os.environ["ROLA_PROXY_URL"]
    response = requests.get(
        "https://ipinfo.io/json",
        proxies={"http": proxy, "https": proxy}, timeout=15,
    )
    response.raise_for_status()
    print(ip_address(response.json()["ip"]))
except (requests.RequestException, ValueError, KeyError) as exc:
    print("Proxy diagnostic failed:", type(exc).__name__)
    raise SystemExit(1)
認証方式、ポート、許可リストの設定は、Python連携ドキュメントを参照してください。Requestsの引数については、Requestsのプロキシ引数についても確認できます。
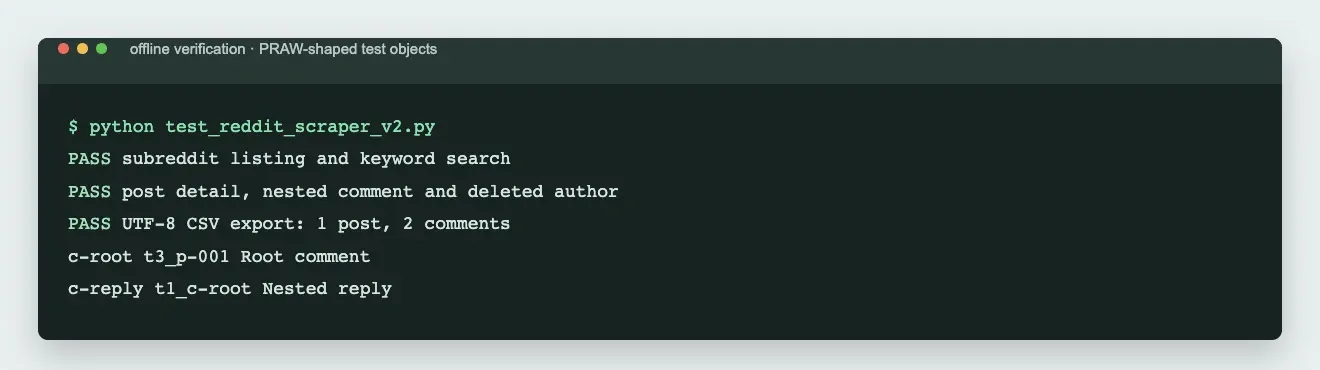
図4:テストデータによる投稿・返信・CSV出力のオフライン検証を示した模式図です。
Reddit APIの制限対策:429・403などのエラーを切り分ける
エラーが発生したら、認証、リクエスト頻度、レスポンス内容、ネットワーク経路を分けて確認します。429では処理を止め、Retry-Afterで指定された時間以上待ってから再実行します。 Redditの429エラーの切り分けは、レート制限エラーの対処法も参照してください。
| 症状 | 考えられる原因 | 最初に確認すること |
|---|---|---|
| 401・403 | 認証情報の不備、権限不足、アクセス拒否 | Redditアプリケーションの状態と承認済みの範囲を確認します。むやみにIPを変更しません |
| 429 | リクエスト頻度の超過 | 実行を停止してRetry-Afterを確認します。IPを切り替えて制限を回避しません |
| 200なのに投稿がない | アクセス確認画面、ログイン画面、セレクターの変更 | ステータスコードだけでなく、実際のレスポンス内容を確認します |
| 503・タイムアウト | 一時的なサービス障害、通信経路の障害 | ライブラリの有限回の再試行後、秘密情報を除いたステータスと所要時間を確認します |
| プロキシの407 | 認証、許可リスト、ポート設定の不備 | IP確認サービスで、プロキシへの接続から切り分けます |
| 投稿者名が空欄 | 既定では出力しない設定、アカウントの削除・取得不可 | --include-authorsの有無を確認し、取得できない場合は空欄を維持します |
| コメントが想定より少ない | 出力上限、未展開のMoreComments、削除、権限制限 |
--comments-per-postと--more-limitを確認し、閲覧可能な範囲と照合します |
完全版スクリプトでは、失敗した処理を繰り返す追加のリトライループを設けていません。PRAW・prawcoreがそれぞれ持つリクエスト処理とレート制限処理を利用します。依存パッケージは、オフライン検証時のバージョンに固定しています。
エラーがスクリプトまで伝わった場合は、例外の種類と、取得可能であればHTTPステータス・Retry-Afterを記録し、途中までのデータを保存して終了します。認証情報、プロキシURL、レスポンス本文をそのままログへ残さないでください。
リクエストのタイムアウトは20秒ですが、ライブラリの待機時間やエクスポート全体の所要時間を20秒以内に抑える設定ではありません。
Redditの利用権限ではなく、ネットワークのセキュリティ制限が原因の場合は、ネットワークセキュリティによるブロックが疑われる場合は、レスポンス内容と接続経路を確認してください。プロキシを使っても、APIの権限不足や利用上限を解消できるわけではありません。