
Парсер AliExpress на Python: данные из сохранённого HTML в CSV
22 окт. 2026 г. · Руководства · 16 мин. чтения
Парсер товаров AliExpress должен сначала убедиться, что нашёл нужную карточку, и только потом сохранять цену. Ниже — полный пример на Python: он читает разметку Product в формате JSON-LD, проверяет идентификатор товара, название, цену и валюту, а затем записывает результат в CSV.
Для проверки предусмотрены восемь искусственно созданных HTML-страниц. Их можно обработать без подключения к AliExpress, а результаты — проверить в Excel. Это учебные данные, а не выгрузка реального ассортимента.
Основные правила:
- Сопоставляйте товар по
urlили@idобъекта Product. Артикул продавца, или SKU, не заменяет ID товара на площадке. - Принимайте только одно предложение
Offerс конечной неотрицательной ценой. - Оставляйте отсутствующие оценки пустыми. Неизвестный статус наличия храните отдельно от отсутствия товара на складе.
- Сначала проверьте обработку локальных файлов. Для собственных данных используйте HTML, который вы вправе обрабатывать.
1. Подготовка Python и полный код парсера AliExpress
Парсер извлекает данные из JSON-LD и проверяет их перед записью. Он не запускает JavaScript, поэтому подходит только для HTML, в котором уже есть поддерживаемый объект Product.
Создайте рабочую папку. Основной скрипт сохраните в ней под именем article_ali_scraper.py; генератор примеров и скрипт пакетной обработки приведены в следующем разделе.
Локальная проверка выполнена 21 октября 2026 года в среде Windows 10, сборка 19045; Python 3.12.10; Requests 2.34.2; Beautiful Soup 4.15.0.
python --version
python -m pip install requests==2.34.2 beautifulsoup4==4.15.0
Входной адрес должен иметь вид https://www.aliexpress.com/item/PRODUCT_ID.html, где PRODUCT_ID — числовой ID. Допускаются домены aliexpress.com и www.aliexpress.com, протокол HTTPS и порт 443 либо отсутствие явно заданного порта. Параметры отслеживания и фрагмент в передаваемом адресе не допускаются.
Этот пример обрабатывает отдельную карточку товара. Поисковая выдача, страницы отзывов, корзина и оформление заказа в него не входят.
Содержимое article_ali_scraper.py:
"""Strict Product JSON-LD parser and optional, bounded AliExpress fetcher."""
import argparse
import csv
import json
import os
import re
import sys
import tempfile
from datetime import datetime, timezone
from decimal import Decimal, InvalidOperation
from pathlib import Path
from urllib.parse import urljoin, urlsplit

import requests
from bs4 import BeautifulSoup

FIELDS = ['product_id', 'title', 'currency', 'price', 'availability', 'rating',
          'review_count', 'processed_at_utc', 'input_url', 'final_url', 'source_kind']
REDIRECTS = {301, 302, 303, 307, 308}


def product_id_from_url(url, expected_id=None):
    try:
        u = urlsplit(url)
        valid_host = u.hostname in {'aliexpress.com', 'www.aliexpress.com'}
        valid_port = u.port in (None, 443)
    except (ValueError, TypeError):
        raise ValueError('invalid product URL') from None
    match = re.fullmatch(r'/item/([0-9]+)\.html', u.path)
    if (u.scheme != 'https' or not valid_host or not valid_port or u.username
            or u.password or u.query or u.fragment or not match):
        raise ValueError('use an HTTPS aliexpress.com /item/ID.html URL without query or fragment')
    pid = match.group(1)
    if expected_id is not None and pid != expected_id:
        raise ValueError('redirect or Product identity mismatch')
    return pid


def has_type(obj, wanted):
    types = obj.get('@type', [])
    if isinstance(types, str):
        types = [types]
    return isinstance(types, list) and any(t in {wanted, 'https://schema.org/' + wanted,
                                                'http://schema.org/' + wanted} for t in types if isinstance(t, str))


def walk(node):
    if isinstance(node, dict):
        yield node
        for value in node.values():
            yield from walk(value)
    elif isinstance(node, list):
        for value in node:
            yield from walk(value)


def candidate_matches(item, requested_id):
    identities = []
    for key in ('url', '@id'):
        value = item.get(key)
        if not value:
            continue
        if not isinstance(value, str):
            return False
        # A fragment may identify the Product entity within its own page.
        try:
            identities.append(product_id_from_url(value.split('#', 1)[0]))
        except ValueError:
            return False
    # Never equate a seller SKU with the marketplace's product ID.
    return bool(identities) and all(pid == requested_id for pid in identities)


def numeric(value, label):
    if isinstance(value, bool):
        raise ValueError(label + ' must be numeric')
    try:
        number = Decimal(str(value))
    except (InvalidOperation, ValueError):
        raise ValueError(label + ' must be numeric') from None
    if not number.is_finite() or number < 0:
        raise ValueError(label + ' must be finite and nonnegative')
    return format(number, 'f')


def parse_product(html, input_url, final_url=None, source_kind='saved_html'):
    requested_id = product_id_from_url(input_url)
    final_url = final_url or input_url
    product_id_from_url(final_url, requested_id)
    soup = BeautifulSoup(html, 'html.parser')
    # These are sample stop markers, not a universal challenge detector.
    visible = soup.get_text(' ', strip=True).lower()
    if any(marker in visible for marker in ('slide to verify', 'verify you are human',
                                             '请拖动下方滑块完成验证')):
        raise ValueError('verification page returned')
    candidates = []
    for script in soup.find_all('script', attrs={'type': 'application/ld+json'}):
        try:
            data = json.loads(script.string or script.get_text(), parse_float=Decimal)
        except (json.JSONDecodeError, TypeError):
            continue
        candidates.extend(n for n in walk(data) if has_type(n, 'Product')
                          and candidate_matches(n, requested_id))
    if len(candidates) != 1:
        raise ValueError('requested Product identity is missing or ambiguous')
    product = candidates[0]
    title = product.get('name')
    if not isinstance(title, str) or not title.strip():
        raise ValueError('product title is missing')
    offer = product.get('offers')
    if isinstance(offer, list) and len(offer) == 1:
        offer = offer[0]
    if (not isinstance(offer, dict) or not has_type(offer, 'Offer')
            or has_type(offer, 'AggregateOffer') or 'lowPrice' in offer or 'highPrice' in offer):
        raise ValueError('a single Offer with one price is required')
    price = numeric(offer.get('price'), 'price')
    currency = str(offer.get('priceCurrency', '')).strip().upper()
    if not re.fullmatch('[A-Z]{3}', currency):
        raise ValueError('currency must contain three ASCII letters')
    availability = str(offer.get('availability', '')).rstrip('/').rsplit('/', 1)[-1]
    if availability not in {'InStock', 'OutOfStock'}:
        availability = 'Unknown'
    rating = product.get('aggregateRating', {})
    rating = rating if isinstance(rating, dict) else {}
    optional = {}
    for key, output in [('ratingValue', 'rating'), ('reviewCount', 'review_count')]:
        value = rating.get(key)
        optional[output] = ''
        if value is not None and value != '':
            try:
                parsed = numeric(value, key)
                if key != 'reviewCount' or Decimal(parsed) == Decimal(parsed).to_integral_value():
                    optional[output] = parsed
            except ValueError:
                pass
    return dict(product_id=requested_id, title=title.strip(), currency=currency,
                price=price, availability=availability, **optional,
                processed_at_utc=datetime.now(timezone.utc).isoformat(timespec='seconds'),
                input_url=input_url, final_url=final_url, source_kind=source_kind)


def fetch_product(url, session):
    requested_id = product_id_from_url(url)
    current = url
    for hop in range(6):
        with session.get(current, timeout=(10, 20), allow_redirects=False, stream=True) as response:
            if response.status_code in REDIRECTS:
                if hop == 5 or not response.headers.get('Location'):
                    raise ValueError('redirect limit exceeded or Location missing')
                target = urljoin(current, response.headers['Location'])
                product_id_from_url(target, requested_id)
                current = target
                continue
            if response.status_code == 429:
                raw = response.headers.get('Retry-After', 'not supplied')
                hint = ''.join(c for c in raw if c.isprintable())[:100]
                raise ValueError('HTTP 429; stop. Retry-After: ' + hint)
            if response.status_code != 200:
                raise ValueError('HTTP ' + str(response.status_code) + '; stop current request')
            chunks, size = [], 0
            for chunk in response.iter_content(65536):
                size += len(chunk)
                if size > 5_000_000:
                    raise ValueError('HTML exceeds 5 MB limit')
                chunks.append(chunk)
            html = b''.join(chunks).decode(response.encoding or 'utf-8', errors='replace')
            return parse_product(html, url, current, source_kind='online_response')
    raise ValueError('redirect limit exceeded')


def safe_cell(value):
    text = str(value)
    # Protect spreadsheet users from formula-like untrusted product titles.
    return "'" + text if text.lstrip().startswith(('=', '+', '-', '@')) else value


def write_csv(path, rows, fields=FIELDS):
    path = Path(path)
    path.parent.mkdir(parents=True, exist_ok=True)
    name = None
    try:
        with tempfile.NamedTemporaryFile('w', encoding='utf-8-sig', newline='',
                                         dir=path.parent, delete=False) as f:
            name = f.name
            writer = csv.DictWriter(f, fieldnames=fields)
            writer.writeheader()
            writer.writerows({key: safe_cell(row[key]) for key in fields} for row in rows)
        os.replace(name, path)
    finally:
        if name and os.path.exists(name):
            os.unlink(name)


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument('url', help='HTTPS product-detail URL, without tracking parameters')
    parser.add_argument('--html', type=Path, help='parse saved HTML without any network request')
    parser.add_argument('--output', type=Path, default=Path('product.csv'))
    parser.add_argument('--authorized', action='store_true', help='confirm permission for an online request')
    args = parser.parse_args()
    try:
        if args.html:
            row = parse_product(args.html.read_text(encoding='utf-8'), args.url)
        else:
            if not args.authorized:
                parser.error('online requests require --authorized; use --html for offline parsing')
            with requests.Session() as session:
                row = fetch_product(args.url, session)
        write_csv(args.output, [row])
        print('Wrote 1 record to ' + str(args.output))
    except requests.RequestException as exc:
        print('STOP: ' + type(exc).__name__ + '; check connection, proxy and credentials locally', file=sys.stderr)
        return 1
    except (ValueError, OSError) as exc:
        print('STOP: ' + str(exc), file=sys.stderr)
        return 1
    return 0


if __name__ == '__main__':
    sys.exit(main())
2. Парсинг сохранённого HTML и выгрузка товаров AliExpress в CSV
Локальный запуск создаёт восемь тестовых карточек и выгружает их данные в CSV и JSON. Запросы к площадке для этого не нужны.
Сохраните в рабочей папке ещё два файла. Первый — build_examples.py:
"""Create eight explicitly synthetic parser fixtures; no network requests."""
import json
from pathlib import Path

EXAMPLES = [
    ('USB-C 7-in-1 Hub', 'USD', '24.90', 'InStock', '4.6', 328),
    ('Portable Laptop Stand', 'USD', '19.50', 'InStock', '4.5', 217),
    ('Compact Cable Organizer', 'USD', '8.25', 'InStock', None, None),
    ('Travel Packing Cubes', 'EUR', '17.30', 'InStock', '4.2', 84),
    ('Foldable Travel Bottle', 'EUR', '11.80', 'OutOfStock', None, None),
    ('Desk Cable Clips', 'EUR', '5.40', 'InStock', '4.1', 63),
    ('Adjustable Desk Lamp', 'JPY', '2480', 'InStock', '4.7', 105),
    ('Canvas Pencil Case', 'JPY', '780', 'OutOfStock', None, None),
]


def build():
    folder = Path(__file__).parent / 'saved_html'
    folder.mkdir(exist_ok=True)
    manifest = []
    for i, (title, currency, price, stock, rating, count) in enumerate(EXAMPLES, 100000001):
        url = f'https://www.aliexpress.com/item/{i}.html'
        product = {'@context': 'https://schema.org', '@type': 'Product', 'url': url,
                   'name': title, 'offers': {'@type': 'Offer', 'price': price,
                   'priceCurrency': currency, 'availability': 'https://schema.org/' + stock}}
        if rating is not None:
            product['aggregateRating'] = {'@type': 'AggregateRating', 'ratingValue': rating, 'reviewCount': count}
        html = '<!doctype html><html lang="en"><meta charset="utf-8"><title>Synthetic fixture</title><body><h1>Synthetic parser fixture; not a marketplace capture</h1><script type="application/ld+json">' + json.dumps(product) + '</script></body></html>'
        (folder / f'{i}.html').write_text(html, encoding='utf-8')
        manifest.append({'file': f'{i}.html', 'url': url, 'source_kind': 'synthetic_fixture'})
    (folder / 'manifest.json').write_text(json.dumps(manifest, indent=2), encoding='utf-8')
    print('Created 8 synthetic HTML fixtures; no marketplace requests were made.')


if __name__ == '__main__':
    build()
Второй — run_local_pipeline.py:
"""Parse the delivered synthetic HTML and export CSV summaries."""
import json
from collections import Counter
from pathlib import Path
from article_ali_scraper import parse_product, write_csv


def main():
    root = Path(__file__).parent
    folder = root / 'saved_html'
    manifest = json.loads((folder / 'manifest.json').read_text(encoding='utf-8'))
    rows = [parse_product((folder / entry['file']).read_text(encoding='utf-8'),
                          entry['url'], source_kind=entry['source_kind']) for entry in manifest]
    write_csv(root / 'product_fields.csv', rows)
    summaries = []
    for currency in sorted({r['currency'] for r in rows}):
        counts = Counter(r['availability'] for r in rows if r['currency'] == currency)
        summaries.append(dict(currency=currency, in_stock=counts['InStock'],
                              out_of_stock=counts['OutOfStock'], unknown=counts['Unknown'], total=sum(counts.values())))
    write_csv(root / 'currency_availability_summary.csv', summaries,
              ['currency', 'in_stock', 'out_of_stock', 'unknown', 'total'])
    (root / 'product_fields.json').write_text(json.dumps(rows, indent=2), encoding='utf-8')
    for row in rows:
        print(f"{row['product_id']} | {row['currency']} {row['price']} | {row['availability']}")
    print('Wrote 8 synthetic records to product_fields.csv')
    for item in summaries:
        print(item)


if __name__ == '__main__':
    main()
Выполните в этой же папке:
python build_examples.py
python run_local_pipeline.py
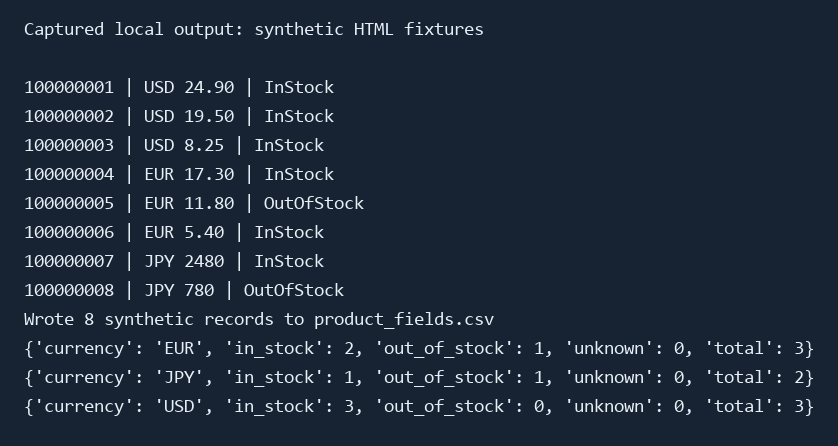
Первая команда создаст восемь HTML-файлов в saved_html/ и файл manifest.json с перечнем входных данных. Вторая прочитает этот перечень, передаст каждый файл в parse_product() и сформирует результаты:
| Файл | Содержимое |
|---|---|
product_fields.csv |
Восемь записей: поля товара, входной и конечный URL, время обработки и тип источника |
currency_availability_summary.csv |
Количество записей по валюте и наличию, включая неизвестный статус |
product_fields.json |
Те же записи в JSON для дальнейшей обработки |
В наборе три записи в USD, три в EUR и две в JPY.
Как обработать собственный HTML-файл
Откройте сохранённый файл в кодировке UTF-8 и найдите application/ld+json. Проверьте структуру:
- В разметке есть объект Product.
- Его
urlили@idуказывает на нужный товар. - Поле
offersсодержит ровно одно предложение Offer сpriceиpriceCurrency.
Если нужных данных нет, сначала проверьте способ сохранения страницы. Скрипт читает готовое содержимое файла и не выполняет JavaScript.
Замените PRODUCT_ID числовым ID из адреса своей карточки:
python article_ali_scraper.py "https://www.aliexpress.com/item/PRODUCT_ID.html" --html saved-product.html --output product.csv
С параметром --html сетевых запросов нет. При успехе скрипт возвращает код 0, выводит Wrote 1 record и обновляет указанный CSV. Ошибка проверки приводит к коду 1; существующий выходной файл остаётся без изменений.
3. Как парсер определяет нужный товар
Товар считается найденным, только если ровно один объект Product соответствует ID из входного URL. Название, карточки рекомендаций и SKU продавца для такого сопоставления не используются.
Скрипт перебирает блоки <script type="application/ld+json">, а внутри них — объекты, массивы и структуры @graph. Значение @type может быть строкой или списком типов. Блоки с некорректным JSON пропускаются. Если подходящего Product нет или их несколько, запись отклоняется.
Правила проверки идентификатора:
- Хотя бы одно из полей
urlи@idдолжно указывать на запрошенную страницу/item/ID.html. - Если заполнены оба поля, оба должны соответствовать тому же товару.
- В идентификаторе структурированных данных допускается фрагмент, например
#product. - Неподдерживаемый формат адреса не заменяется догадкой по другим полям.
Пример вызова функции из полного скрипта:
from pathlib import Path
from article_ali_scraper import parse_product

html = Path("saved_html/100000001.html").read_text(encoding="utf-8")
record = parse_product(
    html,
    "https://www.aliexpress.com/item/100000001.html",
    source_kind="synthetic_fixture",
)
print(record["product_id"], record["currency"], record["price"])
Для созданного тестового файла результат — 100000001 USD 24.90. Используйте этот пример локально: URL здесь задаёт идентификатор искусственной карточки и не предназначен для проверки реального товара в сети.
Если страница использует ссылки между узлами JSON-LD, которые код не разрешает, несколько подходящих объектов Product или другие форматы идентификаторов, обработчик нужно расширить под фактическую структуру HTML. В текущем варианте неоднозначные данные отклоняются.
4. Какие данные о товаре принимает парсер?
Обязательные поля проходят строгую проверку: ошибка в ID, названии, цене или валюте отклоняет запись целиком. Необязательные оценки могут оставаться пустыми, а неопределённое наличие получает статус Unknown.
| Поле | Правило | Если значение отсутствует или некорректно |
|---|---|---|
product_id |
Совпадает с ID во входном URL | Отклонить запись |
title |
Непустая строка name объекта Product |
Отклонить запись |
price |
Одна цена Offer.price; десятичная арифметика, конечное неотрицательное число |
Отклонить запись |
currency |
Три латинские буквы ASCII в верхнем регистре после нормализации | Отклонить запись |
availability |
Явно распознаются InStock и OutOfStock |
Записать Unknown |
rating / review_count |
Необязательные поля aggregateRating: конечные неотрицательные числа; число отзывов — целое |
Оставить пустыми |
processed_at_utc |
Время обработки входных данных | Не считать временем сохранения страницы |
input_url / final_url |
Запрошенный и проверенный конечный URL; для сохранённого HTML по умолчанию совпадают | Отклонить переданный конечный URL, если он указывает на другой товар |
source_kind |
Тип источника: тестовый пример, сохранённый HTML или сетевой ответ | Сохранять происхождение данных |
Свойства цены и валюты описаны в документации Schema.org для Offer. Проверка трёх букв подтверждает только формат валютного кода. Она не сверяет значение со списком ISO 4217. При необходимости добавьте актуальный список допустимых кодов.
Парсер принимает объект Offer либо список из одного такого объекта. Несколько предложений, AggregateOffer и диапазоны lowPrice/highPrice отклоняются. Это ограничение данного примера: на выходе нужна одна указанная цена на запись. Другие структуры Schema.org сами по себе не становятся некорректными.
Дробные числа JSON сразу преобразуются в Decimal, без промежуточного двоичного float. Цены в виде десятичных строк тоже принимаются. В CSV числа записываются без экспоненциальной формы, поэтому запись со степенью может разворачиваться в обычную десятичную строку.
Для сохранённого HTML отдельно храните исходный адрес и время сохранения. Значение final_url, автоматически равное input_url, не подтверждает историю перенаправлений файла.
Почему цена в карточке может отличаться от суммы заказа
Скрипт извлекает цену одного предложения, а не итоговую сумму при оформлении заказа. На неё могут влиять:
- выбранный вариант товара;
- страна и адрес доставки;
- акции и скидки;
- стоимость доставки;
- налоги.
Для сравнения цен отдельно фиксируйте вариант, рынок, направление доставки и время сохранения страницы. Выходной IP прокси не подтверждает эти параметры.
Для смежной задачи — отслеживания изменений цен во времени — см. руководство про мониторинг цен на Shopee. Способ получения карточек зависит от площадки; код из этого примера предназначен для описанной структуры JSON-LD.
5. Как проверить выгрузку из AliExpress в Excel
В Excel проверьте количество записей, статусы наличия и заполненность полей. ID товара импортируйте как текст: длинные числовые идентификаторы могут потерять точность.
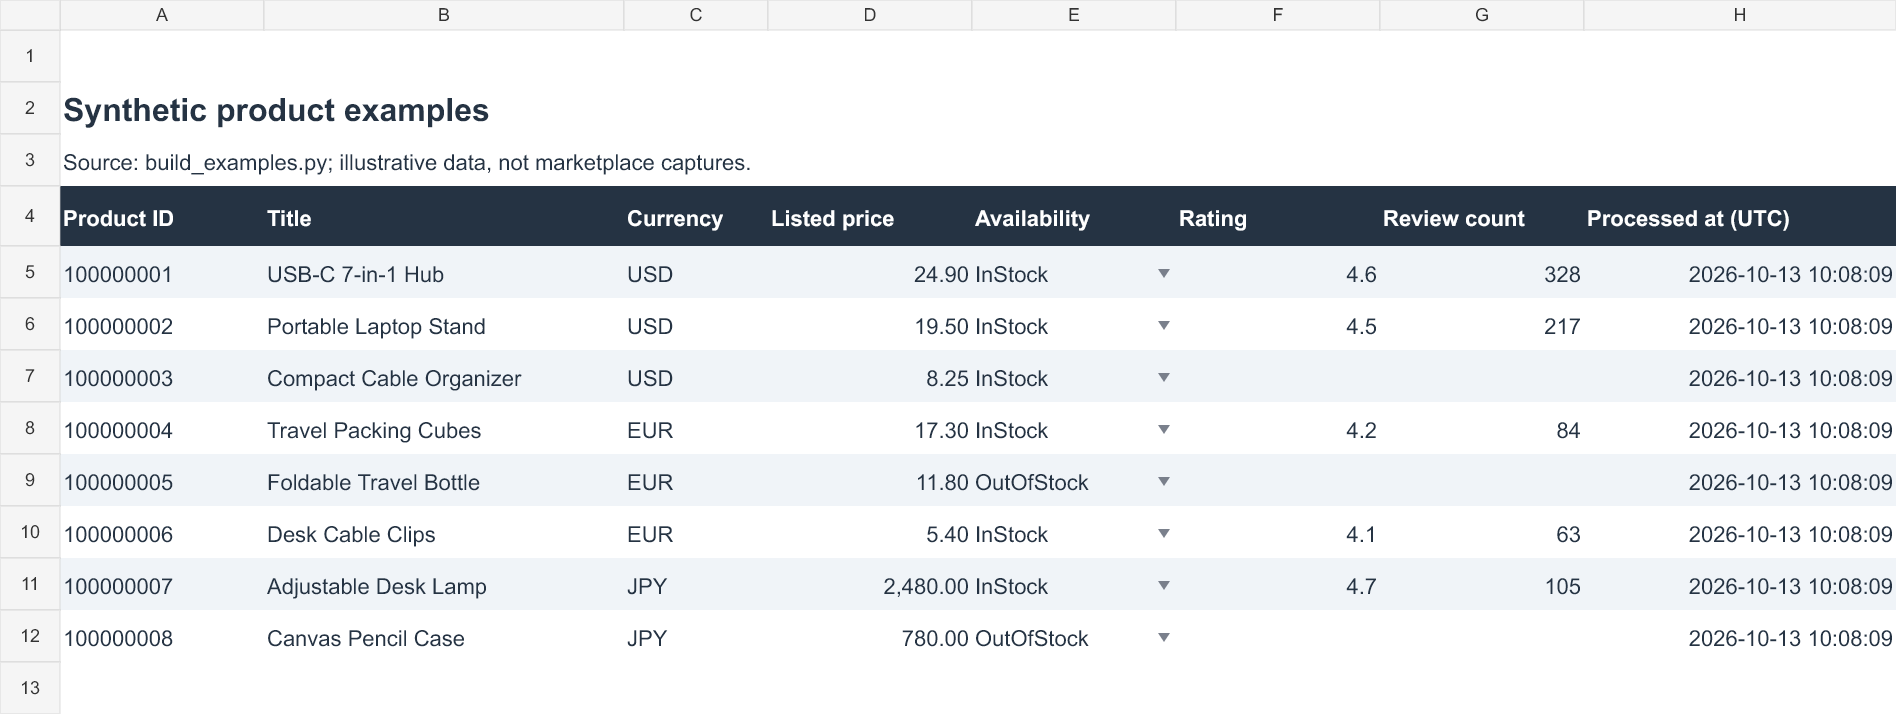
Откройте product_fields.csv через Данные → Из текста/CSV. Пустые оценки оставьте пустыми. Создайте листы Product Fields и Summary: эти имена используются в формулах ниже.
На листе Product Fields разместите заголовки в строке 4, восемь записей — в строках 5–12. Для столбцов A–H используйте такой порядок:
- ID товара.
- Название.
- Валюта.
- Цена в карточке.
- Наличие.
- Оценка.
- Количество отзывов.
- Время обработки.
Поля с адресами и типом источника разместите справа. Команды Python создают CSV и JSON; листы Excel нужно подготовить отдельно.
Подсчёт товаров по валюте и наличию
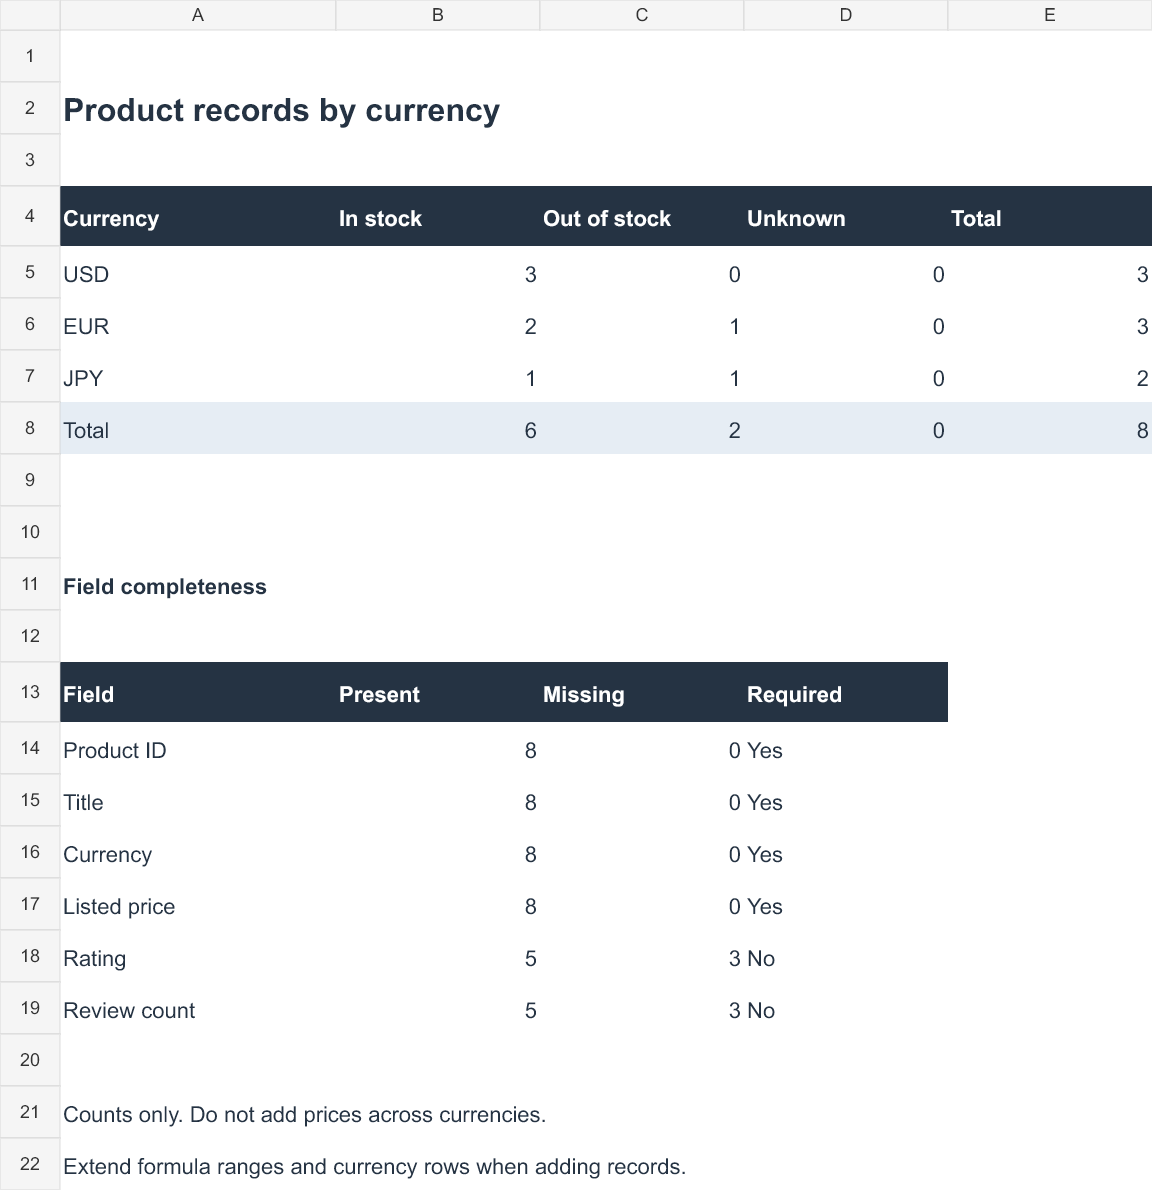
В диапазоне строк 5–12 валюта находится в столбце C, наличие — в E. На листе Summary заполните A4:E4 заголовками «Валюта», «В наличии», «Нет в наличии», «Неизвестно», «Всего». В A5:A7 укажите USD, EUR и JPY.
В B5 введите:
=COUNTIFS('Product Fields'!$C$5:$C$12,$A5,'Product Fields'!$E$5:$E$12,"InStock")
Для C5 и D5 используйте ту же формулу, заменив статус на "OutOfStock" и "Unknown". В E5 укажите =SUM(B5:D5). Протяните B5:E5 до строки 7. Для итогов в B8 введите =SUM(B5:B7) и протяните формулу до E8.
В русской локализации Excel названия функций могут отображаться как СЧЁТЕСЛИМН, СУММ, СЧИТАТЬПУСТОТЫ и ЧСТРОК вместо COUNTIFS, SUM, COUNTBLANK и ROWS. Разделителем аргументов часто служит точка с запятой. В этом случае формула для B5 выглядит так:
=СЧЁТЕСЛИМН('Product Fields'!$C$5:$C$12;$A5;'Product Fields'!$E$5:$E$12;"InStock")
Если Excel не принимает формулу, проверьте язык функций и разделитель аргументов в своих региональных настройках.
Ожидаемая сводка:
Валюта |
В наличии |
Нет в наличии |
Неизвестно |
Всего |
|---|---|---|---|---|
USD |
3 |
0 |
0 |
3 |
EUR |
2 |
1 |
0 |
3 |
JPY |
1 |
1 |
0 |
2 |
Всего |
6 |
2 |
0 |
8 |
Отсутствующее или нераспознанное наличие превращается в Unknown при парсинге. Оно не учитывается как отсутствие товара на складе.
При добавлении товаров расширяйте диапазоны формул и включайте новые валюты в сводку. Для ручного редактирования столбца наличия выделите E5:E12 на Product Fields и откройте Данные → Проверка данных → Список. Задайте значения InStock, OutOfStock, Unknown, используя разделитель списка своей локализации Excel.
Проверка пропусков без подстановки нулей
Во всех восьми записях есть ID, название, валюта и цена. Оценка и количество отзывов заполнены у пяти товаров; у трёх эти поля пусты.
Число пропусков в столбце оценок:
=COUNTBLANK('Product Fields'!F5:F12)
Число заполненных оценок:
=ROWS('Product Fields'!F5:F12)-COUNTBLANK('Product Fields'!F5:F12)
Повторите расчёт для столбцов A–D и G. Настоящий числовой ноль считается заполненным значением. Для анализа цен в больших наборах сначала объединяйте сопоставимые записи по валюте, варианту товара, рынку и периоду сохранения страниц.
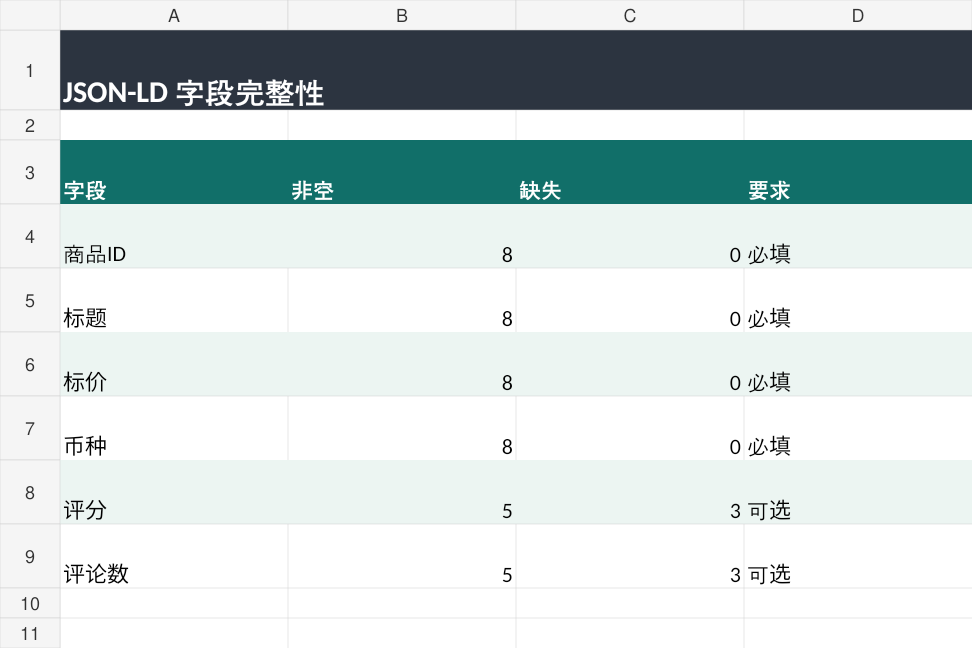
6. Проверка ошибок перед обработкой собственных данных
Проверьте, что парсер отклоняет неверную цену и чужой ID, а пропуски необязательных полей обрабатывает без подстановки нулей. Эти проверки выполняются на локальных копиях HTML и не требуют запросов к AliExpress.
- Запустите восемь примеров и сравните количество записей с рисунком 1.
- Сделайте копию одного HTML-файла. Замените цену на
"NaN"и запустите команду обработки одного файла из раздела 2. - Убедитесь, что код завершения равен
1, а существующий CSV не изменился. - Восстановите цену, замените URL объекта Product адресом с другим ID и повторите проверку. Результат должен быть таким же.
- Восстановите идентификатор и удалите наличие: результат должен содержать
Unknown. - Удалите необязательные оценки: соответствующие поля должны остаться пустыми.
Перед каждой следующей проверкой восстанавливайте остальные входные данные.
| Проблема | Что проверить | Действие |
|---|---|---|
| Нет единственного подходящего Product | url, @id, дубликаты объектов и содержимое HTML |
Изучить сохранённую страницу; не подставлять данные рекомендаций |
| HTTP 200, но данных нет | Страница входа, проверка пользователя, конечный URL | Остановиться: успешный HTTP-статус не подтверждает наличие товара |
| Цена отсутствует или задана диапазоном | Структура Offer и выбранный вариант | Отклонить запись либо разработать отдельный парсер вариантов |
| HTTP 403 | Разрешение на доступ и условия получения страницы | Прекратить текущий запрос |
| HTTP 429 | Заголовок Retry-After и частота запросов |
Остановиться; допустимый повторный запрос планировать с учётом ограничения |
HTTP 407 или ProxyError |
Учётные данные прокси, протокол, адрес и порт | Проверить настройки локально, не раскрывая пароль |
| Тайм-аут соединения или чтения | Сетевой маршрут и поступление ответа | Выяснить причину перед повторной попыткой |
Перед заменой основного CSV скрипт пакетной обработки подготавливает все записи. Каждый CSV записывается через временный файл и os.replace; JSON записывается напрямую. Три выходных файла не образуют единую атомарную операцию. При проверке запуска сверяйте время изменения и количество записей.
Значения, похожие на формулы, при записи в CSV получают ведущий апостроф. Это защищает от выполнения названий товаров как формул при открытии в табличном редакторе.
7. Когда можно использовать сетевой запрос
Для сетевого режима в коде предусмотрена функция fetch_product(url, session). Она подходит только для разрешённого получения страниц, в ответе которых уже есть поддерживаемый объект Product. Условия доступа определяются правилами площадки и вашей задачей.
При вызове функции передайте URL нужного товара и объект requests.Session. В интерфейсе командной строки сетевой режим дополнительно требует флаг --authorized: он подтверждает выбор режима, но не выдаёт разрешение от площадки и не сохраняет его отдельно.
Ограничения сетевого режима:
- Не более пяти перенаправлений; каждый адрес должен вести к тому же товару на разрешённом домене.
- Тайм-аут соединения — 10 секунд.
- Тайм-аут чтения — 20 секунд. Это ожидание данных, а не общий предел времени выполнения.
- Размер тела ответа после декодирования сжатия — не более 5 000 000 байт, то есть 5 МБ.
- При HTTP-ошибке команда завершается без автоматических повторов.
- При HTTP 429 выводится значение
Retry-After, после чего выполнение прекращается.
Requests получает HTML и не выполняет JavaScript. Если подходящего Product в ответе нет, обработка завершается ошибкой. Скрипт не проходит проверки пользователя и не восстанавливает отсутствующие поля. Встроенные текстовые маркеры проверки — лишь несколько примеров, а не универсальный детектор таких страниц.
8. Прокси для парсинга AliExpress: роль Rola IP
Прокси задаёт сетевой выход, а парсер проверяет товар и его поля. Страна выходного IP сама по себе не определяет валюту, вариант товара или адрес доставки.
Если задаче нужен определённый сетевой выход, используйте параметры подключения Rola IP из личного кабинета. О том, чем резидентные адреса отличаются от серверных, читайте в руководстве: что такое резидентные прокси. Рынок, выбранный вариант, направление доставки и валюту фиксируйте отдельно.
Requests поддерживает переменную окружения HTTPS_PROXY; механизм описан в документации по прокси. Возьмите параметры подключения из личного кабинета провайдера.
Для оболочки macOS или Linux:
export HTTPS_PROXY="http://USERNAME:PASSWORD@HOST:PORT"
Для Windows PowerShell:
$env:HTTPS_PROXY = "http://USERNAME:PASSWORD@HOST:PORT"
В этих примерах HTTPS_PROXY задаёт прокси для HTTPS-запросов, а http:// в значении переменной обозначает способ подключения к самому прокси. HTTPS-сайт можно запрашивать через HTTP-прокси; схему адреса выбирайте по параметрам, которые выдал провайдер.
Замените все обозначения в верхнем регистре своими значениями. Если в логине или пароле есть зарезервированные символы URL, примените процентное кодирование. Не сохраняйте реальные учётные данные в общих скриптах, снимках терминала и выгрузках истории команд.
Проверьте также NO_PROXY: эта переменная может исключить отдельные домены из маршрутизации через прокси. Убедитесь, что Python-процесс действительно использует нужный выход. Настройки прокси самой PowerShell и настройки запущенного из неё Python-процесса могут различаться.
Ответ HTTP 503 может прийти от сайта, CDN или одного из звеньев прокси-соединения. Сначала определите источник ошибки. Смена IP сама по себе не устраняет ограничения аккаунта, состояние сессии и различия в структуре страниц.
9. Порядок работы с собственными карточками
Начните с восьми локальных примеров: они позволяют проверить сопоставление товара, правила Offer и формат CSV. Затем обрабатывайте собственные HTML-файлы, сохраняя сведения об источнике и времени получения страницы.
Перед анализом цен проверьте в Excel заполненность полей и количество записей по валютам. Сравнивайте только товары с сопоставимыми вариантами, рынком, условиями доставки и периодом сбора данных.