用Python抓取Bing搜索结果:分页、CSV导出与代理配置
2026年9月29日 · 教程 · 19 分钟阅读
用Python抓取Bing搜索结果,可以先通过Requests获取搜索页HTML,再用BeautifulSoup提取自然结果的标题、链接和摘要。本教程面向小规模SEO数据核验,介绍页内位置记录、分页、整页重复检测、JSON与CSV导出,以及可选的代理配置。
快速结论: 检查实际响应中的
li.b_algo,提取h2 a[href]和摘要节点;分页读取页面提供的下一页链接,在URL及顺序完全重复时停止。保留来源URL、采集时间和原始HTML,页码与页内位置不直接等于全局排名。遇到访问拒绝、限流或验证页面时停止任务并排查。
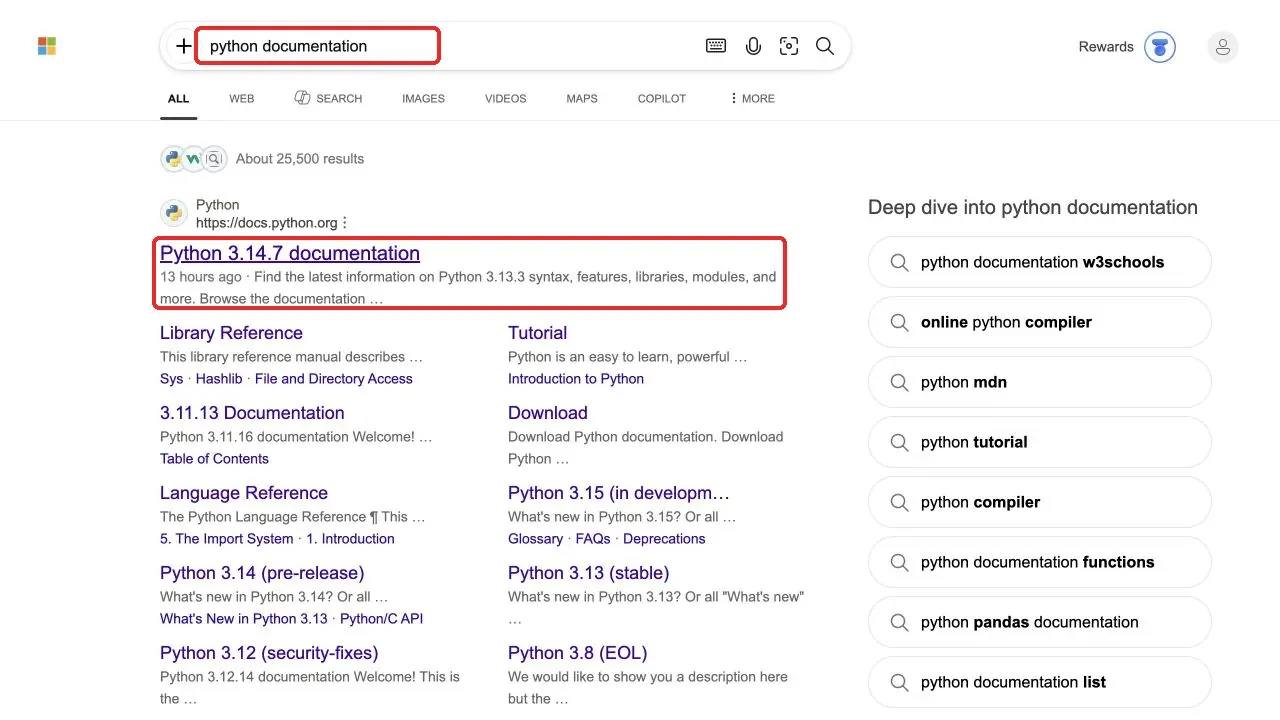
示例关键词使用python documentation。先在浏览器中确认字段位置,再检查Python收到的HTML,最后执行分页和导出。Bing的页面结构与结果会随地区、客户端和时间变化。
开始抓取前,先定义数据字段
做SEO监控时,可比性比字段数量更重要。同一个关键词可能因为时间、语言、地区、设备、Cookie或网络出口不同而得到不同结果。至少保存以下字段,才能判断变化来自页面内容,还是来自采集条件:
| 字段 | 含义 | 用途 |
|---|---|---|
query |
搜索关键词 | 保证同一批任务的关键词一致 |
page、position_on_page |
抓取页码和自然结果在当前页的位置 | 不要直接把它们称作全局排名 |
title、url |
结果标题和解析后的HTTP(S)链接 | 无法解码时,链接可能仍指向Bing跳转页 |
snippet |
Bing展示的摘要 | 可能为空,也不是目标页面全文 |
raw_href |
标题链接未经修改的href属性值 | 保留相对路径或原始跳转参数,供复核使用 |
source_url、fetched_at_utc |
实际响应URL与采集时间 | 追踪跳转、地区和运行批次 |
左侧自然结果、标题下的站点链接、右侧相关搜索属于不同数据类型。站点链接不能拆成多个主结果,“约有多少条结果”也不能直接当成脚本一定能下载的记录数。
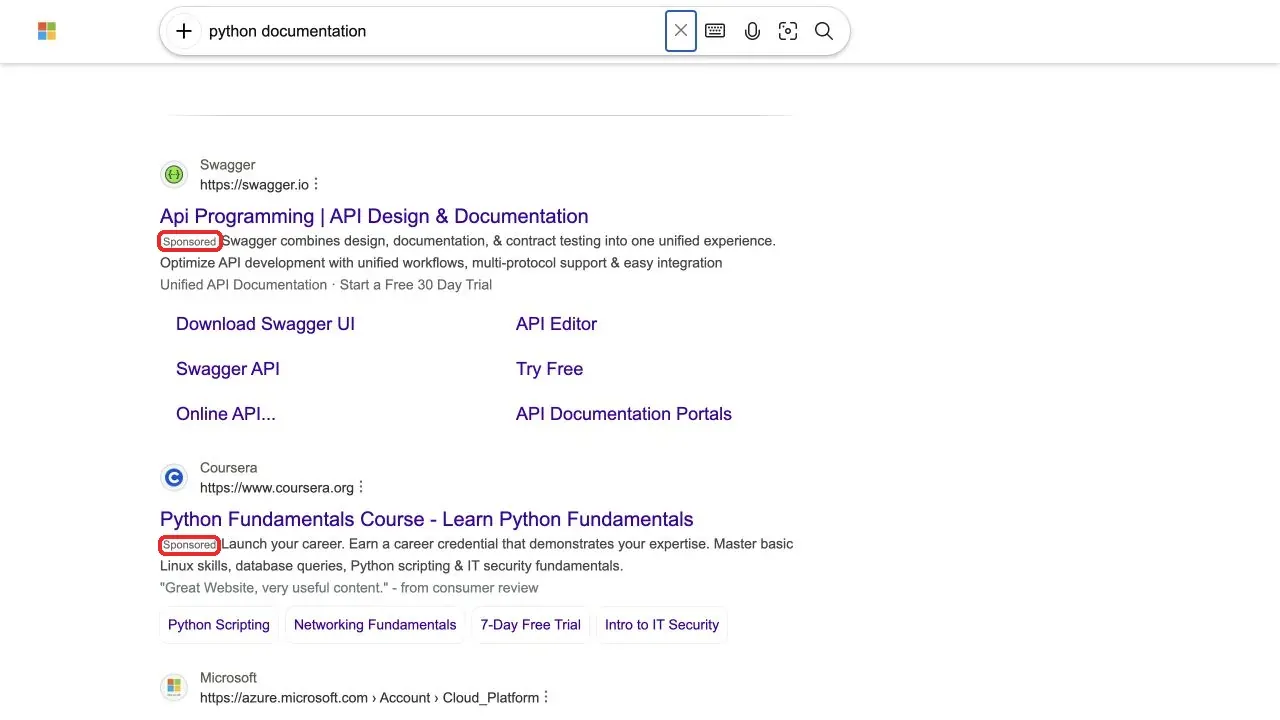
带有Sponsored标记的是广告。本文只解析自然结果容器,不通过遍历页面上所有h2和链接来凑数据,这样可以避免把广告、导航和其他组件混入结果集。
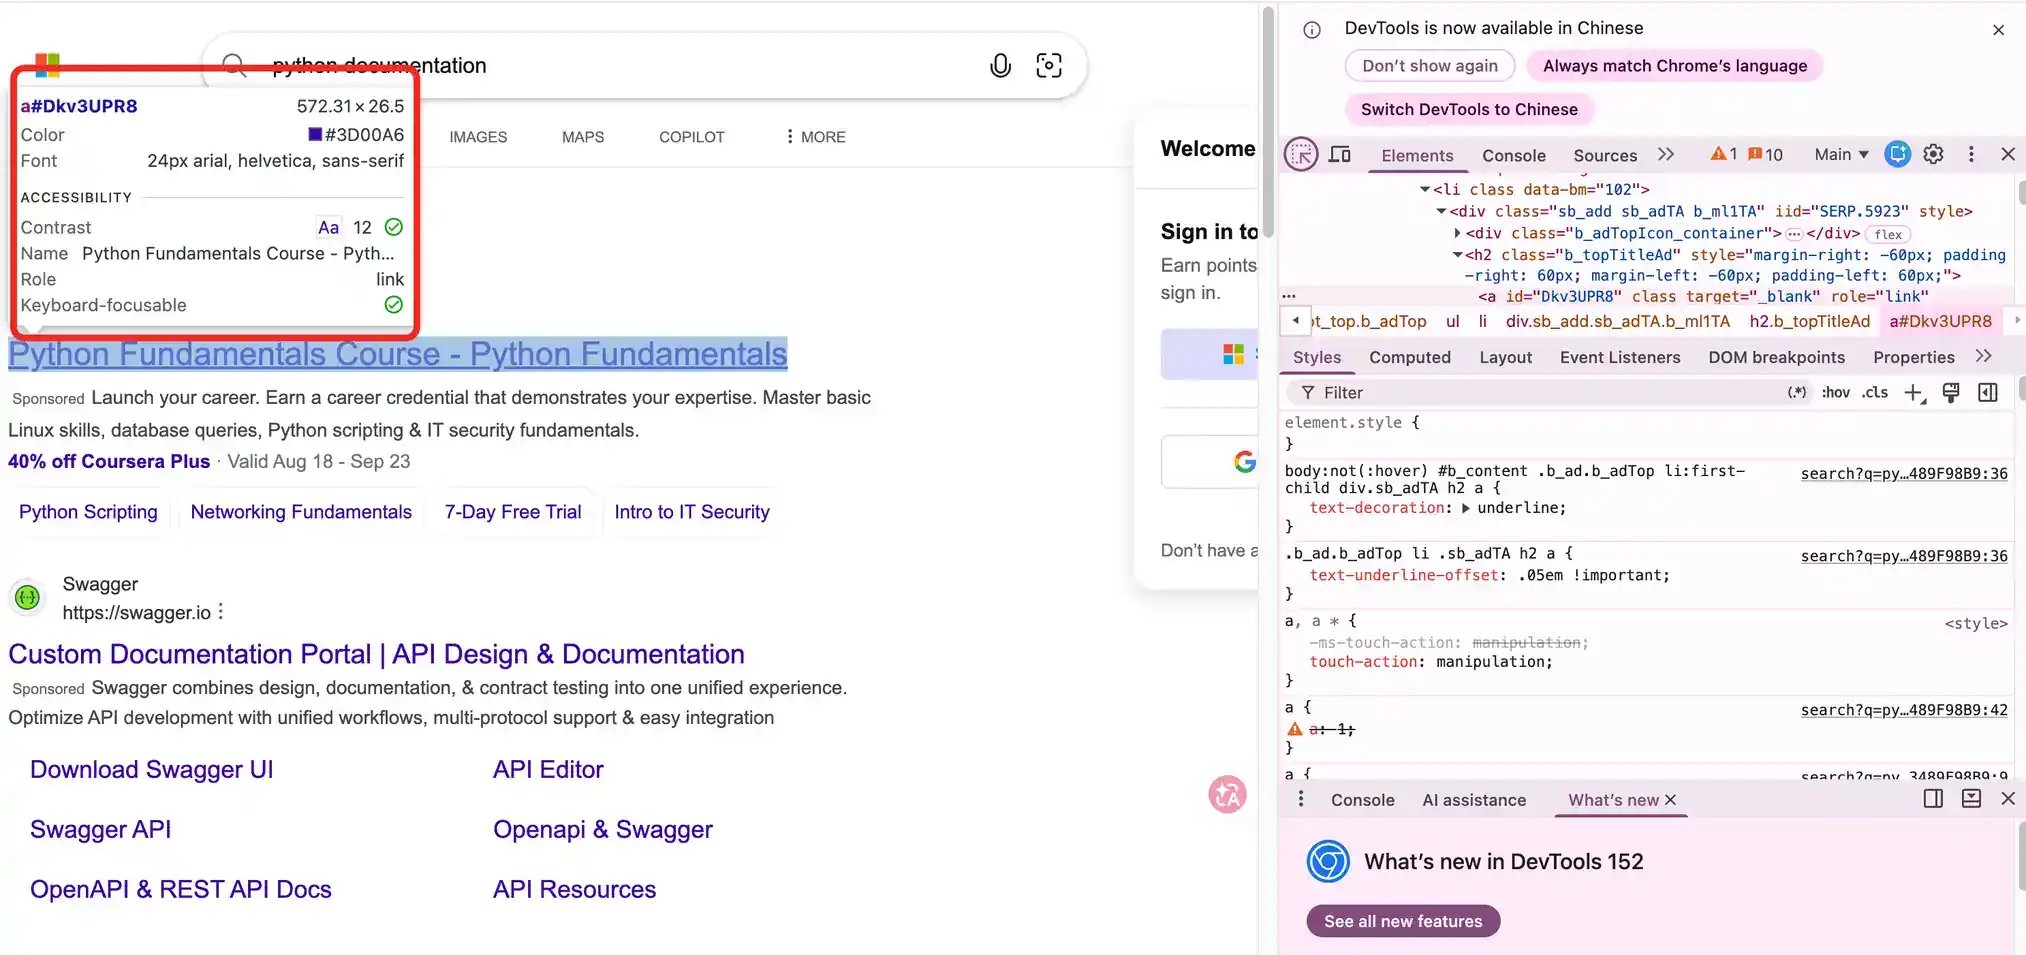
下图检查的是带Sponsored标记的广告:DOM中可见sb_ad和b_topTitleAd。这类节点不属于下文要提取的li.b_algo自然结果容器。
开始前请确认采集行为获得授权,并遵守Microsoft服务协议。如果出现访问拒绝或验证页面,应停止任务;本文不讨论绕过验证码。
准备Python Bing爬虫环境
创建虚拟环境并安装依赖
代码使用Python 3.10或更高版本的语法。以下是macOS/Linux终端的环境准备命令;具体依赖版本由安装结果决定,应在运行时记录:
mkdir bing-scraper
cd bing-scraper
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requests beautifulsoup4
Windows先执行py -m venv .venv。使用cmd时运行.venv\Scripts\activate.bat;使用PowerShell时运行.\.venv\Scripts\Activate.ps1。若激活脚本受执行策略限制,可以直接运行.\.venv\Scripts\python.exe -m pip install requests beautifulsoup4,后续也用该解释器执行脚本。
如果希望像截图一样逐个单元格检查输出,可以额外安装JupyterLab;运行普通.py文件则不需要它。
python -m pip install jupyterlab
python -m jupyterlab
在JupyterLab中新建Python 3 Notebook,运行以下代码,将解释器路径与项目虚拟环境核对,并记录实际版本;仅凭版本号相同不能确认内核一致:
import sys
import requests
import bs4
print("Executable:", sys.executable)
print("Python:", sys.version.split()[0])
print("Requests:", requests.__version__)
print("Beautiful Soup:", bs4.__version__)
创建脚本文件
新建bing_scraper.py,从下文“用Python验证响应”的导入语句开始,把各函数与最后的主流程按顺序放入同一文件。安装命令和上面的临时版本检查代码不要混入脚本。随稿同目录另附合并后的bing_scraper.py,内容与正文代码一致。
找到Bing页面中的搜索字段
先确认浏览器中显示的字段
打开python documentation的Bing搜索页,记录第一条自然结果的标题、显示URL和摘要。setlang=en-US只请求英文界面,不代表网络出口位于美国,也不保证结果全部是英文。
在Chrome中右键标题并选择“检查”,或者按Ctrl + Shift + I打开DevTools。在Elements面板中找到标题链接,再向外查看所在的h2和li。示例页面中的自然结果容器是li.b_algo,标题链接位于其中的h2 a;如果你的响应结构不同,应以实际HTML为准。
检查服务器实际返回的HTML
切换到Network,点击Doc,刷新页面,选择search请求并打开Response。搜索b_algo或刚才记录的标题,确认字段确实存在于响应HTML,而不是凭经验假定某个JSON接口一定存在。可参考Chrome Network面板文档。
Elements展示的是浏览器当前DOM,Response展示的是请求响应内容。最终解析器应以Python实际收到的HTML为准。如果浏览器能看到内容但Python没有,应比较响应域名、状态码、语言和页面内容。
用Python验证响应
下面的函数只允许Bing搜索地址,逐次检查重定向,并在403、429、非HTML响应或异常跳转时停止:
import argparse
import base64
import csv
import getpass
import json
import platform
import sys
import time
from datetime import datetime, timezone
from pathlib import Path
from urllib.parse import parse_qs, quote, urlencode, urljoin, urlsplit

import requests
from bs4 import BeautifulSoup
from importlib.metadata import version

def bing_url(url):
    p = urlsplit(url)
    return (p.scheme == "https" and p.hostname in
            {"www.bing.com", "cn.bing.com", "bing.com"}
            and p.path == "/search" and not p.username
            and p.port in (None, 443))

def fetch(session, url):
    for _ in range(5):
        if not bing_url(url):
            raise RuntimeError("Unexpected search URL; stopped.")
        r = session.get(url, timeout=(10, 30), allow_redirects=False)
        if r.is_redirect:
            url = urljoin(r.url, r.headers["Location"])
            continue
        if r.status_code == 429:
            retry_after = r.headers.get("Retry-After", "not provided")
            raise RuntimeError(f"HTTP 429; stopped. Retry-After: {retry_after}")
        if r.status_code == 403:
            raise RuntimeError("HTTP 403; stopped.")
        r.raise_for_status()
        if "text/html" not in r.headers.get("Content-Type", ""):
            raise RuntimeError("Expected HTML; stopped.")
        r.encoding = "utf-8"
        return r
    raise RuntimeError("Too many redirects; stopped.")
不同运行中,Requests可能被重定向到cn.bing.com,浏览器显示的标题也可能不同。这正是为什么要分别记录响应URL、时间和环境,而不能把浏览器截图与脚本结果混成一组证据。
用Python提取标题、链接和摘要
解析目标URL
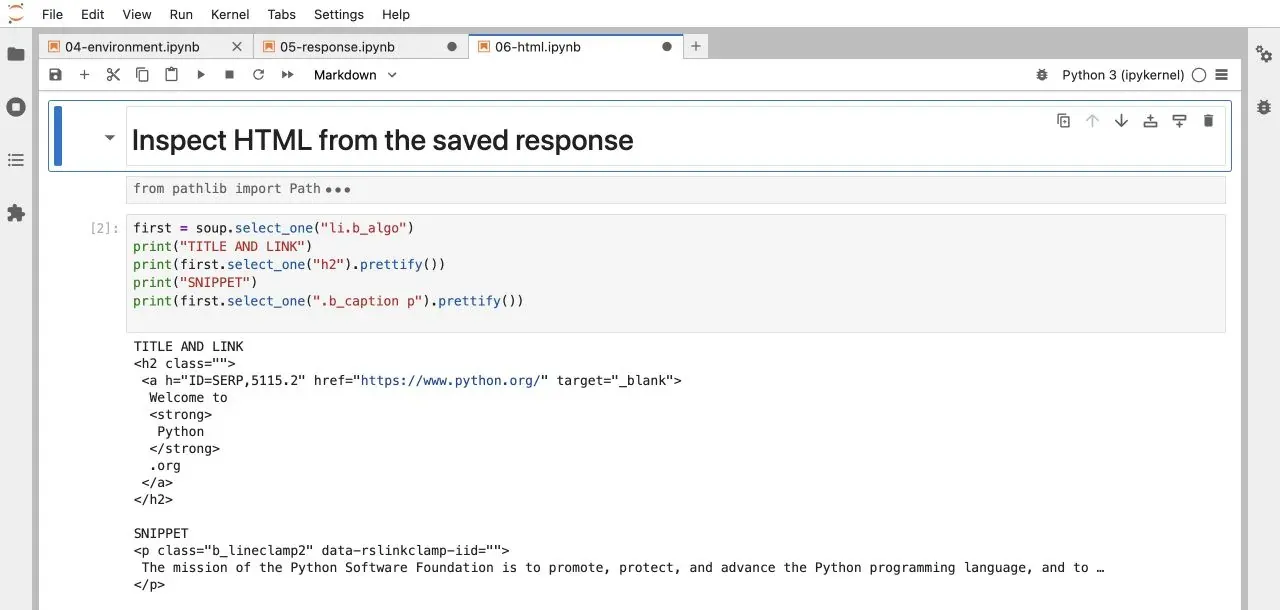
标题取自h2 a的文本,链接取自href。页面上展示的URL可能被截断,不能把cite文本当成完整地址。有些结果使用Bing /ck/a重定向链接,下面只在u参数符合已识别的a1编码格式时解码;无法确认时保留原始链接,不访问未知目标。
def destination(href, base_url):
    url = urljoin(base_url, href)
    p = urlsplit(url)
    if p.hostname in {"www.bing.com", "cn.bing.com", "bing.com"} and p.path == "/ck/a":
        value = parse_qs(p.query).get("u", [""])[0]
        if value.startswith("a1"):
            try:
                payload = value[2:]
                decoded = base64.urlsafe_b64decode(
                    payload + "=" * (-len(payload) % 4)
                ).decode("utf-8")
                if urlsplit(decoded).scheme in {"http", "https"}:
                    return decoded
            except (ValueError, UnicodeError):
                pass
    return url if p.scheme in {"http", "https"} else ""
提取自然结果并读取下一页
遍历每个li.b_algo,在容器内查找h2 a[href],摘要优先读取.b_caption p。摘要缺失时写入空字符串,不能因此丢掉整条结果。页内序号只根据实际提取到的自然结果递增,不把广告占位算进去。
def parse_page(html, page_url, query, page_number, fetched_at_utc):
    soup = BeautifulSoup(html, "html.parser")
    if soup.select_one('#b_captcha, iframe[src*="captcha"]'):
        raise RuntimeError("Verification page; stopped.")
    rows = []

    for item in soup.select("li.b_algo"):
        a = item.select_one("h2 a[href]")
        if a is None or not a.get_text(strip=True):
            continue
        url = destination(a["href"], page_url)
        if not url:
            continue
        snippet = item.select_one(".b_caption p") or item.select_one(
            "p.b_lineclamp2, p.b_lineclamp3")
        rows.append({
            "query": query, "page": page_number,
            "position_on_page": len(rows) + 1,
            "title": a.get_text(" ", strip=True), "url": url,
            "snippet": snippet.get_text(" ", strip=True) if snippet else "",
            "raw_href": a["href"],
            "source_url": page_url, "fetched_at_utc": fetched_at_utc,
        })
    if not rows:
        raise RuntimeError("No organic rows; inspect HTML, do not assume end.")
    link = soup.select_one("a.sb_pagN[href]")
    next_url = urljoin(page_url, link["href"]) if link else None
    if next_url and not bing_url(next_url):
        raise RuntimeError("Unexpected next-page URL; stopped.")
    return rows, next_url
保存的是Bing摘要,不是目标页面的完整描述。摘要可能被截断、改写或带日期,建议保留原文,再另建清洗字段。由于CSS选择器并非Bing承诺长期稳定的接口,应定期复核。
处理分页并导出CSV
使用页面提供的下一页链接
滚动到页面底部,检查右箭头按钮的href。优先读取a.sb_pagN,不要假设每页固定十条结果后手动拼接first=11、21。不同客户端的分页参数可能不同,读取当前页面提供的链接更容易保留查询条件。
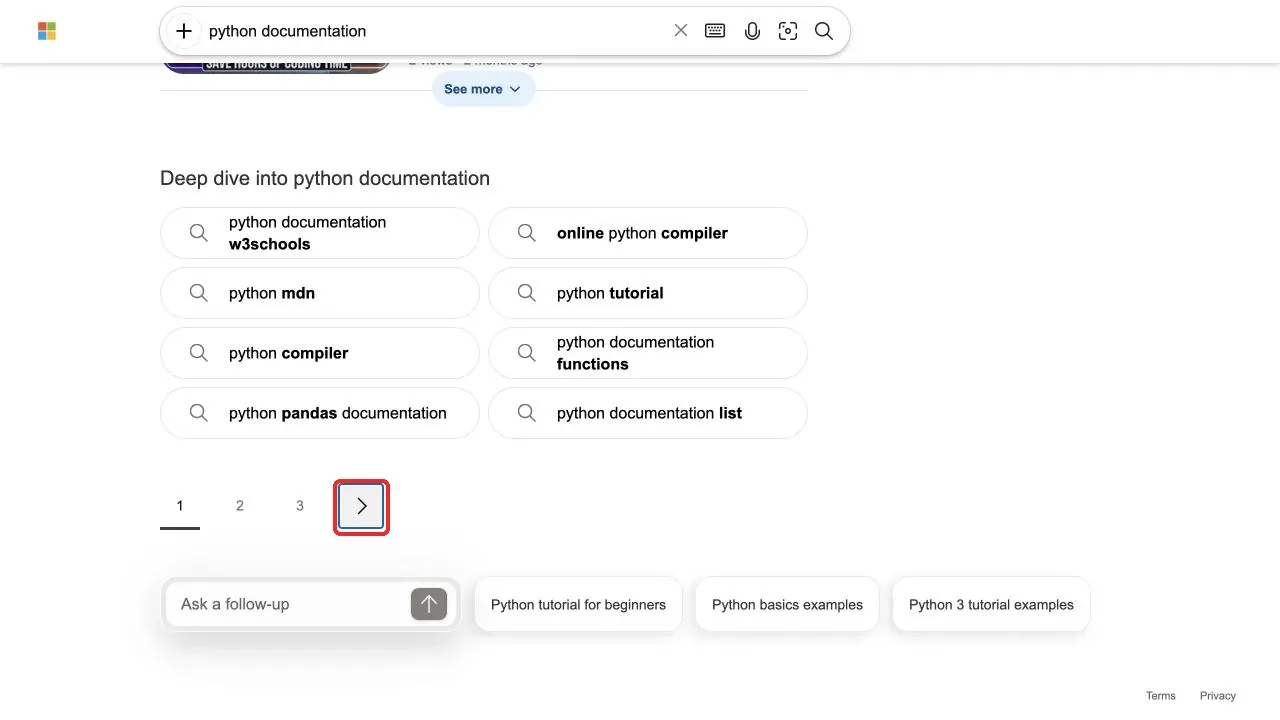
即使第二页返回HTTP 200,也可能重复第一页。本例按顺序保存每页的URL列表,仅在URL及其顺序完全相同时停止;它不执行逐条去重,也不能识别所有重排或部分重叠。没有下一页链接只表示当前模板下未找到分页入口,不证明已经获取全部搜索结果。
保存JSON与Excel可读的CSV
CSV使用UTF-8 BOM,Excel识别中文更稳定。来自网页的字符串如果以=、+、-、@开头,导出CSV时加一个单引号,避免被电子表格当作公式;JSON仍保留原始值。
def excel_safe(value):
    if isinstance(value, str):
        if value.lstrip().startswith(("=", "+", "-", "@")):
            return "'" + value
        if value.startswith(("\t", "\r", "\n")):
            return "'" + value
    return value

def save_rows(rows, folder):
    if not rows:
        raise RuntimeError("No data to export.")
    folder = Path(folder)
    folder.mkdir(parents=True, exist_ok=True)
    (folder / "results.json").write_text(
        json.dumps(rows, ensure_ascii=False, indent=2), encoding="utf-8")
    with (folder / "results.csv").open("w", encoding="utf-8-sig", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=list(rows[0]))
        writer.writeheader()
        writer.writerows({k: excel_safe(v) for k, v in r.items()} for r in rows)
抓取Bing搜索结果什么时候需要代理?
如果团队要在固定地区反复检查同一批关键词,稳定的网络出口可以减少一个变量。可参考 Rola IP静态住宅代理 了解产品特性;需要比较多个地区的搜索表现时,可参考 Rola IP住宅代理。静态住宅产品与动态住宅网络的配置方式应分开理解;下文使用通用的账密连接函数,不把动态网络的地区和会话参数套用于静态住宅产品。
代理负责提供网络出口,标题解析、分页停止和字段校验仍由脚本负责。需要把采集任务接入业务系统时,可参考 网络爬虫代理 场景说明。
获取连接参数
在Rola IP后台打开对应产品,复制其提供的代理主机、端口、代理账号及认证密码。Host只填写主机名或IPv4地址,Port单独填写数字;代理认证密码与网站登录密码不是同一概念。
按2026年9月29日查阅的代理参数文档,动态住宅IP支持国家、州和城市参数,动态机房与移动IP只支持国家级定位。动态网络的会话标识和时长应按该文档设置;静态住宅产品使用其自身连接信息,不直接追加这些参数。
本例使用用户名和密码认证。若账号开启了账密白名单限制,还需授权运行脚本机器的公网出口IP。API白名单接入是另一种方式,本例函数未实现该流程;两者区别可参阅Python代理接入。
在脚本中启用代理
将代理信息交给交互式函数输入,不要把用户名和密码写入源代码或命令行历史。以下支持HTTP与SOCKS5代理端点。访问Bing的HTTPS网址不代表代理地址必须以https://开头;这里的http描述与代理端点的连接协议,HTTPS目标通过隧道访问:
def configure_proxy(session):
    scheme = input("Proxy scheme (http/socks5h): ").strip()
    host = input("Proxy host only: ").strip()
    port = int(input("Proxy port: "))
    if scheme not in {"http", "socks5h"}:
        raise ValueError("Unsupported scheme.")
    if not host or any(c.isspace() or c in "/@?#:[]" for c in host):
        raise ValueError("Enter only the proxy hostname or IPv4 address.")
    if not 1 <= port <= 65535:
        raise ValueError("Invalid port.")
    user = getpass.getpass("Proxy username (hidden): ")
    password = getpass.getpass("Proxy password (hidden): ")
    if not user or not password:
        raise ValueError("This example requires username/password authentication.")
    auth = quote(user, safe="") + ":" + quote(password, safe="")
    proxy = f"{scheme}://{auth}@{host}:{port}"
    session.proxies.update({"http": proxy, "https": proxy})
python bing_scraper.py "python documentation" --pages 1 --proxy
使用SOCKS5时先安装额外依赖,并选择socks5h:
python -m pip install "requests[socks]"
其中socks5h表示由代理端解析目标主机名,不等于SOCKS传输本身自动加密。脚本中的session.trust_env=False可避免环境变量意外覆盖显式配置;如果企业网络需要自定义CA,应显式指定证书文件,不要关闭TLS校验。
运行与核验
先用--pages 1 --proxy运行一页,按提示输入对应产品的连接信息。检查输出中的响应主机与自然结果数,再将JSON中的前三条标题、链接和摘要与同批HTML核对。代理是否配置成功不能只看HTTP 200,也不能由cn.bing.com或www.bing.com推断出口国家;地区核验需另用同一Session访问可信的出口查询服务,并与所选地区比较。本文未提供代理实测结论。
一个完整的采集流程
把前面的函数放入bing_scraper.py后,可以用下面的主流程限制页数、保存原始HTML、检测重复页面,并在任务结束时导出数据:
def scrape(query, max_pages=2, proxy=False):
    if not 1 <= max_pages <= 3:
        raise ValueError("This example supports 1 to 3 pages.")
    folder = Path("runs") / datetime.now().strftime("%Y%m%d-%H%M%S-%f")
    folder.mkdir(parents=True)
    session = requests.Session()
    session.trust_env = False
    session.headers["Accept-Language"] = "en-US,en;q=0.9"
    url = "https://www.bing.com/search?" + urlencode({"q": query, "setlang": "en-US"})
    all_rows, seen_pages, seen_signatures = [], set(), set()
    run_meta = {
        "started_at_utc": datetime.now(timezone.utc).isoformat(),
        "os": platform.platform(), "python": sys.version,
        "requests": version("requests"), "beautifulsoup4": version("beautifulsoup4"),
        "query": query, "max_pages": max_pages, "proxy_enabled": proxy,
        "accept_language": session.headers["Accept-Language"],
        "timeout_seconds": [10, 30], "page_interval_seconds": 5,
        "automatic_retries": 0, "pages": [], "stop_reason": "not started",
    }
    try:
        if proxy:
            configure_proxy(session)
        for page in range(1, max_pages + 1):
            if url in seen_pages:
                run_meta["stop_reason"] = "Repeated request URL"
                break
            seen_pages.add(url)
            r = fetch(session, url)
            fetched_at_utc = datetime.now(timezone.utc).isoformat(timespec="seconds")
            page_meta = {"page": page, "source_url": r.url,
                         "fetched_at_utc": fetched_at_utc, "http_status": r.status_code}
            run_meta["pages"].append(page_meta)
            (folder / f"page-{page}.html").write_text(r.text, encoding="utf-8")
            rows, next_url = parse_page(r.text, r.url, query, page, fetched_at_utc)
            page_meta["organic_rows"] = len(rows)
            print(f"Response host: {urlsplit(r.url).hostname}")
            signature = tuple(row["url"] for row in rows)
            if signature in seen_signatures:
                run_meta["stop_reason"] = "Repeated ordered URL signature"
                print("Repeated page; stopped.")
                break
            seen_signatures.add(signature)
            all_rows.extend(rows)
            print(f"Page {page}: HTTP {r.status_code}, {len(rows)} organic rows")
            if not next_url:
                run_meta["stop_reason"] = "No next-page link found"
                break
            if page == max_pages:
                run_meta["stop_reason"] = "Requested page limit reached"
                break
            url = next_url
            time.sleep(5)
    except requests.RequestException as exc:
        # Do not persist proxy URLs or credentials from exception messages.
        run_meta["stop_reason"] = type(exc).__name__
        raise RuntimeError(f"{type(exc).__name__}; check network or proxy settings.") from None
    except (RuntimeError, ValueError, OSError) as exc:
        run_meta["stop_reason"] = str(exc)
        raise
    finally:
        session.close()
        run_meta["finished_at_utc"] = datetime.now(timezone.utc).isoformat()
        run_meta["saved_rows"] = len(all_rows)
        (folder / "run.json").write_text(
            json.dumps(run_meta, ensure_ascii=False, indent=2), encoding="utf-8")
        print("Stopped:", run_meta["stop_reason"])
        if all_rows:
            save_rows(all_rows, folder)
            print(f"Saved {len(all_rows)} rows to {folder}")
    return all_rows, folder

if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("query")
    parser.add_argument("--pages", type=int, default=2)
    parser.add_argument("--proxy", action="store_true")
    args = parser.parse_args()
    scrape(args.query, args.pages, args.proxy)
运行:
python bing_scraper.py "python documentation" --pages 2
程序在runs下建立独立目录,保存收到的HTML与run.json。只在提取到有效记录时生成results.json和results.csv;后续页失败时仍保留已取得的数据。run.json记录系统和依赖版本、请求配置、响应URL、每页接收时间与停止原因,不保存代理凭据。
fetched_at_utc是接收响应后的UTC时间,由主流程传入解析器。离线重解析时,从同批run.json读取对应页面的采集时间,不能用重解析时的当前时间替代。代理类型、所选地区和实际运行命令另记入脱敏记录,避免混用不同批次的数据。
打开CSV时选择UTF-8编码,并核对第一条标题、URL、摘要是否与同一目录下的HTML对应。需要真正的.xlsx文件时,应在Excel中导入CSV后另存为工作簿,不要只修改文件扩展名。
常见故障与排查方法
| 现象 | 先检查什么 | 处理方式 |
|---|---|---|
| HTTP 200但没有自然结果 | HTML是否为验证页或新模板 | 停止并检查响应,不要把空列表当成功 |
| HTTP 403 | 访问权限和目标站规则 | 停止并确认访问条件,不持续更换出口重试 |
| HTTP 429 | 请求频率及Retry-After响应头 | 停止;记录提示的等待秒数或HTTP日期,恢复不得早于该时间 |
| ConnectTimeout或ReadTimeout | 到代理/目标的连接或响应耗时 | 分别检查网络和端点,排除问题后单页复测,不无限重试 |
| ConnectionError | DNS解析、连接拒绝或链路中断 | 检查主机名、端口和网络;先诊断,避免直接归因于IP质量 |
407或ProxyError |
协议、端口、认证和白名单 | 对照控制台参数单独验证代理连接 |
被重定向到cn.bing.com |
跳转、网络地区和语言条件 | 记录真实域名,不要声称获得美国结果 |
| 第二页重复第一页 | 下一页链接和实际响应 | 对比链接序列,停止重复循环 |
| 浏览器和Python标题不同 | 地区、Cookie、客户端和采集时间 | 分开保存证据,不要混合排名数据 |
| Excel中文乱码 | CSV编码和导入方式 | 按UTF-8导入,同时保留JSON |
成功判据是取得有效自然结果,并能将前三条输出与同批HTML逐字段对应,不是仅收到HTTP 200。换关键词时先只抓一页,确认字段来自预期容器;现有验证码检查仅覆盖代码列出的节点,出现其他异常页面也应停止检查。
本例不自动重试。429响应若未提供Retry-After,先查明限流原因与平台规则,再决定是否恢复;不要立即循环重启任务。
什么时候应该使用Bing SERP API
手写HTML解析适合学习页面结构、验证少量字段和进行小规模实验。如果业务需要大量关键词、稳定字段、多设备结果或广告组件,应比较第三方SERP API的覆盖范围、价格、数据使用条款和错误处理,而不能只看单次调用价格。
按2026年9月29日查阅的公告,Microsoft旧版Bing Search API已于2025年8月11日停止服务,详情见Microsoft公告。第三方接口不能描述为Microsoft官方接口。以DataForSEO Bing SERP API文档为例,Live模式即时返回,Standard模式则先排队再取回;即便HTTP 200,也要检查任务状态并筛选organic类型。
总结
可靠的Bing搜索结果抓取,关键在于让页面位置、解析逻辑和导出记录保持一致:先确认自然结果容器,再逐字段提取标题、链接和摘要;分页时检测重复页面;导出时保留来源URL与时间。如果需要固定地区或稳定会话,再在请求层接入Rola IP。这样得到的数据才可追溯、可复核,也更适合后续SEO分析。