
Парсинг Reddit на Python: посты, комментарии и ответы через PRAW
15 окт. 2026 г. · Руководства · 14 мин. чтения
Для парсинга Reddit на Python используйте PRAW с одобренным доступом к Data API. Сохраняйте post_id, comment_id и parent_id, чтобы восстановить связи между ответами. Скрипт ниже выгружает посты и комментарии в отдельные CSV-файлы. Число строк и раскрытие MoreComments ограничиваются отдельно: ограничение выгрузки не отменяет уже выполненные запросы.
Руководство рассчитано на разработчиков и аналитиков: можно изучать темы в сабреддите, находить обсуждения по ключевым словам и разбирать вопросы в комментариях. Основной способ сбора — API; разбор HTML показан отдельно для полей, видимых на публичной странице.
Проверка кода: офлайн-тесты выполнены в Windows 10 с Python 3.12.10 28 сентября 2026 года и повторены 14 октября 2026 года. Они проверяют обработку данных и ошибок, но не подтверждают подключение к Reddit API или прокси.
Какие данные можно собрать с Reddit
Через доступные интерфейсы Reddit можно получить сведения о сообществах, посты и комментарии. Для восстановления обсуждения нужны post_id, comment_id и parent_id; одного текста комментария недостаточно.
| Объект | Основные поля | Для чего использовать |
|---|---|---|
| Сабреддит | Название, описание, число участников, открытые атрибуты | Определить тематику выборки и контекст сообщества |
| Пост | Заголовок, текст, автор, время публикации, рейтинг, число комментариев, URL | Исследовать темы, отслеживать обсуждения, группировать вопросы |
| Комментарий или ответ | Текст, автор, время, рейтинг, post_id, parent_id |
Анализировать обратную связь и связи между репликами |
| Публичная активность пользователя | Открытые посты, комментарии и ссылки на них | Изучать публичный контент в пределах разрешённой задачи |
Рейтинг и число комментариев меняются. Удалённый или скрытый контент может быть недоступен. Поэтому вместе с записью сохраняйте название сообщества, прямую ссылку и время сбора: так проще проверить источник и сопоставить разные выгрузки.
Число комментариев на странице не обязано совпадать с количеством строк в CSV. На выборку влияют доступ, удаление контента, ограничения экспортёра и глубина загрузки дерева комментариев.
Готовый скрипт по умолчанию не сохраняет имена авторов. Включайте это поле только при необходимости. До сбора определите срок хранения данных и порядок обработки запросов на удаление.
Как выбрать способ парсинга Reddit
Для регулярной выгрузки структурированных данных удобнее Reddit Data API и PRAW. Разбор HTML подходит для проверки небольшого числа доступных публичных страниц, когда нужные поля уже присутствуют в ответе.
| Способ | Когда подходит | Что учитывать |
|---|---|---|
| Reddit Data API + PRAW | Есть одобренные OAuth-реквизиты; нужны стабильные поля и пакетная выгрузка | Соблюдайте лимиты API; PRAW обрабатывает объекты и пагинацию |
| HTML + BeautifulSoup | Нужно проверить видимые данные на нескольких доступных страницах | Проверяйте содержимое ответа и селекторы: разметка меняется |
| Готовые шаблоны без программирования | Известны URL нескольких постов; нужен результат в Excel или CSV | Уточняйте поддержку ссылок, вложенных ответов и экспортируемых полей |
При выборе метода учитывайте воспроизводимость сбора и возможность разобраться в ошибках. HTTP 200 ещё не означает, что сервер вернул пост: вместо него может прийти страница входа или проверки доступа.
Перед подключением изучите условия Reddit Data API, ограничения одобренного сценария и требования к хранению данных. PRAW — клиент API: установка библиотеки не даёт приложению разрешение на доступ.
Настройка Reddit API в Python через PRAW
Для подключения нужны client_id, client_secret и отдельный user_agent, который идентифицирует приложение. Проверяйте доступ реальным запросом: создание объекта сабреддита само по себе не подтверждает соединение с API.
- Установите Python 3.10 или новее.
- Откройте PRAW Quick Start и перейдите по ссылке First Steps Guide к инструкции Reddit по регистрации приложения. Получите доступ для своего сценария и подготовьте
client_idиclient_secret. Наличие этих значений само по себе не подтверждает одобрение задачи. - Передайте реквизиты через переменные окружения или хранилище секретов.
- Установите зависимости и запросите один пост.
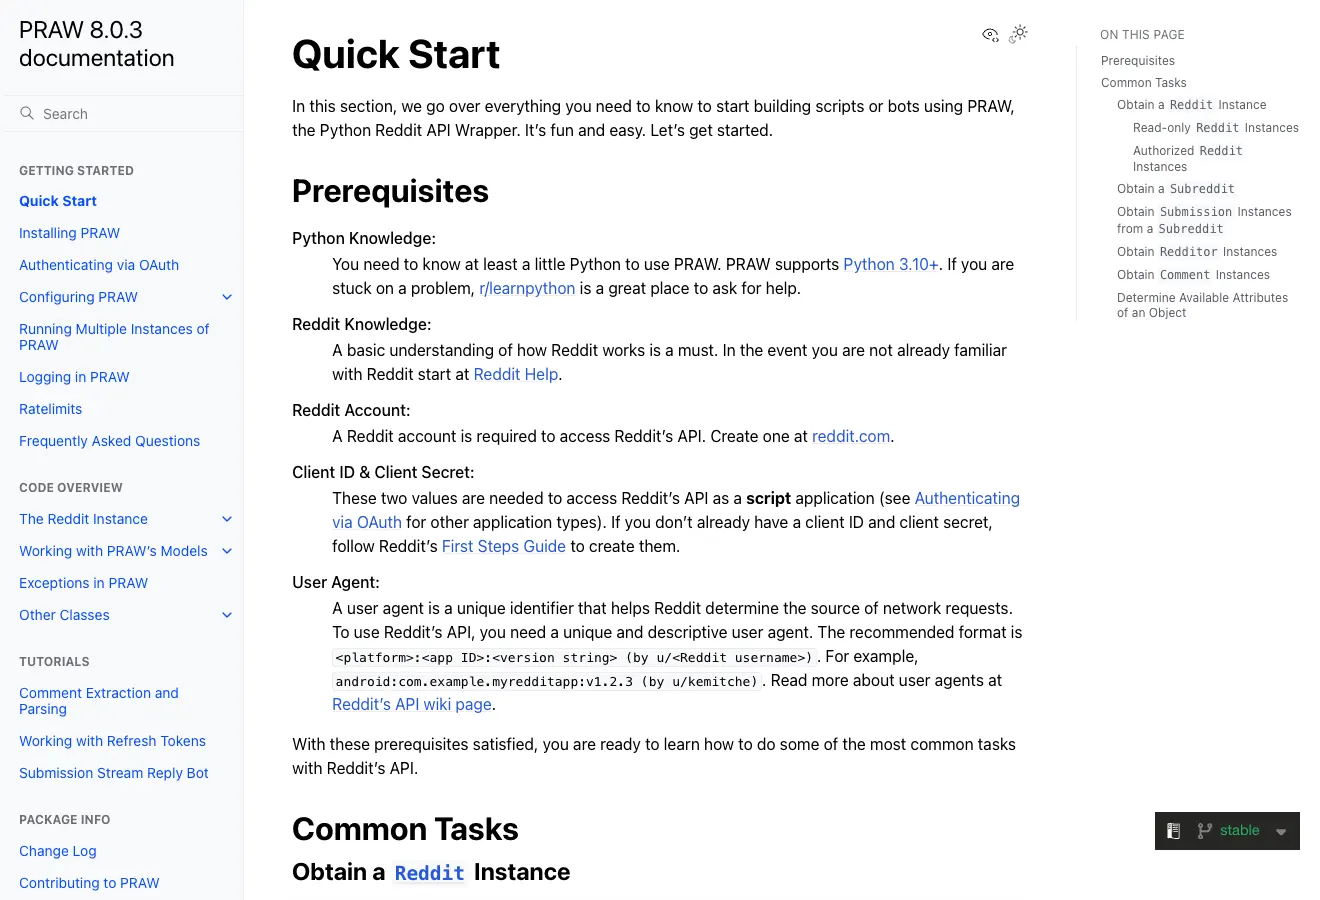
Рисунок 1. Раздел PRAW Quick Start с параметрами доступа.
В PRAW Quick Start описано подключение в режиме чтения: для него нужны client_id, client_secret и user_agent, без логина и пароля пользователя. Условия Reddit Data API и разделы PRAW Quick Start и Comment Extraction проверены 14 октября 2026 года.
Установка и переменные окружения
Команды ниже рассчитаны на macOS и Linux. В PowerShell используйте $env:REDDIT_CLIENT_ID="your_client_id"; аналогично задайте REDDIT_CLIENT_SECRET и REDDIT_USER_AGENT. Значения в примере — заполнители. Передавайте настоящие секреты безопасным способом, чтобы они не попадали в сохранённую историю команд.
Пример 1. Установка зависимостей и настройка окружения
python -m pip install beautifulsoup4==4.15.0 certifi==2026.7.22 charset-normalizer==3.5.1 defusedxml==0.7.1 idna==3.20 praw==8.0.3 prawcore==4.0.0 requests==2.34.2 soupsieve==2.10 typing_extensions==4.16.0 update_checker==1.0.0 urllib3==2.8.0 websocket-client==1.9.2
export REDDIT_CLIENT_ID="your_client_id"
export REDDIT_CLIENT_SECRET="your_client_secret"
export REDDIT_USER_AGENT="macos:research-export:1.0 (by u/your_name)"
Проверка доступа к API
Следующий пример запрашивает один новый пост из r/Python. Если API вернул запись, скрипт выводит её идентификатор. Пустая выдача сама по себе не означает ошибку авторизации.
Пример 2. Проверка подключённого приложения
import os
import praw

reddit = praw.Reddit(
    client_id=os.environ["REDDIT_CLIENT_ID"],
    client_secret=os.environ["REDDIT_CLIENT_SECRET"],
    user_agent=os.environ["REDDIT_USER_AGENT"],
    timeout=20,
    ratelimit_seconds=0,
    check_for_updates=False,
)
try:
    posts = list(reddit.subreddit("Python").new(limit=1))
    if posts:
        print("API returned post:", posts[0].id)
    else:
        print("Listing returned no posts; inspect scope and community.")
except Exception as exc:
    # Avoid printing raw exception URLs or credentials.
    print("API check failed:", type(exc).__name__)
    raise SystemExit(1)
PRAW может хранить название сабреддита без сетевого запроса. Поэтому вывод reddit.subreddit("Python") не заменяет проверку выдачи. При HTTP 401 или 403 сначала проверьте статус приложения, реквизиты и разрешённый объём доступа.
Сбор постов из сабреддита и пагинация
PRAW получает посты через генераторы выдачи и использует курсоры API для перехода к следующей порции данных. Параметр limit задаёт число запрашиваемых записей, но не отменяет квоты и ограничения доступа.
- Выберите сабреддит и порядок выдачи:
new— новые посты,hot— популярные сейчас,top— посты с высоким рейтингом за выбранный период. - Задайте
limit. Дляtopукажите период черезtime_filter, напримерweekилиmonth. - Сохраните идентификатор, текст, ссылки и время публикации.
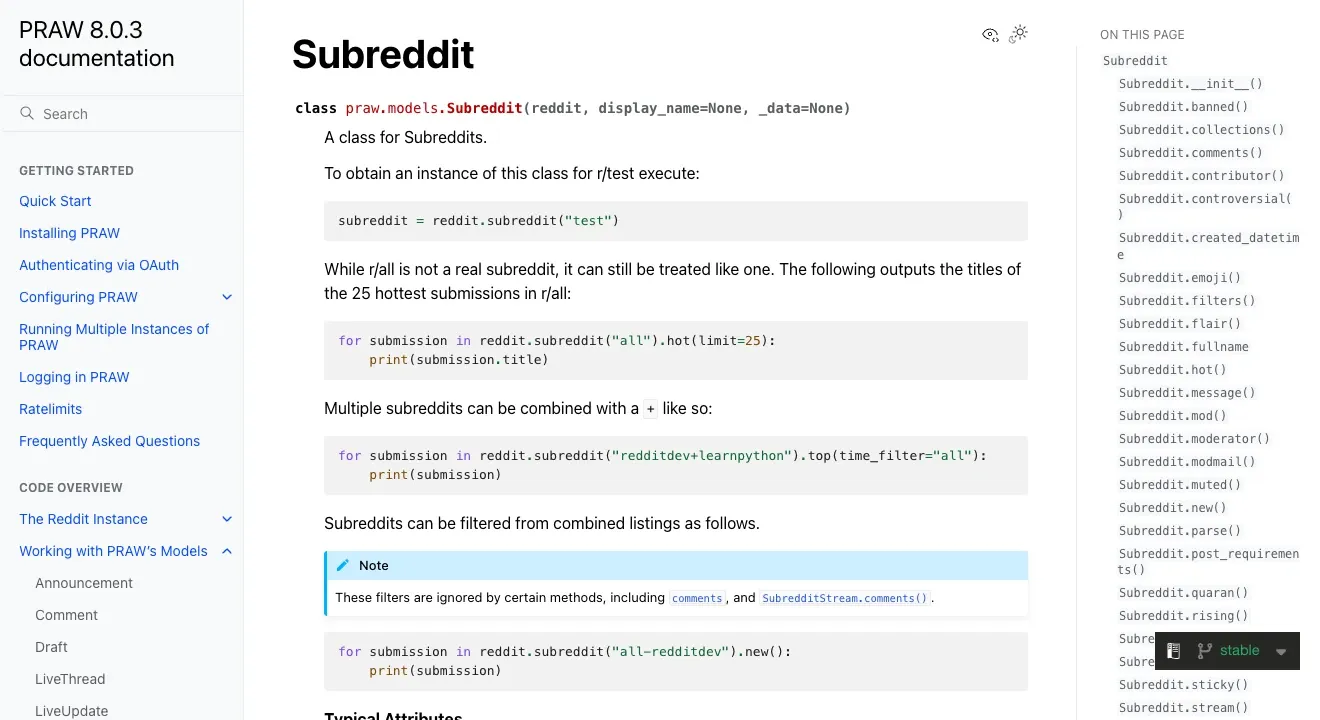
Рисунок 2. Методы объекта Subreddit для выдачи и поиска.
Пример 3. Десять новых постов и десять лучших постов за неделю
subreddit = reddit.subreddit("Python")
for post in subreddit.new(limit=10):
    print(post.id, post.title, post.score, post.num_comments)

for post in subreddit.top(time_filter="week", limit=10):
    print(post.id, post.title)
Если нужны только посты, загружать дополнительные комментарии не требуется. Не смешивайте поля текста и ссылки:
title— заголовок;selftext— текст поста; у публикации со ссылкой он может быть пустым;url— адрес опубликованного материала, например внешней страницы или медиа;permalink— ссылка на обсуждение на Reddit.
Сохраняйте и selftext, и url: пустое текстовое поле не означает, что в посте нет содержания.
Пример 4. Основные поля одного поста
from datetime import datetime, timezone

row = {
    "post_id": post.id,
    "title": post.title,
    "body": post.selftext or "",
    "url": post.url,
    "permalink": "https://www.reddit.com" + post.permalink,
    "created_at_utc": datetime.fromtimestamp(post.created_utc, timezone.utc).isoformat(),
}
Этот фрагмент использует объект post, полученный при переборе выдачи в предыдущем примере. Время преобразуется в ISO 8601 с часовым поясом UTC.
Поиск постов Reddit по ключевым словам
Метод search() ищет посты внутри выбранного сабреддита с заданной сортировкой и периодом. Его выдача подходит для тематической выборки, но не представляет полный исторический архив.
- Ограничьте поиск нужным сообществом.
- Укажите запрос, сортировку и временной диапазон.
- Проверьте несколько первых результатов, прежде чем увеличивать выборку.
Пример 5. Поиск постов за последний месяц по слову proxy
results = reddit.subreddit("Python").search(
    "proxy", sort="new", time_filter="month", limit=20)
for post in results:
    print(post.id, post.title, post.permalink)
Замените proxy термином, который соответствует вашей задаче. На результаты влияют индексация Reddit, права доступа и удаление публикаций. Для сравнения нескольких сообществ используйте одинаковые условия поиска и сохраняйте их вместе с результатами.
Получение отдельного поста и описания сообщества
Если известен ID поста, используйте reddit.submission(id=...): искать обсуждение заново через общую выдачу не нужно. ID находится после /comments/ в URL и не включает остальную часть адреса.
Пример 6. Пост по идентификатору и открытое описание сабреддита
post = reddit.submission(id="replace_with_post_id")
print(post.title)
print(post.selftext)
print(post.url)
print(post.score, post.num_comments)

community = reddit.subreddit("Python")
print(community.display_name, community.public_description)
Замените replace_with_post_id реальным идентификатором доступного поста. Открытые атрибуты сообщества запрашиваются отдельно; некоторые поля, включая описание, могут быть пустыми.
Парсинг комментариев Reddit и вложенных ответов
Для сбора комментариев загрузите пост, задайте предел раскрытия узлов MoreComments и обойдите дерево через comments.list(). Сохраните родительский ID каждой реплики, чтобы затем восстановить цепочки ответов.
- Получите объект обсуждения через
reddit.submission(). - Вызовите
replace_more(limit=2), чтобы ограничить число раскрываемых узлов. Приlimit=0библиотека убирает заглушки без дополнительного раскрытия. - Для каждого комментария сохраните
post_id,comment_id,parent_idи ссылку.
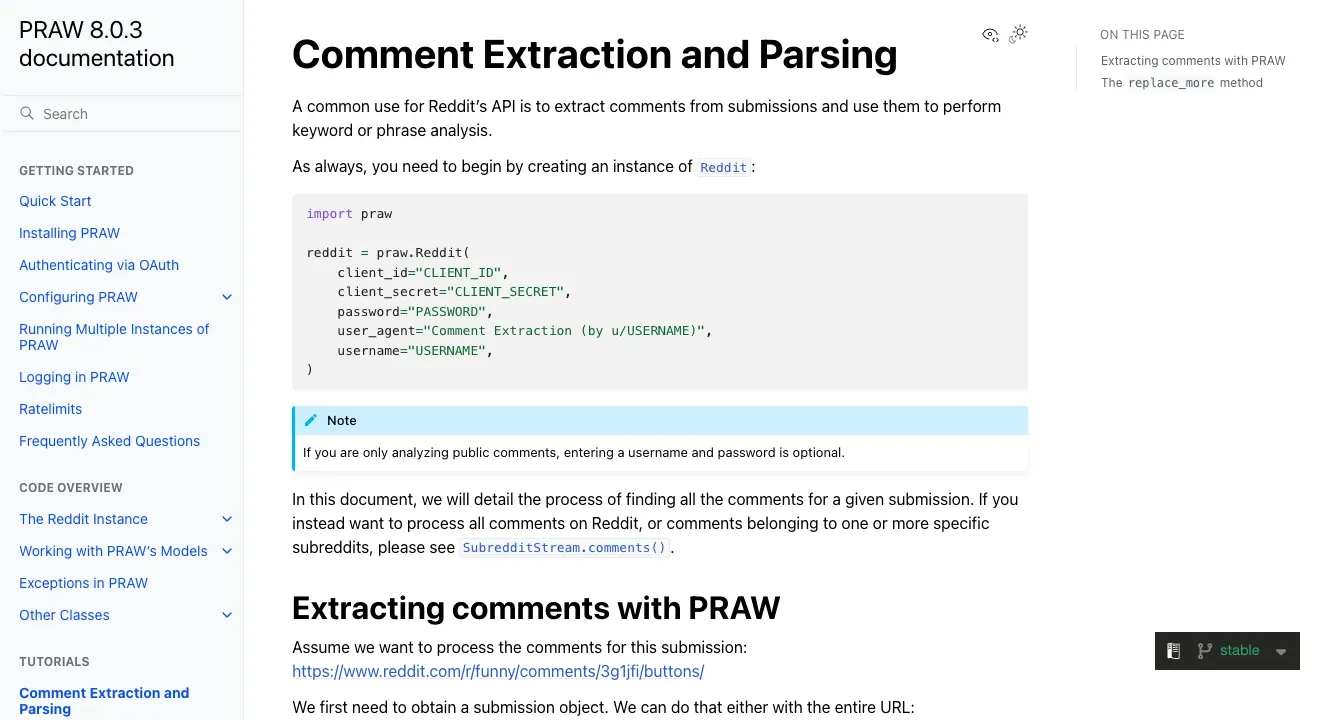
Рисунок 3. Руководство PRAW по загрузке и обработке комментариев.
Пример 7. Ограниченное раскрытие дерева с сохранением связей между ответами
post = reddit.submission(id="replace_with_post_id")
post.comments.replace_more(limit=2)
for comment in post.comments.list()[:50]:
    print({
        "post_id": post.id,
        "comment_id": comment.id,
        "parent_id": comment.parent_id,
        "body": comment.body,
        "permalink": "https://www.reddit.com" + comment.permalink,
    })
Префикс в parent_id показывает тип родительского объекта:
| Значение | Родитель реплики |
|---|---|
t3_… |
Пост: обычно так обозначается родитель комментария верхнего уровня |
t1_… |
Комментарий: обычно так обозначается родитель вложенного ответа |
replace_more(limit=None) пытается загрузить все оставшиеся узлы MoreComments, которые удовлетворяют порогу threshold. Каждая замена требует сетевого запроса и может вернуть новые узлы, поэтому большое обсуждение загружается дольше. При limit=0 остаются уже загруженные комментарии, а заглушки удаляются.
Срез [:50] ограничивает итоговое число комментариев, но не сокращает запросы, уже потраченные на раскрытие дерева. После обрезки выборки родитель ответа может отсутствовать в CSV: сохранённый parent_id не гарантирует наличие соответствующей строки.
Подробности работы с деревом — в руководстве PRAW по комментариям.
Выгрузка данных Reddit в CSV: готовый скрипт
Храните посты и комментарии в двух таблицах: reddit_posts.csv и reddit_comments.csv. Поле post_id связывает таблицы, а parent_id сохраняет иерархию ответов.
Сохраните код ниже в UTF-8 как reddit_scraper_v2.py. Это самостоятельный скрипт: он содержит импорты, параметры запуска, настройку подключения, экспорт и обработку ошибок.
Пример 8. Полный экспортёр постов и комментариев
"""Small authorized Reddit exports. No credentials or raw exception URLs are logged."""
import argparse
import csv
import json
import logging
import os
import sys
import time
from datetime import datetime, timezone
from pathlib import Path

import praw
import requests

POST_FIELDS = ["subreddit", "post_id", "title", "body", "author", "created_at_utc",
               "collected_at_utc", "score", "num_comments", "url", "permalink"]
COMMENT_FIELDS = ["subreddit", "post_id", "comment_id", "parent_id", "body",
                  "author", "created_at_utc", "collected_at_utc", "score", "permalink"]


def utc(seconds=None):
    return datetime.fromtimestamp(seconds if seconds is not None else time.time(),
                                  timezone.utc).isoformat()


def post_row(post, include_authors=False):
    return dict(subreddit=post.subreddit.display_name, post_id=post.id,
                title=post.title, body=post.selftext or "",
                author=str(post.author) if include_authors and post.author else "",
                created_at_utc=utc(post.created_utc), collected_at_utc=utc(),
                score=post.score, num_comments=post.num_comments, url=post.url,
                permalink="https://www.reddit.com" + post.permalink)


def comment_row(comment, post, include_authors=False):
    return dict(subreddit=post.subreddit.display_name, post_id=post.id,
                comment_id=comment.id, parent_id=comment.parent_id, body=comment.body,
                author=str(comment.author) if include_authors and comment.author else "",
                created_at_utc=utc(comment.created_utc), collected_at_utc=utc(),
                score=comment.score, permalink="https://www.reddit.com" + comment.permalink)


def safe_cell(value):
    # Protect spreadsheet users from untrusted formula-like text.
    if isinstance(value, str) and value.lstrip().startswith(("=", "+", "-", "@")):
        return "'" + value
    return value


def write_csv(path, fields, rows):
    with path.open("w", encoding="utf-8-sig", newline="") as handle:
        writer = csv.DictWriter(handle, fieldnames=fields)
        writer.writeheader()
        writer.writerows({key: safe_cell(value) for key, value in row.items()} for row in rows)


def make_client():
    # Library retry messages may include request details; emit only our sanitized errors.
    logging.getLogger("prawcore").disabled = True
    logging.getLogger("praw").disabled = True
    names = ["REDDIT_CLIENT_ID", "REDDIT_CLIENT_SECRET", "REDDIT_USER_AGENT"]
    if any(not os.environ.get(name) for name in names):
        raise ValueError("Set REDDIT_CLIENT_ID, REDDIT_CLIENT_SECRET and REDDIT_USER_AGENT.")
    session = requests.Session()
    session.trust_env = False  # Explicit proxy configuration; no accidental inherited route.
    proxy = os.environ.get("ROLA_PROXY_URL")
    if proxy:
        if not proxy.startswith(("http://", "https://")):
            raise ValueError("ROLA_PROXY_URL must be an HTTP(S) proxy URL.")
        session.proxies.update(http=proxy, https=proxy)
    return praw.Reddit(client_id=os.environ[names[0]], client_secret=os.environ[names[1]],
                       user_agent=os.environ[names[2]], requestor_kwargs={"session": session},
                       timeout=20, ratelimit_seconds=0, check_for_updates=False)


def export(reddit, args):
    # Refuse to overwrite an existing export, including one from a failed attempt.
    folder = Path(args.output_dir)
    folder.mkdir(parents=True, exist_ok=False)
    posts, comments = [], []
    start = time.monotonic()
    state = {"status": "running", "started_at_utc": utc(),
             "mode": "single" if args.post_id else "search" if args.query else "new",
             "post_limit": args.limit, "comments_per_post": args.comments_per_post,
             "more_limit": args.more_limit, "include_authors": args.include_authors,
             "proxy_enabled": bool(os.environ.get("ROLA_PROXY_URL")),
             "coverage": "bounded sample; not a complete archive"}
    failure = None
    try:
        if args.post_id:
            source = [reddit.submission(id=args.post_id)]
        elif args.query:
            source = reddit.subreddit(args.subreddit).search(
                args.query, sort="new", time_filter="month", limit=args.limit)
        else:
            source = reddit.subreddit(args.subreddit).new(limit=args.limit)
        for post in source:
            if time.monotonic() - start >= args.max_seconds:
                state["status"] = "stopped_at_time_budget"
                break
            posts.append(post_row(post, args.include_authors))  # Forces server attributes.
            if args.comments_per_post:
                post.comments.replace_more(limit=args.more_limit)
                for comment in post.comments.list()[:args.comments_per_post]:
                    comments.append(comment_row(comment, post, args.include_authors))
        else:
            state["status"] = "completed" if posts else "completed_empty"
    except Exception as exc:
        failure = exc
        state["status"] = "failed_partial"
        state["error_type"] = type(exc).__name__
        response = getattr(exc, "response", None)
        if response is not None:
            state["http_status"] = response.status_code
            state["retry_after"] = response.headers.get("Retry-After")
    finally:
        write_csv(folder / "reddit_posts.csv", POST_FIELDS, posts)
        write_csv(folder / "reddit_comments.csv", COMMENT_FIELDS, comments)
        state.update(finished_at_utc=utc(), posts=len(posts), comments=len(comments))
        (folder / "run_metadata.json").write_text(json.dumps(state, indent=2), encoding="utf-8")
    if failure:
        # Do not print exception messages that can contain credentials or URLs.
        print("Export stopped: " + type(failure).__name__ +
              ". Inspect run_metadata.json; partial files are not a successful run.", file=sys.stderr)
        return 1
    print(json.dumps(state, indent=2))
    return 0 if state["status"] in ("completed", "completed_empty") else 2


def parser():
    result = argparse.ArgumentParser(description=__doc__)
    mode = result.add_mutually_exclusive_group()
    mode.add_argument("--query")
    mode.add_argument("--post-id")
    result.add_argument("--subreddit", default="Python")
    result.add_argument("--limit", type=int, default=10)
    result.add_argument("--comments-per-post", type=int, default=50)
    result.add_argument("--more-limit", type=int, default=0)
    result.add_argument("--max-seconds", type=int, default=120)
    result.add_argument("--include-authors", action="store_true")
    result.add_argument("--output-dir", default="reddit_output")
    return result


def main():
    arg_parser = parser()
    args = arg_parser.parse_args()
    for name, low, high in [("limit", 1, 100), ("comments_per_post", 0, 500),
                            ("more_limit", 0, 10), ("max_seconds", 1, 600)]:
        if not low <= getattr(args, name) <= high:
            arg_parser.error(f"{name} must be between {low} and {high}")
    try:
        with make_client() as reddit:
            return export(reddit, args)
    except ValueError as exc:
        print(str(exc), file=sys.stderr)
    except FileExistsError:
        print("Output directory already exists. Choose a new --output-dir.", file=sys.stderr)
    except Exception as exc:
        print("Stopped: " + type(exc).__name__, file=sys.stderr)
    return 1


if __name__ == "__main__":
    raise SystemExit(main())
Три режима запуска
Откройте терминал в каталоге скрипта. Используйте настроенное окружение Python и реквизиты API. Для каждого запуска выбирайте новый каталог: скрипт отказывается записывать данные в уже существующий.
По умолчанию используется сабреддит Python. В режиме выдачи или поиска смените его через --subreddit NAME. Вместо POST_ID укажите ID доступного поста, например из проверки подключения.
Выдача постов, поиск по слову и комментарии отдельного обсуждения
python reddit_scraper_v2.py --limit 10 --comments-per-post 0 --output-dir reddit_posts_run
python reddit_scraper_v2.py --query proxy --limit 10 --more-limit 2 --output-dir reddit_search_run
python reddit_scraper_v2.py --post-id POST_ID --more-limit 2 --output-dir reddit_thread_run
Параметры и границы выгрузки
| Параметр | По умолчанию | Допустимый диапазон | Что ограничивает |
|---|---|---|---|
--limit |
10 | 1–100 | Число постов в выдаче или поиске |
--comments-per-post |
50 | 0–500 | Число экспортируемых комментариев на пост; 0 отключает их сбор |
--more-limit |
0 | 0–10 | Раскрытие узлов MoreComments на каждый пост |
--max-seconds |
120 | 1–600 | Время, проверяемое между обработкой постов |
--include-authors |
Отключён | Флаг | Запись имён доступных авторов |
--more-limit не задаёт общее число HTTP-запросов. --max-seconds не является жёстким сроком завершения: загрузка очередной страницы, обработка текущего поста или ожидание внутри библиотеки могут выйти за этот предел. Тайм-аут запроса составляет 20 секунд и тоже не ограничивает длительность всей выгрузки.
Прокси необязателен. Если ROLA_PROXY_URL не задана, экспортёр подключается напрямую. Он намеренно не использует унаследованные настройки прокси из окружения.
Проверка CSV и результата запуска
Скрипт создаёт reddit_posts.csv, reddit_comments.csv и run_metadata.json. Перед анализом проверьте статус, число строк и до пяти записей из каждого CSV; если строк меньше, проверьте все.
post_idкомментария должен соответствовать посту из таблицы публикаций.parent_idдолжен указывать на пост или родительский комментарий; последний может не попасть в обрезанную выборку.created_at_utcдолжен содержать дату ISO 8601 со смещением+00:00.permalinkдолжен вести к исходному обсуждению.scoreиnum_commentsотражают состояние на момент сбора и могут измениться позже.
Статус в run_metadata.json |
Как понимать результат |
|---|---|
completed |
Обработка выбранной выдачи завершилась; это не означает полноту архива |
completed_empty |
Выдача оказалась пустой; нужные данные могли не быть получены |
stopped_at_time_budget |
Сработала проверка времени между постами; выгрузка может быть неполной |
failed_partial |
Запуск завершился с ошибкой; сохранены только уже собранные строки |
При ошибке скрипт сохраняет частичные данные и возвращает код завершения 1. При остановке по времени — 2, при completed или completed_empty — 0. Наличие CSV-файлов само по себе не подтверждает успешный сбор.
Текстовые значения, которые после удаления начальных пробелов начинаются с =, +, - или @, скрипт предваряет апострофом. Это снижает риск выполнения формул при открытии стороннего текста в табличном редакторе. CSV записывается в utf-8-sig для корректного отображения Unicode, в том числе кириллицы, в совместимых редакторах.
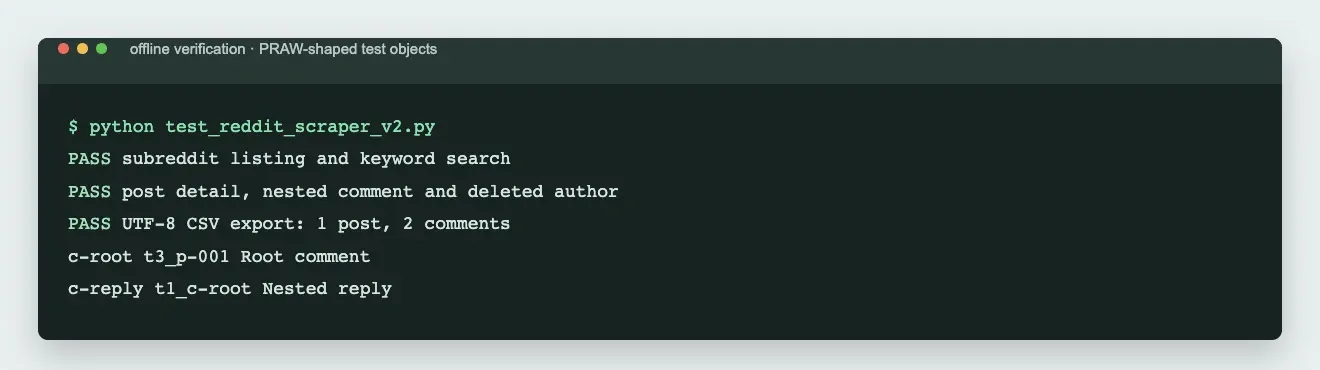
Рисунок 4. Иллюстрация проверок на тестовых объектах, без подключения к Reddit API или прокси.
Когда подходит парсинг HTML через BeautifulSoup
BeautifulSoup подходит для извлечения видимых полей из HTML, который разрешено получить. Проверяйте наличие элементов поста: успешный HTTP-ответ может содержать страницу входа или проверки доступа вместо обсуждения.
В общей команде установки BeautifulSoup уже есть. Для отдельного HTML-примера достаточно python -m pip install beautifulsoup4==4.15.0.
Пример 9. Разбор полученного HTML с проверкой наличия постов
"""Parse an already-permitted HTML response and fail on challenge/changed markup."""

from bs4 import BeautifulSoup


def parse_visible_posts(html):
    soup = BeautifulSoup(html, "html.parser")
    rows = []
    for tag in soup.select("shreddit-post"):
        title = tag.get("post-title")
        permalink = tag.get("permalink")
        if title and permalink:
            rows.append({"title": title, "permalink": permalink})
    if not rows:
        raise ValueError("No post elements; inspect page or challenge response")
    return rows
Функция принимает готовую HTML-строку; сетевого запроса в ней нет. Селектор shreddit-post и атрибуты post-title, permalink соответствуют одному варианту публичной разметки и могут измениться. Проверки должны выявлять отсутствие ожидаемой структуры, чтобы изменение страницы не давало незаметно пустую выборку.
Для регулярного сбора комментариев и связей между ответами используйте структурированные поля Data API.
Подключение прокси Rola-IP к PRAW
Прокси меняет внешний IP и сетевой маршрут, но не права приложения или квоту API. Он нужен, например, для сравнения доступных публичных страниц из разных регионов или для работы через заданный сетевой выход.
Rola-IP предлагает резидентские, статические резидентские и другие прокси. Выбирайте маршрут по региону, стабильности, стоимости трафика и правилам целевой платформы.
| Вариант | Когда подходит | Что проверить |
|---|---|---|
| Резидентские прокси с ротацией IP | Независимые короткие запросы, для которых смена IP допустима | Регион, режим смены адресов, расход трафика |
| Статические резидентские прокси | Сессии, которым нужен один внешний IP | Постоянство адреса и параметры сессии |
Описание продуктов есть на страницах резидентских прокси и прокси для веб-парсинга на английском языке. Адрес сервера, порт и параметры авторизации берите в личном кабинете.
Настройка адреса и авторизации
Экспортёр принимает URL HTTP- и HTTPS-прокси; адрес вида socks5://… он отклоняет. Схема URL должна соответствовать протоколу порта прокси, а не целевого сайта: для доступа к HTTPS-сайту адрес HTTP-прокси может начинаться с http://.
Задайте ROLA_PROXY_URL, используя адрес, порт и способ авторизации из настроек аккаунта.
- При авторизации по логину и паролю формат выглядит так:
http://USERNAME:PASSWORD@HOST:PORT. Спецсимволы в логине и пароле нужно закодировать для URL. - При авторизации по белому списку IP используйте формат
http://HOST:PORTи убедитесь, что текущий публичный IP добавлен в список. - Передавайте реальные значения через защищённое окружение или хранилище секретов; не записывайте URL с реквизитами в журнал.
Заполнитель для PowerShell:
$env:ROLA_PROXY_URL="http://USERNAME:PASSWORD@HOST:PORT"
Экспортёр из примера 8 передаёт собственную сессию Requests в PRAW и настраивает HTTP(S)-прокси через ROLA_PROXY_URL. Без этой переменной он использует прямое соединение.
Проверка внешнего IP
Сначала проверьте маршрут через сервис определения внешнего IP. В примере используется сторонний сервис ipinfo.io; его сбой сам по себе не доказывает неисправность прокси. Диагностика, как и экспортёр, отключает наследование сетевых настроек из окружения.
Запускайте пример после настройки ROLA_PROXY_URL. Он проверяет внешний IP, а не доступ к Reddit. При необходимости задайте другой JSON-сервис через IP_ECHO_URL; ответ должен содержать поле ip.
Пример 10. Проверка выходного IP через Rola-IP
import os
import requests

from ipaddress import ip_address

try:
    proxy = os.environ["ROLA_PROXY_URL"]
    if not proxy.startswith(("http://", "https://")):
        raise ValueError("ROLA_PROXY_URL must be an HTTP(S) proxy URL.")
    with requests.Session() as session:
        session.trust_env = False
        session.proxies.update(http=proxy, https=proxy)
        response = session.get(
            os.environ.get("IP_ECHO_URL", "https://ipinfo.io/json"),
            timeout=15,
        )
        response.raise_for_status()
        print(ip_address(response.json()["ip"]))
except (requests.RequestException, ValueError, KeyError) as exc:
    print("Proxy diagnostic failed:", type(exc).__name__)
    raise SystemExit(1)
Настройки портов, авторизации и белого списка описаны в документации Rola-IP по подключению из Python на английском языке.
Ошибки парсинга Reddit: что проверять сначала
Ошибки авторизации, ограничения частоты запросов и сбои прокси требуют разных действий. Сначала определите код ответа и причину: смена IP не исправляет отсутствие прав у приложения.
| Симптом | Возможная причина | Первое действие |
|---|---|---|
| HTTP 401 / 403 | Неверные реквизиты, недостаточные права или отказ в доступе | Проверьте приложение Reddit и разрешённый сценарий; не меняйте IP вслепую |
| HTTP 429 | Слишком высокая частота запросов | Остановите сбор, проверьте Retry-After и выдержите указанную паузу перед новым запуском; не обходите лимит сменой IP |
| HTML-запрос вернул HTTP 200, но элементов постов нет | Страница проверки, входа или изменившаяся разметка | Проверьте HTML и селекторы; пустая выдача API требует отдельной проверки фильтров и доступа |
| HTTP 503 или тайм-аут | Временный сбой сервиса или сетевого маршрута | Ограничьте повторные попытки, проверьте коды и время запросов без записи секретов и сырых ответов |
| HTTP 407 от прокси | Ошибка авторизации, белого списка IP или порта | Сначала проверьте прокси через сервис определения внешнего IP |
| Пустое поле автора | Имена не включены в экспорт; аккаунт также может быть удалён или недоступен | Проверьте --include-authors; оставьте пустое значение, если автор недоступен |
| Комментариев меньше ожидаемого | Ограничения выгрузки, нераскрытые MoreComments, удаление контента или ограничения доступа |
Проверьте --comments-per-post, --more-limit и доступный объём обсуждения |
Экспортёр не запускает дополнительный цикл повторных попыток вокруг неудачной задачи. PRAW и prawcore используют собственные механизмы повторов и обработки лимитов. Параметр ratelimit_seconds=0 не отключает квоты Reddit и не гарантирует отсутствие ожидания внутри библиотеки.
Если исключение дошло до скрипта, он записывает тип ошибки, а при наличии ответа — HTTP-статус и Retry-After, сохраняет частичную выгрузку и завершает работу. Не используйте такие CSV как полный набор данных. Порядок проверки Retry-After и повторного запуска описан в руководстве про ошибку 429 на Reddit.