
Reddit請求頻率限制:429錯誤排除與重試設定
2026年10月29日 · 教程 · 25 分鐘閱讀
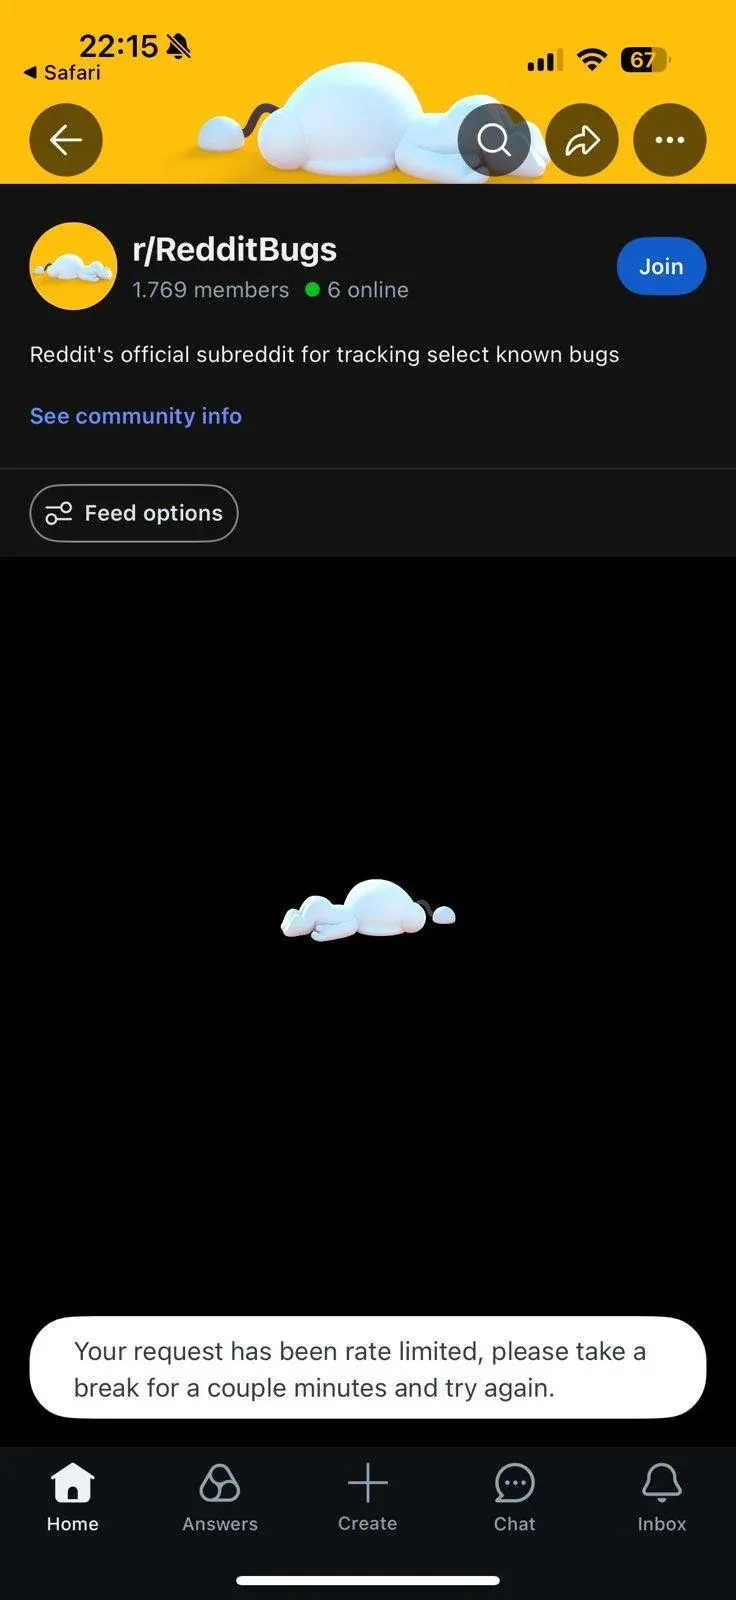
遇到Reddit請求頻率限制,先暫停操作,再確認限制來自帳號、瀏覽器工作階段、OAuth用戶端,還是來源IP。畫面顯示「rate limit exceeded」或API回傳HTTP 429,都不足以單獨判定IP遭到封鎖。
一般使用者應先停止重新整理與重複送出操作;開發者則要讀取Retry-After及配額重設標頭,讓多個背景工作共用請求額度。代理IP只能改變網路出口,無法增加OAuth配額、解除帳號冷卻時間,或取得資料蒐集授權。
Reddit 429錯誤怎麼解決?先掌握這5點
Reddit限流的處理順序是「停止請求、辨識限制、依指示等待、降低負載、驗證結果」。限制範圍不同,恢復方式也不同。
- 先停止流量。 暫停自動重新整理、重複送出與背景重試,保留錯誤訊息及發生時間。
- 看清楚限制的是什麼操作。 發文冷卻、API 429與網路安全封鎖,需要分別處理。
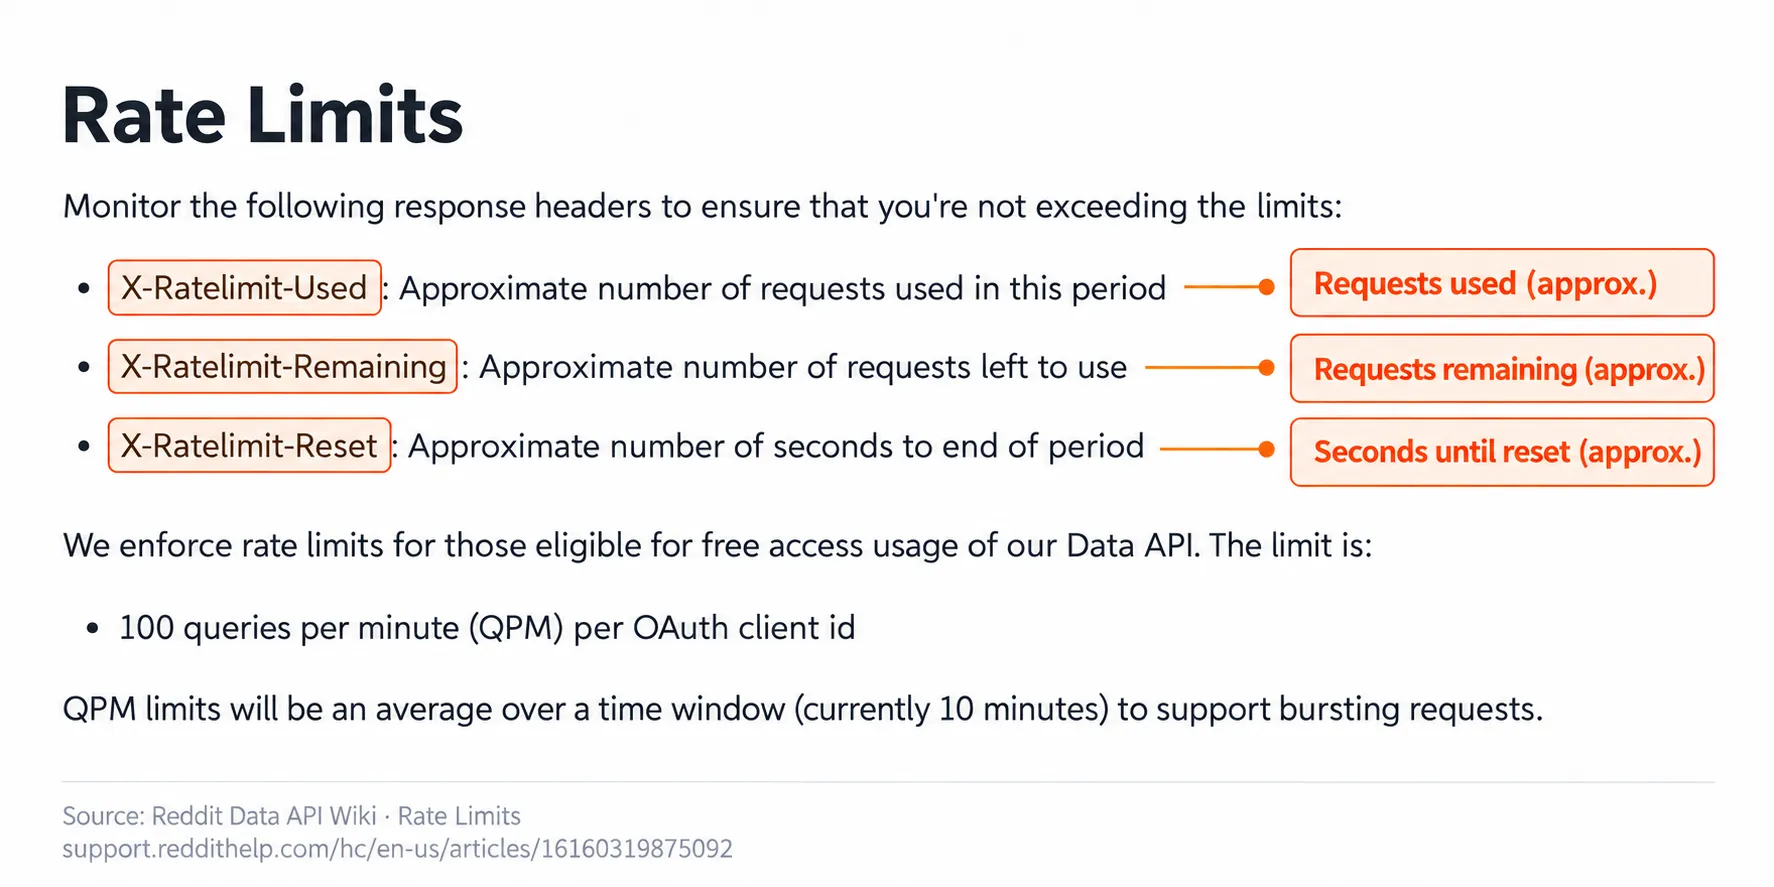
- API請求依標頭排程。 有回傳時,記錄
X-Ratelimit-Used、X-Ratelimit-Remaining與X-Ratelimit-Reset。 - 多個背景工作共用配額。 同一OAuth用戶端的背景工作,不應各自把整份額度當成自己的可用量。
- 代理IP另有用途與前提。 只有已獲授權的地區或路由測試,才需要評估代理;更換出口不會重設其他限制。
Reddit的「rate limit exceeded」是什麼意思?
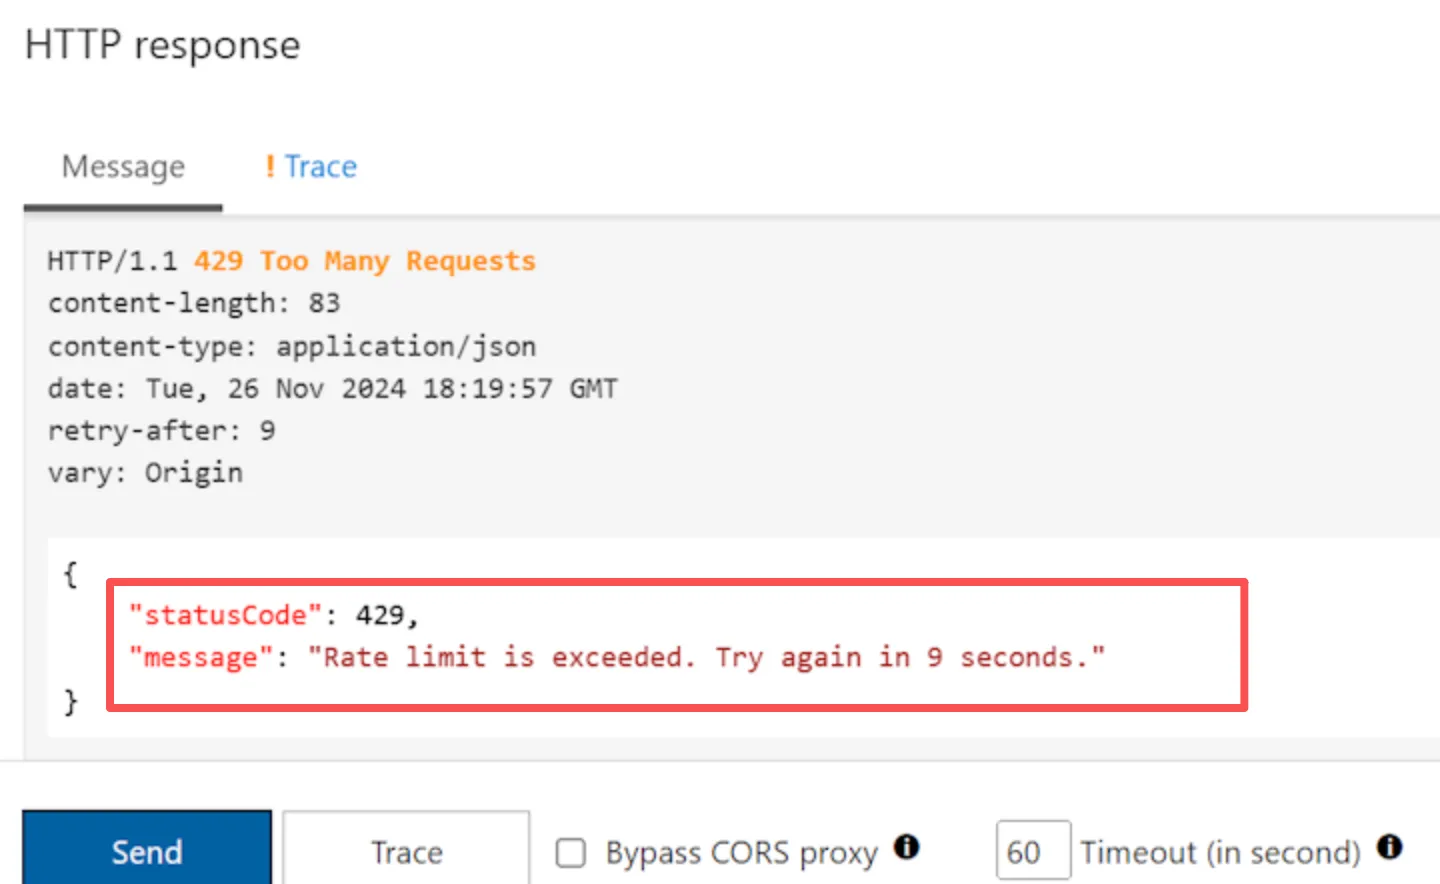
HTTP 429表示伺服器因請求頻率超過限制,而拒絕處理這次請求;它不等於帳號停權,也不一定代表IP被封鎖。回應若附上Retry-After,用戶端就能據此判斷何時再試。
RFC 6585第4節定義了429狀態碼,但沒有規定每個網站必須以什麼身分計算流量。跨服務的處理原則可參考429 Too Many Requests錯誤排除指南;Reddit則需進一步辨識下列範圍。
| 限制範圍 | 常見情境 | 應檢查的線索 | 第一步處理方式 |
|---|---|---|---|
| 帳號 | 發文、留言、傳訊息、登入 | 畫面倒數、帳號通知、操作類型 | 停止該操作,等待冷卻結束 |
| 瀏覽器或工作階段 | 頻繁重新整理、擴充功能、重複分頁 | 無痕視窗對照、背景請求 | 停止自動更新,找出發送請求的來源 |
| OAuth用戶端 | Data API應用程式 | 配額標頭、應用程式紀錄 | 暫停共用佇列,等待配額重設 |
| 來源IP | 共用網路、共用出口 | 同一路由上的不同用戶端出現相同錯誤 | 先停止流量,再進行已獲授權的路由對照測試 |
| API端點或特定操作 | 只有某條路徑受限 | 錯誤內容、端點專屬文件 | 降低該操作的頻率,依端點規則處理 |
| 同時執行量或瞬間流量 | 多個背景工作平行發送請求 | 執行中請求數、時間戳記、重試量 | 降低同時執行數,集中管理重試 |
若訊息明確指出網路安全限制,就應依存取問題排查。不要把登入驗證失敗、安全封鎖及所有載入錯誤,一律歸類為429。
為什麼Reddit會限制請求頻率?
Reddit透過請求頻率限制(rate limiting)維持服務容量,並抑制垃圾訊息、濫用自動化、重複登入嘗試與過量資料蒐集。可讀取公開頁面,不代表已取得自動化蒐集或商業使用授權。
依原稿引用的官方資料,Reddit在2024年的公開內容政策與robots.txt更新說明中,表示會持續限制或封鎖未識別的機器人與爬蟲。原稿亦引用2026年8月的基礎設施與管理工具更新公告,說明公開API存取仍有限制,新第三方應用程式的開發方向則逐步轉向Reddit開發者平台(Developer Platform)。
因此,搜尋「Reddit爬蟲限流解法」時,需要先釐清存取資格,再調整程式。原稿核對時的Reddit使用者協議,原則上禁止未取得事先書面同意的抓取;依robots.txt條件允許的檢索,或另有協議規範的存取,則須分別確認適用條件。商業用途或超出Data API額度的研究,也可能需要另行取得協議。
一般使用者如何排除Reddit請求頻率限制?
在瀏覽器或App遇到限流,先停止重複操作,再依畫面指定時間等待。清除Cookie或開啟無痕視窗可以協助診斷工作階段問題,但不能重設帳號、API或IP的限制。
- 停止重新整理與重複送出。 關閉重複的Reddit分頁,暫停會在背景重新載入頁面的擴充功能、指令碼或其他工具。
- 記錄完整錯誤情境。 留下提示文字、倒數時間、狀態碼、受影響操作及發生時間。截圖不要包含Cookie或存取權杖。
- 等待畫面指定的時間。 倒數結束後只做一次測試。連續點選確認是否恢復,可能再次觸發相同限制。
- 比較App與瀏覽器。 若一般操作仍失敗,可在不執行自動化工具的情況下,比較官方App與受支援的瀏覽器。無痕視窗有助於隔離工作階段問題,不能用來解除帳號或IP限制。
- 排除服務端異常。 若多個互不相關的裝置與網路同時失敗,先查看Reddit服務狀態,再決定是否調整本機設定。
- 依錯誤類型使用官方管道。 安全鎖定、密碼問題、版務處置與申訴通知,都應走各自的處理流程。
清除Cookie會讓帳號登出,也可能修復損壞的瀏覽器工作階段;它不會清除OAuth額度、發文冷卻、端點限制或來源IP的計數。
開發者如何處理Reddit API 429?
Reddit API回傳429時,應先暫停新工作、保存去識別化的診斷紀錄,再讓所有背景工作依同一份配額排程。只替單一請求加上等待時間,無法解決多個工作同時耗盡額度的問題。
調整程式前,先記錄下列資訊:
- UTC時間戳記。
- HTTP方法與端點路徑,移除敏感查詢參數。
- HTTP狀態碼、Reddit錯誤代碼或不含敏感資訊的回應摘要。
Retry-After與可取得的配額標頭。- 代表OAuth用戶端的內部代稱,不使用機密憑證。
- 背景工作數、執行中請求數、嘗試次數及已耗時間。
- 快取是否命中。
- 已遮蔽敏感資訊的請求識別碼或追蹤識別碼。
紀錄中不得包含OAuth權杖、用戶端密鑰、Cookie、代理密碼、完整Authorization標頭,或帶有帳密的網址。
1. 讓單一元件負責重試
HTTP函式庫、背景工作、排程工具與應用程式,都可能各自設定重試。若4個層級同時重送同一個429請求,原本一次失敗就會放大成一波流量。
指定一個層級統一管理重試次數與等待時間,其餘層級則關閉重試,或縮小可重試的錯誤範圍。
2. 將OAuth配額設為共用狀態
把X-Ratelimit-Remaining與X-Ratelimit-Reset交給共用排程器,避免每個背景工作都假設自己擁有完整額度。剩餘額度接近零時,停止加入非必要工作;若已核准的用途需要互動式或時效性操作,可事先保留所需容量。
3. 快取並合併重複讀取
在Reddit規範與資料義務允許的前提下,為可重用回應設定適當的快取期限。相同資源可採用請求合併(single-flight):10個工作同時需要同一筆資料時,只發出1次對外請求,再共用結果。
快取仍須配合資料刪除、內容移除、隱私及核准用途的要求,不能為了減少API用量而無限期保留資料。
4. 優先降低同時執行數
平均每分鐘請求量沒有超標,也可能因瞬間流量或同時連線過多而受限。從1個背景工作開始觀察回應標頭,再逐步調整。
例如,50個背景工作各自加入隨機延遲,仍可能同時送出50個請求。應先限制整體執行量,再安排間隔。
5. Reddit API請求次數限制是多少?
Reddit Data API官方說明,符合免費存取資格的應用程式,每個OAuth用戶端ID為每分鐘100次查詢,以10分鐘區間計算平均值;文件亦指出,不接受未使用OAuth或登入憑證的流量。
正式設定容量前,須確認最新文件、存取資格、平台要求與個別協議;不要把平均值當成可任意集中發送的瞬間流量額度。
Reddit API 429重試設定:Python範例
這份Python範例適用於已獲核准的OAuth讀取作業:限制嘗試次數、檢查等待標頭,並在回報成功前驗證JSON。範例只處理單一作業;多個背景工作仍需另外共用排程與配額狀態。
執行前需備妥requests套件,並設定以下環境變數。機密值應透過部署環境的安全機制注入,不要寫入程式碼、文章範例或版本庫。
| 環境變數 | 用途 | 設定原則 |
|---|---|---|
REDDIT_OAUTH_TOKEN |
OAuth存取權杖 | 使用該應用程式獲准的有效權杖 |
REDDIT_USER_AGENT |
應用程式識別資訊 | 準確描述實際用戶端,不冒充其他程式 |
AUTHORIZED_REDDIT_PATH_PREFIX |
允許的端點路徑前綴 | 設為核准用途所需的最小範圍 |
AUTHORIZED_REDDIT_URL |
此次請求網址 | 必須使用https://oauth.reddit.com及允許的路徑 |
REQUIRED_JSON_FIELDS |
成功回應必須包含的頂層欄位 | 以逗號分隔,依端點實際結構設定,不可留白 |
先確認端點、OAuth權限範圍及存取條款,再使用範例。程式會在附加Bearer權杖前驗證網址,拒絕重新導向,也不會輸出憑證。
from datetime import datetime, timezone
from email.utils import parsedate_to_datetime
import math
import os
import random
import time
from typing import Optional
from urllib.parse import urlparse

import requests


OAUTH_TOKEN = os.environ["REDDIT_OAUTH_TOKEN"]
USER_AGENT = os.environ["REDDIT_USER_AGENT"]
AUTHORIZED_PATH_PREFIX = os.environ["AUTHORIZED_REDDIT_PATH_PREFIX"].rstrip("/") or "/"
REQUIRED_JSON_FIELDS = tuple(
    field.strip()
    for field in os.environ["REQUIRED_JSON_FIELDS"].split(",")
    if field.strip()
)

MAX_ATTEMPTS = 3
MAX_INLINE_WAIT_SECONDS = 300
TOTAL_ELAPSED_BUDGET_SECONDS = 360
ALLOWED_REDDIT_HOST = "oauth.reddit.com"


def validate_authorized_url(value: str) -> str:
    parsed = urlparse(value)
    prefix_matches = (
        parsed.path.startswith("/")
        if AUTHORIZED_PATH_PREFIX == "/"
        else parsed.path == AUTHORIZED_PATH_PREFIX
        or parsed.path.startswith(f"{AUTHORIZED_PATH_PREFIX}/")
    )
    if (
        parsed.scheme != "https"
        or parsed.hostname != ALLOWED_REDDIT_HOST
        or parsed.port not in (None, 443)
        or parsed.username is not None
        or parsed.password is not None
        or parsed.fragment
        or not prefix_matches
    ):
        raise ValueError("Refusing a Reddit URL outside the approved HTTPS host and path")
    return value


if not REQUIRED_JSON_FIELDS:
    raise ValueError("REQUIRED_JSON_FIELDS must name the endpoint's required fields")

AUTHORIZED_URL = validate_authorized_url(os.environ["AUTHORIZED_REDDIT_URL"])


def parse_retry_after(value: Optional[str]) -> Optional[int]:
    if value is None:
        return None
    text = value.strip()
    if text.isdigit():
        return int(text)
    try:
        retry_at = parsedate_to_datetime(text)
    except (TypeError, ValueError, OverflowError):
        return None
    if retry_at.tzinfo is None:
        return None
    seconds = (retry_at - datetime.now(timezone.utc)).total_seconds()
    return max(0, math.ceil(seconds))


def parse_reset_seconds(value: Optional[str]) -> Optional[int]:
    if value is None:
        return None
    try:
        seconds = float(value.strip())
    except (TypeError, ValueError):
        return None
    if not math.isfinite(seconds) or seconds < 0:
        return None
    return math.ceil(seconds)


def parse_wait_seconds(response: requests.Response) -> int:
    candidates = [
        parse_retry_after(response.headers.get("Retry-After")),
        parse_reset_seconds(response.headers.get("X-Ratelimit-Reset")),
    ]
    valid = [value for value in candidates if value is not None]
    if not valid:
        raise RuntimeError("429 had no valid Retry-After or reset value; defer the job")
    return max(1, max(valid))


def validate_success_payload(response: requests.Response) -> dict:
    media_type = response.headers.get("Content-Type", "").split(";", 1)[0].lower()
    if media_type != "application/json" and not media_type.endswith("+json"):
        raise RuntimeError(f"Unexpected success content type: {media_type or 'missing'}")
    try:
        payload = response.json()
    except ValueError as exc:
        raise RuntimeError("Success response did not contain valid JSON") from exc
    if not isinstance(payload, dict):
        raise RuntimeError("Success JSON did not match the expected object shape")
    missing = [field for field in REQUIRED_JSON_FIELDS if field not in payload]
    if missing:
        raise RuntimeError(f"Success JSON is missing required fields: {', '.join(missing)}")
    return payload


session = requests.Session()
session.headers.update(
    {
        "Authorization": f"Bearer {OAUTH_TOKEN}",
        "User-Agent": USER_AGENT,
        "Accept": "application/json",
    }
)

started_at = time.monotonic()

for attempt in range(1, MAX_ATTEMPTS + 1):
    elapsed = time.monotonic() - started_at
    if elapsed >= TOTAL_ELAPSED_BUDGET_SECONDS:
        raise RuntimeError("Elapsed-time budget exhausted before the next request")

    try:
        response = session.get(
            AUTHORIZED_URL,
            timeout=(5, 20),
            allow_redirects=False,
        )
    except requests.Timeout as exc:
        raise RuntimeError("Reddit request timed out; no retry was scheduled") from exc
    except requests.RequestException as exc:
        raise RuntimeError("Reddit request failed before a valid response arrived") from exc

    if 300 <= response.status_code < 400:
        raise RuntimeError("Redirect refused so the Bearer token stays on the approved host")

    if response.status_code == 429:
        wait_seconds = parse_wait_seconds(response)
        if attempt == MAX_ATTEMPTS:
            raise RuntimeError("Reddit rate limit persisted after bounded attempts")
        if wait_seconds > MAX_INLINE_WAIT_SECONDS:
            raise RuntimeError(
                f"Defer this job for at least {wait_seconds} seconds instead of sleeping inline"
            )

        sleep_seconds = wait_seconds + random.uniform(0.25, 1.0)
        if time.monotonic() - started_at + sleep_seconds > TOTAL_ELAPSED_BUDGET_SECONDS:
            raise RuntimeError("Defer the job because the next wait exceeds its elapsed-time budget")
        time.sleep(sleep_seconds)
        continue

    if not 200 <= response.status_code < 300:
        try:
            response.raise_for_status()
        except requests.HTTPError as exc:
            raise RuntimeError(f"Reddit returned HTTP {response.status_code}") from exc
        raise RuntimeError(f"Unexpected non-success HTTP status: {response.status_code}")

    validate_success_payload(response)
    print(
        "Validated Reddit JSON response",
        response.status_code,
        "required_fields=",
        ",".join(REQUIRED_JSON_FIELDS),
    )
    break
else:
    raise RuntimeError("Request loop ended without a response")
等待時間、重試次數與成功條件
範例保留原稿的參數:
| 設定 | 數值 | 實際作用與限制 |
|---|---|---|
MAX_ATTEMPTS |
3 | 最多嘗試3次,包含第一次請求 |
MAX_INLINE_WAIT_SECONDS |
300秒 | 標頭要求等待更久時,中止本次執行,交由外部排程器延後處理 |
TOTAL_ELAPSED_BUDGET_SECONDS |
360秒 | 在下次請求及等待前檢查已耗時間,不是強制中斷執行中請求的截止時間 |
timeout=(5, 20) |
連線5秒、讀取20秒 | 控制單次請求的連線與讀取等待,不代表整份作業必定在25秒內完成 |
| 額外隨機等待 | 0.25至1秒 | 加在伺服器要求的等待時間之後,避免重試時間過度集中 |
Retry-After可以是整數秒數或HTTP日期;X-Ratelimit-Reset可以是小數秒數。兩個值都有效時,程式採用較長的等待時間。兩個值都無效時,程式停止作業,不自行猜測延遲。
連線失敗、逾時、重新導向或非成功狀態,都不會被當成一般429重試。即使取得2xx回應,也必須通過內容類型、JSON物件格式與指定頂層欄位檢查,才會回報成功。這些檢查不等於完整的端點資料驗證;正式流程還需要確認欄位值、分頁狀態與資料筆數。
這份範例不會切換用戶端ID、建立新帳號、偽裝瀏覽器識別資訊,或藉由更換路由規避配額。哪些HTTP方法適合重送,以及重試應由哪一層負責,可參考Python Requests重試設定指南。
本機測試紀錄能證明什麼?
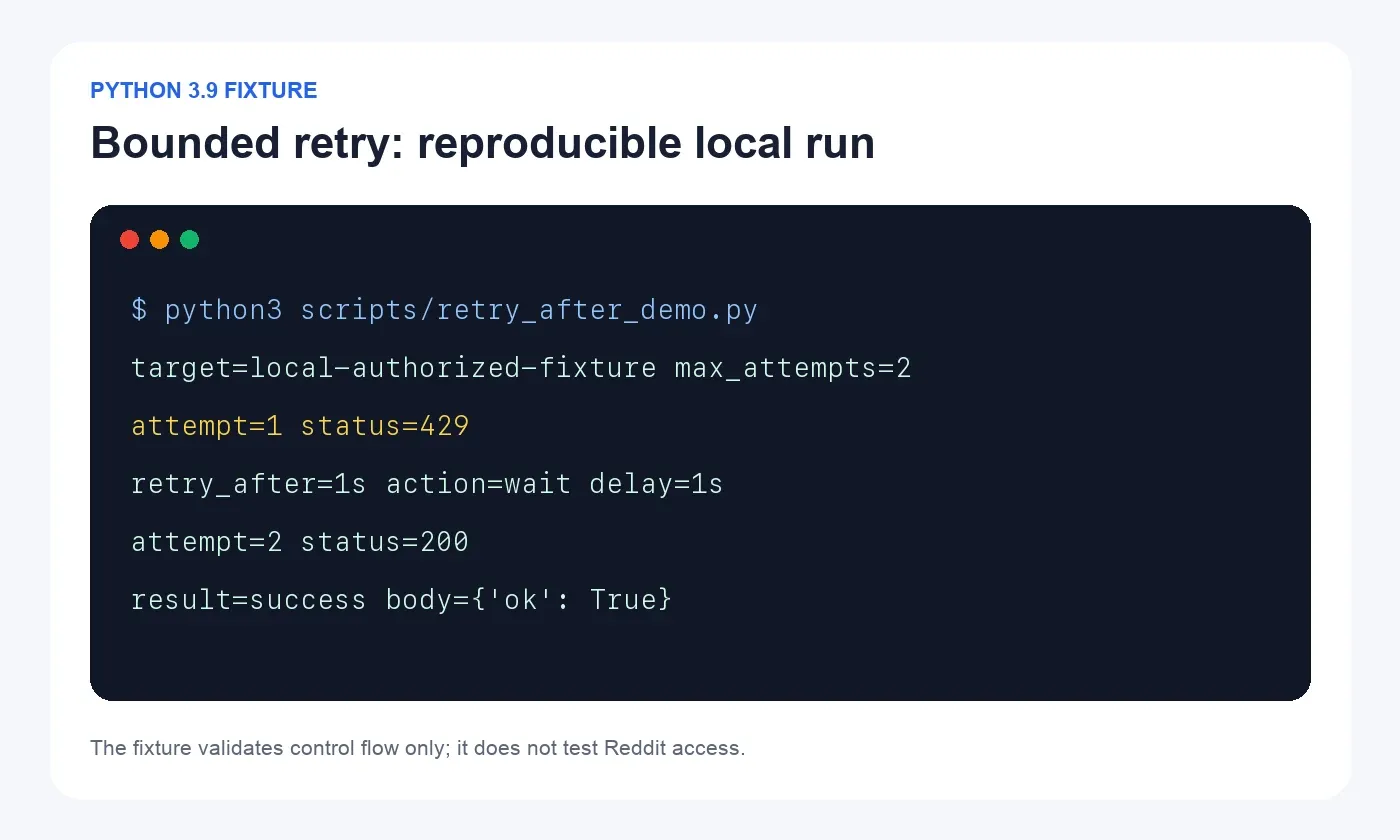
原稿附有本機固定回應測試的紀錄:第一次回傳429與Retry-After: 1,第二次回傳200。這項紀錄只用來說明等待與嘗試次數的控制流程,不能證明即時Reddit API連線、憑證有效性或實際配額。
Reddit代理IP輪換能解除限流嗎?
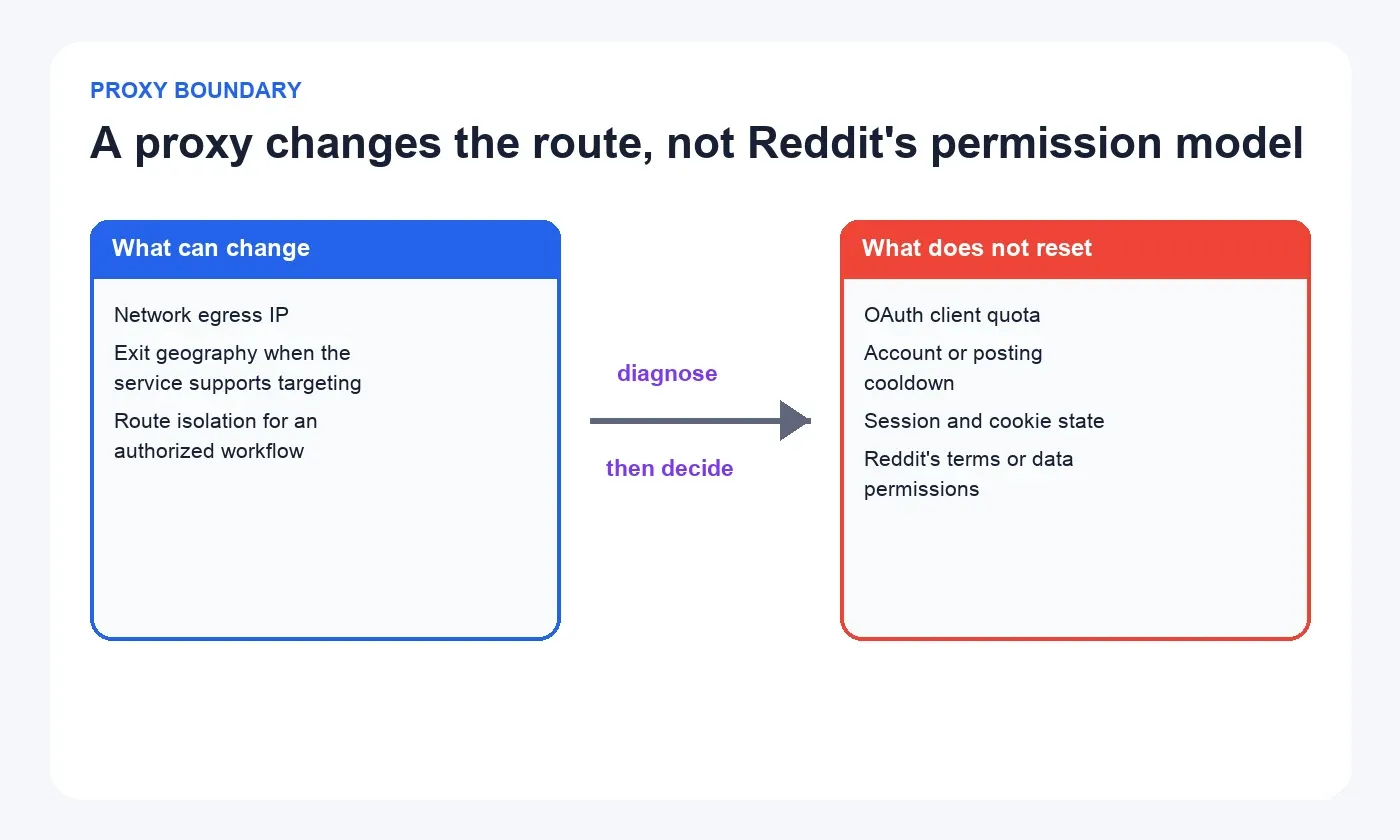
代理IP輪換不能增加OAuth用戶端配額、清除帳號冷卻時間,或取得資料蒐集權限。 代理改變的是網路出口;只有已確認與來源IP有關、且允許進行路由測試的問題,才需要評估不同出口的影響。
如果配額綁定OAuth用戶端ID,換IP後仍是同一份配額。若限制針對登入或發文,頻繁切換出口還可能讓活動模式更不一致,並違反平台規則。
原稿引用的Reddit Data API條款標示修訂日期為2026年7月20日,內容包含不得規避API限制,以及不得不實陳述或掩飾User-Agent與OAuth身分的要求。不要藉由輪換帳號、用戶端ID、User-Agent或代理出口來繞過配額。
哪些情境適合使用代理?
專案已有授權,且另有地區廣告檢查、核准市場的公開頁面體驗比較,或測試路由隔離等需求時,可以評估代理。測試仍須遵守Reddit允許的請求量與身分要求:
- 維持整體請求頻率限制,不因新增出口而增加額度。
- 使用正確的OAuth身分與可辨識的User-Agent。
- 流程依賴Cookie時,維持工作階段與出口的一致性。
- 記錄國家、路由代稱、工作階段模式與測試結果。
- 遇到401、403、429、登入牆或授權不明時,停止測試並重新確認。
Python、Scrapy與Selenium如何選擇工作階段?
選擇固定出口或輪換出口,應取決於流程是否需要保留狀態。登入、Cookie與多步驟操作通常需要固定出口;互相獨立且已獲授權的地區測試,才適合在作業之間切換路由。
| 工具或請求來源 | 適合的工作階段設定 | 應保留的驗證資訊 |
|---|---|---|
| Python Requests | 單一、有嘗試次數限制的驗證作業使用固定路由;僅在獨立且獲授權的地區測試之間切換 | 固定OAuth用戶端、端點、同時執行數與排程,比較直接連線及代理連線;檢查狀態碼、JSON欄位與出口國家 |
| Scrapy | 集中管理節流、同時執行數與重試;獨立市場批次才使用分別命名的工作階段 | 重複資料比例、資料筆數、必要欄位、401/403/429及批次路由代稱 |
| Selenium | 登入、Cookie、重新導向及多步驟操作使用固定工作階段,不在流程內逐次更換IP | 目標國家、開始與結束時的出口、工作階段模式、最終網址及預期頁面元素;不儲存Cookie或代理憑證 |
如何評估Rola IP的路由設定?
有授權的專案可從Rola IP的Reddit代理方案與代理網路設定文件確認適用方案。原稿列出的網路類型包含輪換住宅代理、輪換資料中心代理及行動網路,並提及sessionid、sessiontime與逐次請求輪換控制;實際支援範圍與設定方式,應以部署時的官方文件為準。
對需要住宅網路出口或地區比較的授權測試,可評估住宅代理。流程若依賴Cookie、登入狀態、分頁或可重現的瀏覽器操作,應優先維持固定出口;只有彼此獨立、無須延續狀態的測試,才考慮在作業或國家之間切換。Selenium流程中逐次更換IP,可能造成Cookie工作階段未變、出口卻持續改變的情況。
擴大規模前,先做單一變因對照:
- 固定Reddit身分、請求頻率、請求內容、用戶端版本與可比較的測試時段。
- 只變更已獲授權的路由,先透過不含機密資訊的IP查詢端點確認出口與國家。
- 比較Reddit回應的必要欄位,或瀏覽器中預期出現的頁面元素。
- 記錄路由代稱與工作階段模式,不記錄代理密碼。
- 若直接連線與代理連線都出現相同的OAuth 429,現有證據就不支持「更換IP能解決」的判斷。
Reddit爬蟲遇到限流,如何調整資料流程?
可持續的處理方式是減少重複需求,並使用Reddit核准的存取方式。業務需求超過現有額度時,應申請適用的存取資格,而不是增加重試或切換身分。
選擇介面前,可先參考網頁爬蟲與API比較指南。實作順序如下:
- 確認資料使用範圍。 核對用途、欄位、保存期限與存取方式是否獲准。
- 使用適用的官方介面。 依核准條件採用OAuth或開發者平台功能,準確識別應用程式。
- 統一對外請求入口。 所有請求通過同一套佇列管理機制,設定明確的同時執行上限。
- 共用配額狀態。 追蹤剩餘額度與重設時間,避免各背景工作分別計算。
- 快取並合併重複工作。 只快取允許保存的資料,相同讀取不重複送出。
- 採用增量蒐集。 在介面與授權允許的範圍內,取得新增或更新內容,避免反覆下載全部歷史資料。
- 設定停止條件。 權限、驗證或回應完整性不明時停止,不持續嘗試。
- 按需求申請容量。 商業或較大量的用途,依Reddit適用規範取得核准。
Reddit亦提供API更新背景說明;該說明適合了解政策背景,實際存取仍應依最新條款、開發文件及個別協議判斷。
驗證時不能只看200 OK。成功狀態仍可能附帶登入頁、同意畫面、錯誤頁框架或不完整資料。作業回報成功前,要確認最終網址、內容類型、必要欄位、分頁狀態與資料筆數。
下次排程前,如何避免再次觸發Reddit限流?
預防Reddit請求頻率限制,重點是讓排程、重試與資料驗證使用一致規則。重新啟動前,確認所有請求來源都已納入管理,避免主程式暫停了,其他工作仍持續消耗配額。
- [ ] 只有一個元件負責重試。
- [ ] 嘗試次數與已耗時間檢查均有上限,並了解逾時設定的實際邊界。
- [ ] 所有背景工作共用配額與重設狀態。
- [ ] 重複讀取已合併,快取期限符合資料義務。
- [ ] 紀錄不包含權杖、Cookie、用戶端密鑰或代理密碼。
- [ ] 401、403、429、重新導向與非預期200頁面分別處理。
- [ ] 已重新確認Reddit條款、開發文件及應用程式資格。
- [ ] 資料保存與刪除流程符合核准用途。
- [ ] 代理路由對應已記錄的地區或網路需求,未被用來規避配額。
恢復作業時,先以低負載確認回應與資料正確,再依實際配額調整排程。若另有授權的地區或網路測試需求,再評估Rola IP的路由與工作階段設定;代理能力與Reddit存取權限仍須分別確認。
結論
處理Reddit請求頻率限制,應先找出觸發限制的範圍,再依照畫面倒數或API回應標頭等待。開發者可透過共用配額排程、降低同時執行數、快取允許保存的資料,以及設定有上限的重試,減少429再次發生。恢復前也要確認回應內容完整,並重新核對目前適用的存取規範。
代理IP只改變網路出口,不能增加OAuth配額、解除帳號冷卻或授予資料存取權。若專案另有獲准的地區或網路測試需求,可依流程狀態評估固定或輪換路由;超出Reddit允許的存取容量時,應申請核准的存取方式,而非切換身分或出口規避限制。