
Как собирать данные из Facebook: парсинг страниц через Apify
16 окт. 2026 г. · Руководства · 12 мин. чтения
Собирать данные из Facebook для исследований, отчетов и мониторинга можно с помощью инструментов парсинга. В этом руководстве разбираем сбор сведений со страниц компаний и организаций через Apify: URL, названий, категорий и других доступных данных. Затем проверяем выгрузку перед использованием в работе.
Основной инструмент — Actor apify/facebook-pages-scraper на платформе Apify. Actor — это готовая программа для сбора и обработки данных. Ниже показано, как выбрать входные URL, задать ограничения, проверить записи и выгрузить нужные поля. Отдельный раздел посвящен Rola IP: когда внешний прокси применим и как проверить соединение независимо от результатов парсинга.
Кратко: как организовать сбор данных
Выбирайте парсер страниц Facebook по входным параметрам и полям результата. Начните с нескольких URL, для которых разрешен сбор, и проверьте всю цепочку — от ввода адресов до чтения выгруженного файла.
- Разделите ограничения. Лимит оплачиваемых результатов и максимальное время выполнения задаются отдельно.
- Проверьте записи. Каждая запись должна соответствовать нужной странице и содержать поля ожидаемого типа.
- Объясните пропуски. Недоступное значение сохраняйте как
null, а не как ноль; по возможности указывайте причину. - Уточните поддержку прокси. Rola IP можно подключить, если инструмент поддерживает внешний прокси и задаче нужен управляемый выходной IP.
- Проверьте сам файл. Превью набора данных не заменяет разбор скачанного JSON или CSV.
- Остановитесь при ограничении доступа. Регулярный сбор настраивайте после успешной проверки пробного запуска.
Какие данные можно собрать со страниц Facebook
Парсер сведений о страницах собирает информацию о компании или организации: URL, название, категорию, описание, сайт и другие доступные реквизиты. Сначала определите, какие поля нужны в отчете: они станут критериями проверки результата.
Прежде чем сравнивать прокси и форматы выгрузки, изучите образец записи и описание полей. Например, для каталога компаний важно правильно определить страницу организации и получить нужные сведения о бизнесе.
Не все страницы показывают одинаковые данные. Состав полей может зависеть от языка интерфейса, условий просмотра и конкретного представления страницы.
При обработке результатов соблюдайте три правила:
- Недоступные значения сохраняйте как
null. Если причина известна, записывайте ее отдельно. - Отсутствующее число подписчиков не заменяйте на
0: это разные состояния данных. - До преобразования сокращенных счетчиков сохраняйте исходный текст. Это поможет проверить, как получилось числовое значение.
Как выбрать способ сбора данных Facebook
Способ сбора зависит от доступных разрешений и того, сколько ресурсов можно выделить на поддержку решения. Далее используется готовый Actor для сведений о страницах; у Meta Pages API и собственного браузерного скрипта другие требования к настройке.
| Способ | Для каких задач подходит | Что проверять в результате | Управление внешним прокси |
|---|---|---|---|
| Meta Pages API | Проекты, которые соответствуют текущим условиям доступа для приложения и страницы | Поля, доступные запросу с нужными разрешениями | Необходимость оценивается отдельно; прокси часто не требуется |
| Готовый Actor для сведений о страницах | Сбор информации о страницах в разрешенных пределах | Записи о страницах и поля выгрузки | Поддержку нужно проверить у конкретного Actor до покупки прокси |
| Собственный браузерный скрипт | Задачи, где нужен контроль браузера и сетевого подключения | Поля, извлечение которых реализовано в приложении | Настраивается в поддерживающем прокси клиенте |
Если выбираете API, начните с официальной документации Meta Pages API. До разработки уточните версию API, связь приложения со страницей, токен, разрешения, доступные поля и порядок пагинации.
Также изучите разъяснения Meta о разрешенном и неразрешенном автоматизированном сборе и применимые условия автоматизированного сбора данных. Публичный доступ к странице сам по себе не дает права автоматически собирать или повторно публиковать ее содержимое. Заранее определите разрешенный объем работы; закрытые профили и контент с ограниченным доступом не включайте в задание.
Как выбрать прокси для парсинга Facebook
Прокси выбирают по требованиям к выходному IP: нужно ли менять его между заданиями или сохранять на протяжении работы. Сначала убедитесь, что инструмент принимает внешний прокси, затем проверьте параметры сессии и условия тарифа.
Резидентные прокси с ротацией для независимых заданий
Для отдельных браузерных заданий можно рассмотреть резидентные прокси с ротацией. Длительность сессии у провайдера должна соответствовать времени выполнения задания.
На странице продукта, проверенной 15 октября 2026 года, описаны выбор страны и закрепление IP на время сессии — sticky session. Перед настройкой уточните доступные параметры и срок сессии для выбранного пакета.
Запрос страницы и последующие запросы в рамках одного браузерного задания должны использовать один выходной IP. Создание браузерного контекста Playwright само по себе не закрепляет адрес. За это отвечают параметры сессии на стороне провайдера и срок их действия. Проверяйте адрес в контрольных точках задания, например в начале и в конце.
Ротация между заданиями не отменяет ограничения целевого сайта. Различия режимов разобраны в статье о закрепленных сессиях и ротации прокси (на английском).
Статические резидентные прокси для постоянного адреса
Если для повторных разрешенных запусков нужен один сетевой адрес, изучите статические резидентные прокси и условия конкретного тарифа. Постоянный адрес упрощает диагностику соединения и поддержание сессии.
Перед расчетом бюджета проверьте:
- срок выделения IP;
- доступные страны и регионы;
- способ аутентификации;
- условия по пропускной способности и трафику;
- ограничения на количество соединений.
За что отвечает Rola IP
Rola IP предоставляет прокси-подключение для совместимого инструмента сбора. Само приложение отвечает за запрос разрешенных данных, извлечение полей, остановку по заданным лимитам, проверку и сохранение записей.
Прокси для парсинга относятся к сетевой части этой схемы. Покупка подписки не означает, что готовый Actor умеет принимать учетные данные стороннего прокси.
Во время пробного запуска измеряйте расходы на трафик в расчете на одну проверенную запись, стабильность подключения и сохранение выходного IP. Частоту сбора выбирайте с учетом разрешенных условий работы и ответов сайта.
Как собирать данные из Facebook через Apify: сведения о страницах
Сначала пройдите весь процесс на небольшом списке разрешенных URL: от настройки до выгрузки. Сохраните версию сборки Actor, параметры запуска и исходные записи вместе, чтобы можно было установить причину ошибки.
Шаг 1. Проверьте Actor и список страниц
Откройте apify/facebook-pages-scraper и сверьте актуальное описание со схемой данных. Запишите идентификатор Actor и версию сборки, выбранную для пробного запуска. Эти сведения понадобятся при сравнении результатов и разборе изменений полей.
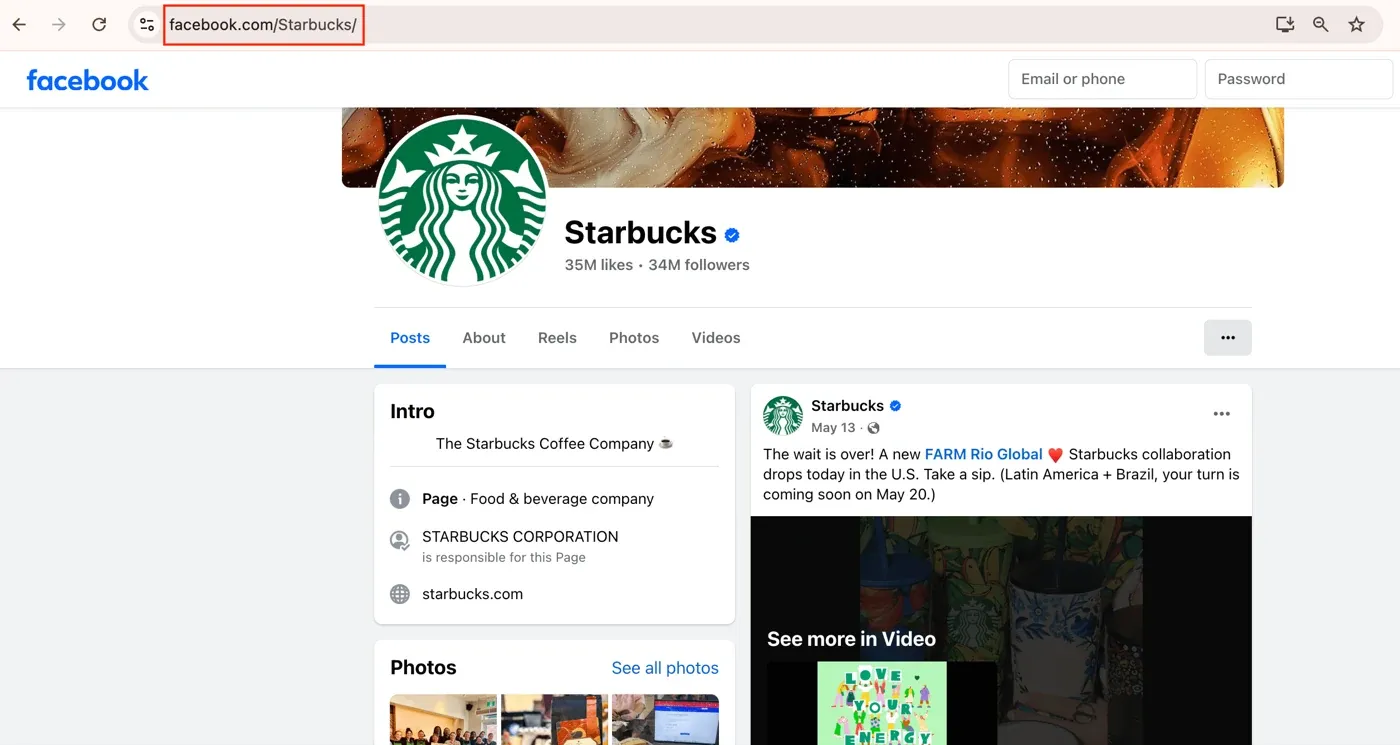
В опубликованном примере использованы три адреса:
https://www.facebook.com/Starbucks/https://www.facebook.com/TheCocaColaCo/https://www.facebook.com/McDonalds
Для своего запуска замените их адресами страниц, для которых разрешен сбор. Удалите параметры отслеживания и дубликаты.
Шаг 2. Проверьте входные параметры и поддержку прокси
Добавьте разрешенные URL в поле адресов страниц. В прежнем интерфейсе оно называлось Start urls. Убедитесь, что инструмент возвращает сведения именно о страницах, и проверьте дополнительные обязательные параметры текущей сборки.
В схеме входных данных Actor, проверенной 15 октября 2026 года, startUrls — обязательный массив объектов с URL. Инструмент предназначен для страниц Facebook, а не личных профилей. Каждый элемент массива содержит адрес страницы: перед запуском проверьте тип URL и удалите повторы.
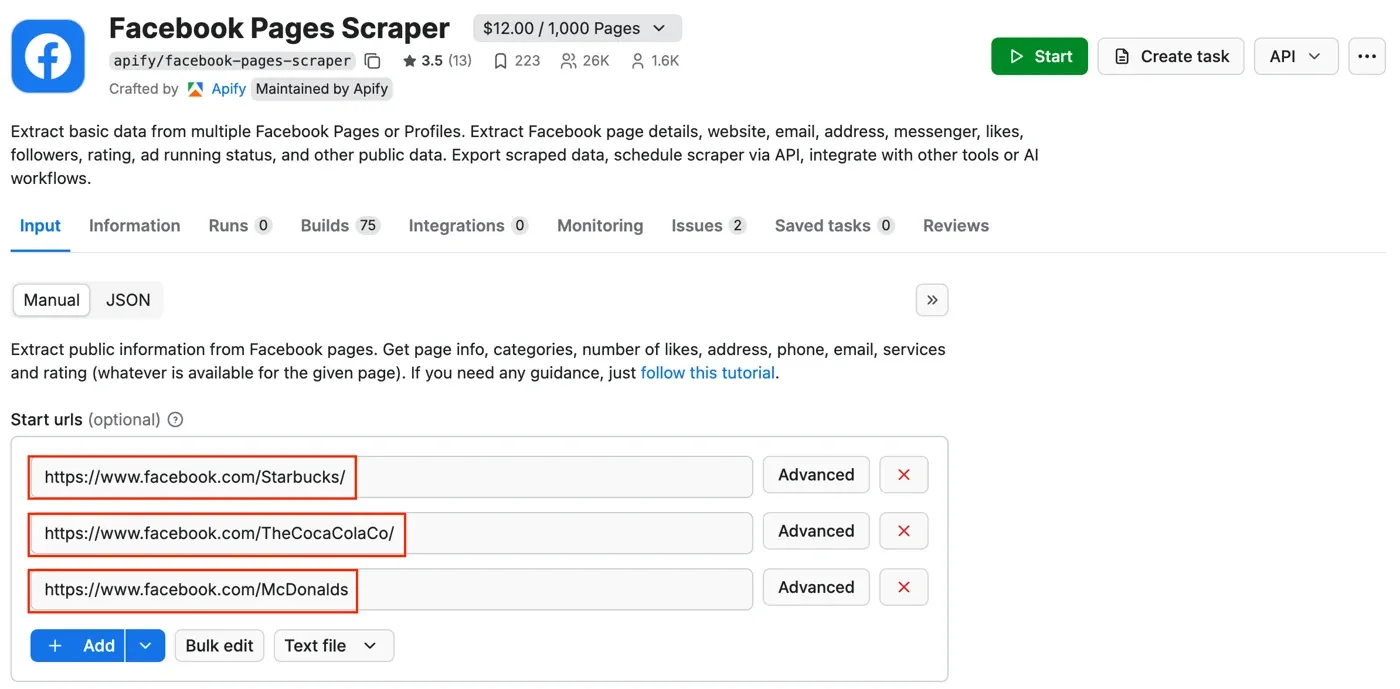
Учетные данные Rola IP вводите только при явной поддержке пользовательского прокси в выбранном Actor. Сетевое подключение может управляться внутри инструмента.
Если настройки внешнего прокси нет, выбирайте совместимый способ интеграции. Отдельная покупка прокси не меняет маршрут запросов этого Actor.
Шаг 3. Задайте отдельные лимиты оплаты и времени
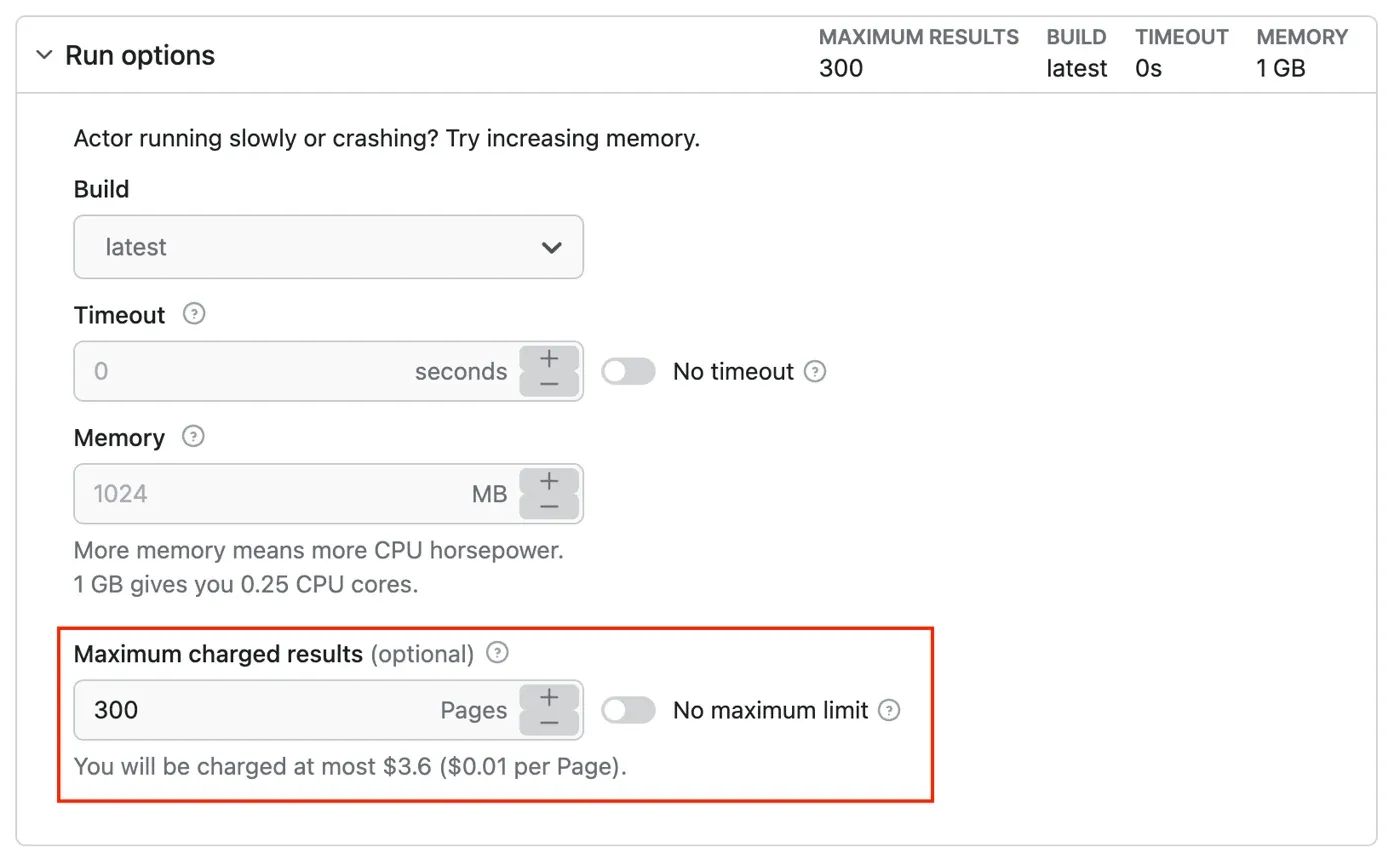
Параметр Maximum charged results на рисунке 3 ограничивает оплачиваемые результаты. Он не устанавливает отдельный предел длительности задания, числа прокруток или сетевых запросов.
На старом скриншоте также указан нулевой тайм-аут. Не копируйте это значение как настройку ограниченного времени выполнения.
Для пробного запуска:
- Оставьте небольшой список разрешенных URL.
- Установите конечный тайм-аут через актуальные настройки инструмента.
- Определите, что должно произойти при истечении времени.
- Если используете собственный браузерный скрипт, ограничьте также время переходов, прокрутку и число повторных попыток.
- Сохраните значения лимитов вместе с идентификатором запуска.
При запросе входа в аккаунт, появлении контрольной проверки или ограничении доступа остановите сбор и пересмотрите способ получения данных и разрешения.
Шаг 4. Запустите Actor и проверьте записи
Запустите Actor и сохраните идентификатор запуска и сборку. После завершения проверьте набор данных: для каждого входного URL должен быть зафиксирован результат — запись проверена, данные недоступны или произошла ошибка. Не исключайте неудачные страницы без объяснения причины.
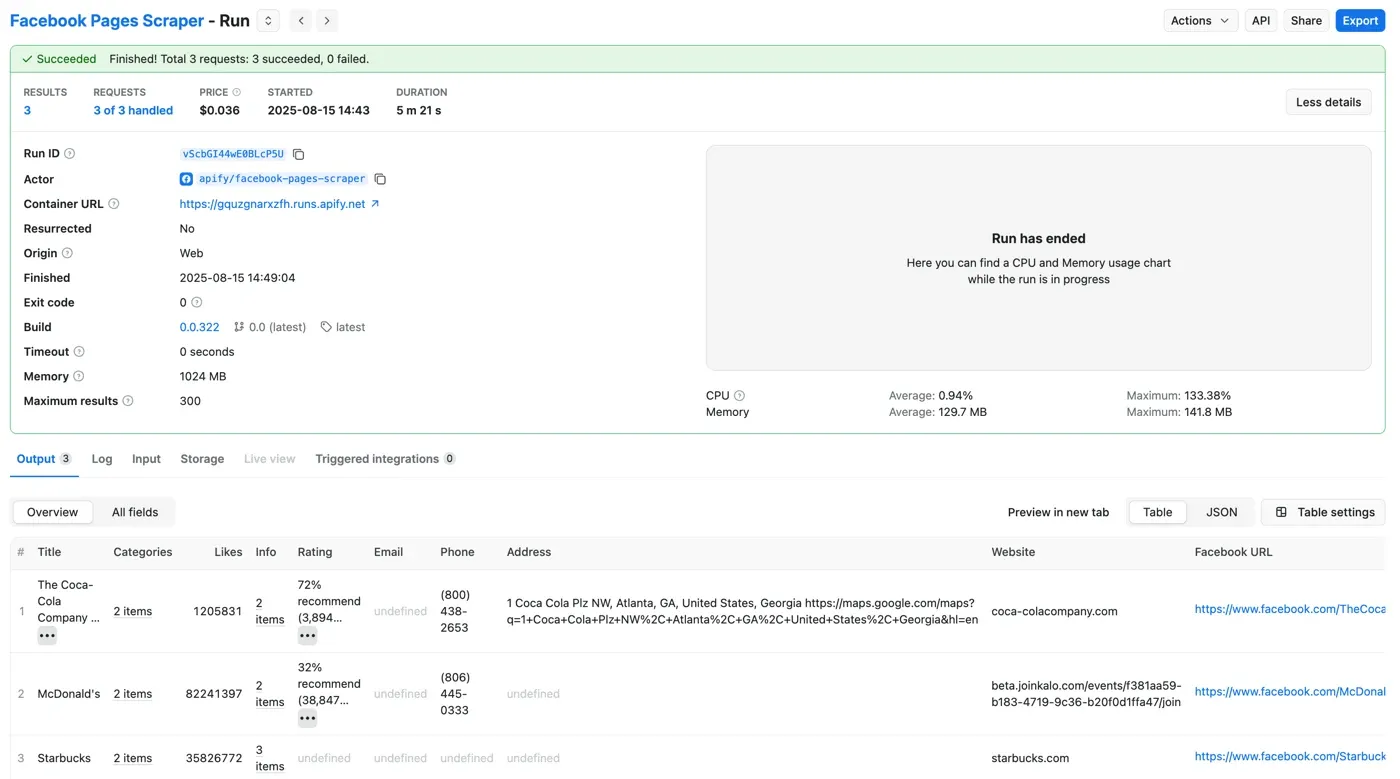
Принимайте результат после четырех проверок:
- Соответствие страницы. URL в выгрузке или стабильный идентификатор страницы соответствует входному адресу. Перенаправления и несовпадение организаций требуют отдельной проверки.
- Обязательные поля. Запись содержит поля, необходимые для отчета, с ожидаемыми типами данных.
- Причины пропусков. Недоступные значения остаются
null; по возможности указано, почему они отсутствуют. Например, источник недоступен или нужного поля на странице нет. Ошибки парсера учитываются отдельно. - Чтение выгрузки. Скачанный JSON разбирается в ожидаемую структуру, а CSV читается с правильными столбцами и кодировкой. Запись из файла сопоставлена с исходной страницей.
Шаг 5. Выгрузите нужные поля
Для вложенных записей выбирайте JSON, для плоского отчета — CSV или Excel, если текущая версия инструмента поддерживает эти форматы.
В прежнем окне экспорта параметр View влиял на состав полей выгрузки. Проверяйте скачанный файл: представление в интерфейсе может показывать не все данные.
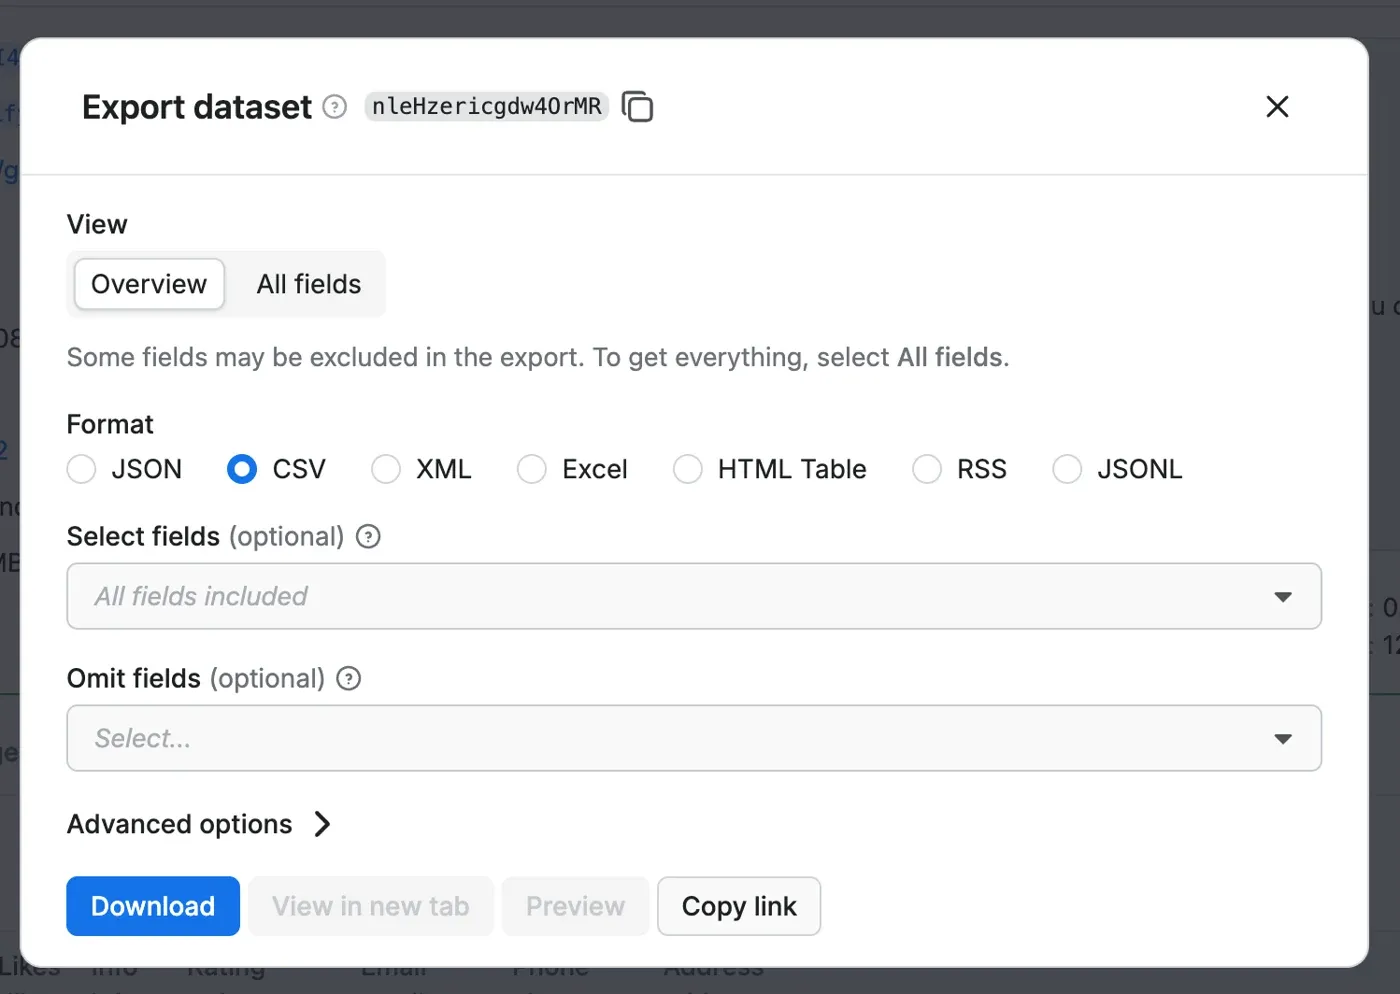
Храните исходную выгрузку вместе с нормализованным набором данных. Время наблюдения фиксируйте во время сбора в формате ISO 8601 и часовом поясе UTC. Не смешивайте его со временем экспорта.
Если точность исходной временной отметки неизвестна, сохраните и ее текстовое представление.
Шаг 6. Проверьте схему перед запуском по расписанию
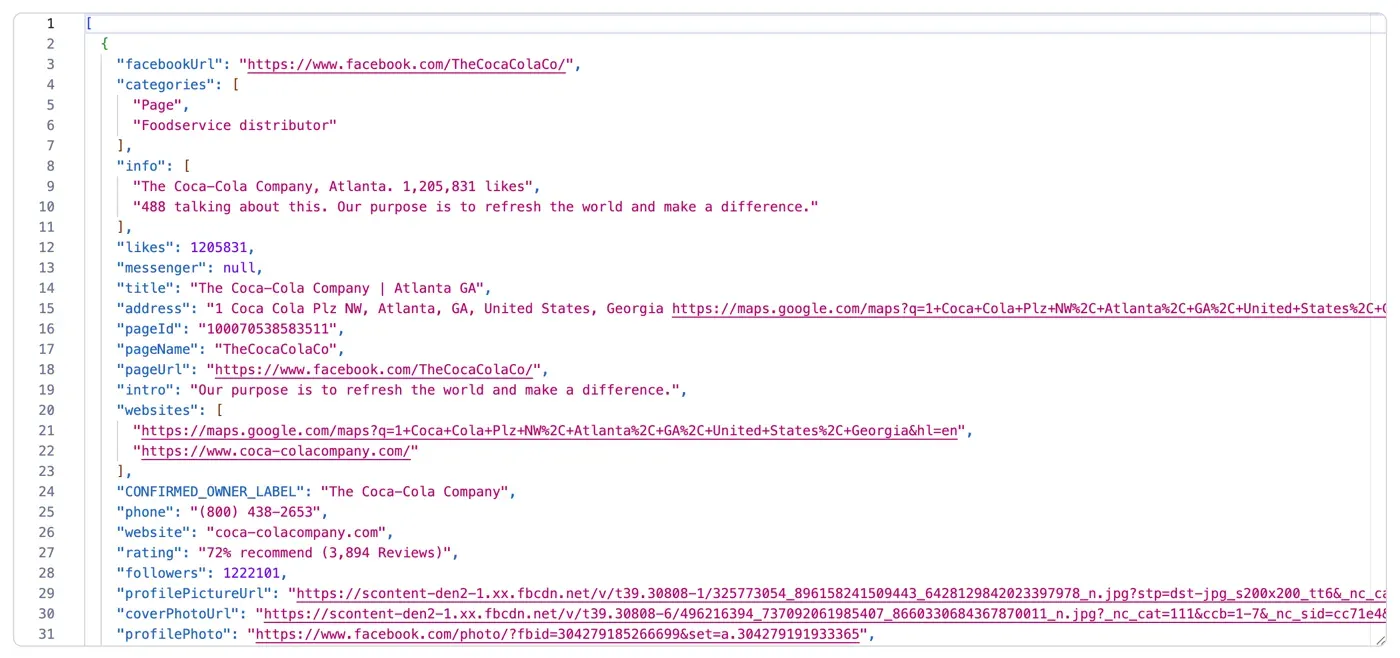
{
  "facebookUrl": "https://www.facebook.com/TheCocaColaCo/",
  "pageName": "TheCocaColaCo",
  "title": "The Coca-Cola Company | Atlanta GA"
}
В этом фрагменте можно сопоставить URL с входной страницей, проверить строковый тип всех трех значений и корректность JSON. Для нового запуска те же проверки нужны уже для скачанного файла и всех обязательных полей.
Дополнительно:
- удаляйте дубликаты по нормализованному URL страницы;
- для меняющихся значений храните снимки с отметкой времени наблюдения;
- отдельно считайте страницы, по которым предпринималась попытка сбора, страницы с проверенными данными и страницы с ошибками.
Как подготовить данные страниц Facebook к анализу
Для отчетов нужна единая схема: одинаковые поля, понятные типы и зафиксированное время наблюдения. Короткое имя страницы и отображаемое название храните раздельно; статус проверки и причины пропусков добавляйте в своем процессе обработки.
| Поле | Тип | Соответствие исходным данным и смысл |
|---|---|---|
page_url |
string | Проверенный URL страницы; в историческом примере — facebookUrl |
page_handle |
string или null | Исходное поле pageName; короткое имя страницы |
page_title |
string или null | Исходное поле title; отображаемое название |
category |
array или null | Категории из источника, если они есть |
source_field |
object | Соответствие нормализованных полей фактическим ключам выгрузки |
observed_at_utc |
string или null | Реальное время наблюдения в ISO 8601 UTC; не заполняется временем скачивания |
status и missing_reason |
string и string или null | Результат проверки приложением и причина отсутствия обязательных данных |
Если нужны тексты публикаций Facebook, выбирайте инструмент для постов. Проверяйте стабильные URL или идентификаторы публикаций, время публикации в источнике и время наблюдения при сборе.
Выгрузка сведений о странице описывает компанию или организацию, которой принадлежат публикации. Она не заменяет записи самих постов.
Как проверить подключение к прокси через Python и Playwright
Этот дополнительный пример проверяет соединение с сервисом определения IP в собственном браузерном скрипте. Он не собирает данные Facebook и не подключает внешний прокси к готовому Actor автоматически.
Подготовьте окружение и учетные данные
Для выбранного продукта возьмите адрес шлюза и параметры аутентификации, сверившись с руководством по интеграции прокси с Python. Если работаете с готовым Actor, сначала подтвердите поддержку внешнего прокси.
В локальной среде установите согласованную для вашего проекта версию Playwright и Chromium. Вместе с результатами сохраните точные версии Python, Playwright, браузера и операционной системы.
Приведенный ниже Python-код сохраните в файл proxy_check.py. Команды PowerShell запрашивают учетные данные при выполнении, поэтому пароль не записывается в историю команд как текстовая строка:
python -m pip install playwright
python -m playwright install chromium
$env:ROLA_PROXY_SERVER = Read-Host 'Proxy scheme host and port'
$proxyCredential = Get-Credential -Message 'Rola proxy credentials'
$env:ROLA_PROXY_USERNAME = $proxyCredential.UserName
$env:ROLA_PROXY_PASSWORD = $proxyCredential.GetNetworkCredential().Password
try {
    python proxy_check.py
    if ($LASTEXITCODE -ne 0) { throw 'Proxy check failed' }
    python -m pip freeze > requirements-environment.txt
} finally {
    Remove-Item Env:ROLA_PROXY_SERVER -ErrorAction SilentlyContinue
    Remove-Item Env:ROLA_PROXY_USERNAME -ErrorAction SilentlyContinue
    Remove-Item Env:ROLA_PROXY_PASSWORD -ErrorAction SilentlyContinue
    Remove-Variable proxyCredential -ErrorAction SilentlyContinue
}
Файл requirements-environment.txt содержит версии установленных пакетов. Храните его с фактической записью запуска: список зависимостей сам по себе не подтверждает работоспособность решения.
Процессы с соответствующими правами могут читать переменные окружения. Выполняйте пример в контролируемом локальном сеансе.
Выполните проверку подключения
В коде указаны тайм-ауты запуска браузера и перехода к странице по 30000 мс. Ответ проверяется как JSON-объект с корректным IP-адресом; браузер закрывается в блоке finally.
import asyncio
import ipaddress
import json
import os
from urllib.parse import urlsplit
from playwright.async_api import async_playwright

async def check_proxy():
    server = os.environ["ROLA_PROXY_SERVER"]
    parsed = urlsplit(server)
    if parsed.scheme != "http" or not parsed.hostname or not parsed.port:
        raise ValueError("Use an authenticated HTTP gateway with a port")
    proxy = {
        "server": server,
        "username": os.environ["ROLA_PROXY_USERNAME"],
        "password": os.environ["ROLA_PROXY_PASSWORD"],
    }
    async with async_playwright() as p:
        browser = await p.chromium.launch(proxy=proxy, timeout=30000)
        try:
            page = await browser.new_page()
            response = await page.goto(
                "https://api.ipify.org?format=json",
                wait_until="domcontentloaded", timeout=30000,
            )
            if response is None or not response.ok:
                raise RuntimeError("IP echo returned no successful response")
            payload = await response.json()
            if not isinstance(payload, dict) or not isinstance(payload.get("ip"), str):
                raise ValueError("IP echo must return an object with an IP string")
            exit_ip = ipaddress.ip_address(payload["ip"])
            print(json.dumps({"check": "passed", "exit_ip": str(exit_ip)}))
        finally:
            await browser.close()

asyncio.run(check_proxy())
Документация Playwright по сетевым настройкам описывает подключение через прокси. Этот пример рассчитан на HTTP-шлюз с аутентификацией и указанным портом. Если продукт требует SOCKS5, отдельно проверьте поддержку нужной конфигурации клиентом.
Проверка завершится ошибкой, если:
- отсутствует обязательная переменная окружения;
- адрес шлюза или порт заданы неверно;
- истек тайм-аут;
- сервис не вернул успешный ответ;
- ответ не соответствует ожидаемому JSON;
- поле
ipне содержит корректного IP-адреса.
Прежде чем переходить к сбору данных, устраните причину ошибки.
Отдельно проверьте маршрут и данные
После успешной проверки локально сравните полученный выходной IP с адресом при прямом запросе. При публикации скриншотов при необходимости скрывайте адрес.
Страну выхода проверьте отдельным доверенным сервисом. Если заданию нужен постоянный IP на определенное время, проверяйте адрес в контрольных точках запуска и убедитесь, что сессия сохраняется достаточно долго.
После этого в разрешенном процессе сбора проверьте доступ к Facebook и содержимое полей страницы. Успех IP-проверки не заменяет эту проверку данных.
Как найти причину ошибки перед повторным запуском
Сначала определите, где возник сбой: при подключении к прокси, в ответе целевого сайта или при извлечении полей. После исправления повторно проверьте именно этот этап; учетные данные и конфиденциальные результаты не включайте в общие логи.
| Симптом | Что проверить | Что сделать | Критерий повторной проверки |
|---|---|---|---|
| Не разрешается DNS-имя прокси | Разрешение имени шлюза через Resolve-DnsName |
Исправить имя или устранить проблему локального DNS и сети | Имя разрешается; можно проверять соединение |
| Соединение с прокси отклонено | Хост и порт шлюза через Test-NetConnection |
Проверить порт, доступность сервера и правила межсетевого экрана | TCP-соединение устанавливается; можно проверять аутентификацию |
| Тайм-аут соединения | Разрешение имени и TCP-подключение по отдельности | Проверить маршрут, межсетевой экран, сервер и конечный тайм-аут подключения | Соединение устанавливается в заданный срок |
| Тайм-аут чтения или перехода к странице | Установилось ли соединение и на каком этапе остановилась загрузка | Проверить время ответа и загрузку нужного содержимого; задать конечный срок ожидания | Нужный ответ и поля получены до истечения срока |
| HTTP 407 на прокси (разбор на английском) | Ошибку аутентификации на уровне прокси | Исправить учетные данные или разрешенные настройки белого списка IP | Аутентификация проходит при обращении к разрешенному тестовому адресу |
| HTTP 403 от сайта или контрольная проверка | Ответ сайта и разрешение на доступ | Приостановить работу и пересмотреть способ доступа | Доступ снова разрешен; ротация IP не используется как обход |
| HTTP 429 от сайта | Код ответа и заголовок Retry-After, если он передан |
Выдержать указанную паузу и соблюдать ограничения частоты | Разрешенный запрос с низкой частотой проходит без продолжающегося ограничения |
| Страница открывается, но полей нет | Содержимое, язык и регион, представление страницы и соответствие полей парсеру | Разделить отсутствие данных в источнике и ошибку извлечения | Страница и обязательные поля проверены, причины пропусков записаны |
Тайм-аут браузерного перехода может включать задержки на нескольких этапах. Не относите его автоматически к чтению ответа: используйте базовые проверки соединения, чтобы локализовать причину.
Успешная TCP-проверка не доказывает правильность учетных данных или доступность целевого сайта. После исправления одного уровня проверьте его повторно и лишь затем перезапускайте все задание.
Что записать перед переходом к регулярному сбору
Решение о расширении сбора принимайте по результатам небольшого запуска на разрешенных страницах. Сохраненные условия, затраты и результаты позволяют повторить проверку и разобрать сбой.
| Группа | Что зафиксировать |
|---|---|
| Окружение | Дату и часовой пояс, ОС, инструмент и точную сборку; версии Python и браузера, если они использовались |
| Подключение и разрешения | Прокси-продукт, протокол и разрешенный объем сбора |
| Условия запуска | Нужные поля, конечные лимиты времени, политику повторных попыток и критерии успеха |
| Результаты | Длительность, израсходованный трафик, число проверенных записей, ошибки и их причины |
К записи запуска приложите последовательность скриншотов:
- Входные URL и конечный тайм-аут.
- Идентификатор запуска и версию сборки.
- Исходную запись рядом с таблицей соответствия полей.
- Результат проверки выгруженного файла.
Даты и имена полей должны оставаться читаемыми. Учетные данные и лишние персональные сведения скройте.
Храните и саму выгрузку. Скриншот фиксирует состояние интерфейса, но корректность разбора нужно проверять на скачанном файле.
Когда переходить к сбору по расписанию
Регулярный парсинг страниц Facebook имеет смысл после пробного запуска, который дал проверенные записи и сохранил связь с источниками. Для этого нужны разрешенный источник, ограниченное время работы и пригодная к обработке выгрузка.
Rola IP обеспечивает сетевое подключение, если выбранный инструмент поддерживает внешний прокси. Для независимых заданий рассматривайте резидентные прокси с подходящей сессией, для постоянного адреса — подходящий статический продукт. Маршрут соединения и результат сбора проверяйте раздельно.