
Как собирать результаты поиска Bing на Python с Rola IP
9 окт. 2026 г. · Руководства · 10 мин. чтения
Парсинг Bing помогает собрать поисковую выдачу в таблицу для SEO-мониторинга и анализа найденных страниц. В этом руководстве одна запись — органический результат обычного веб-поиска. Скрипт получает заголовок, конечный URL, сниппет и позицию на странице, а затем сохраняет их в JSON и CSV, который открывается в Excel. Рекламные объявления, дополнительные ссылки и ответы Copilot в список органики не попадают.
Коротко: Requests и BeautifulSoup извлекают органические карточки Bing. Для сравнения выдачи сохраняйте запрос, позицию, URL ответа, время и исходный HTML; при проверке доступа или ограничении частоты скрипт остановится.
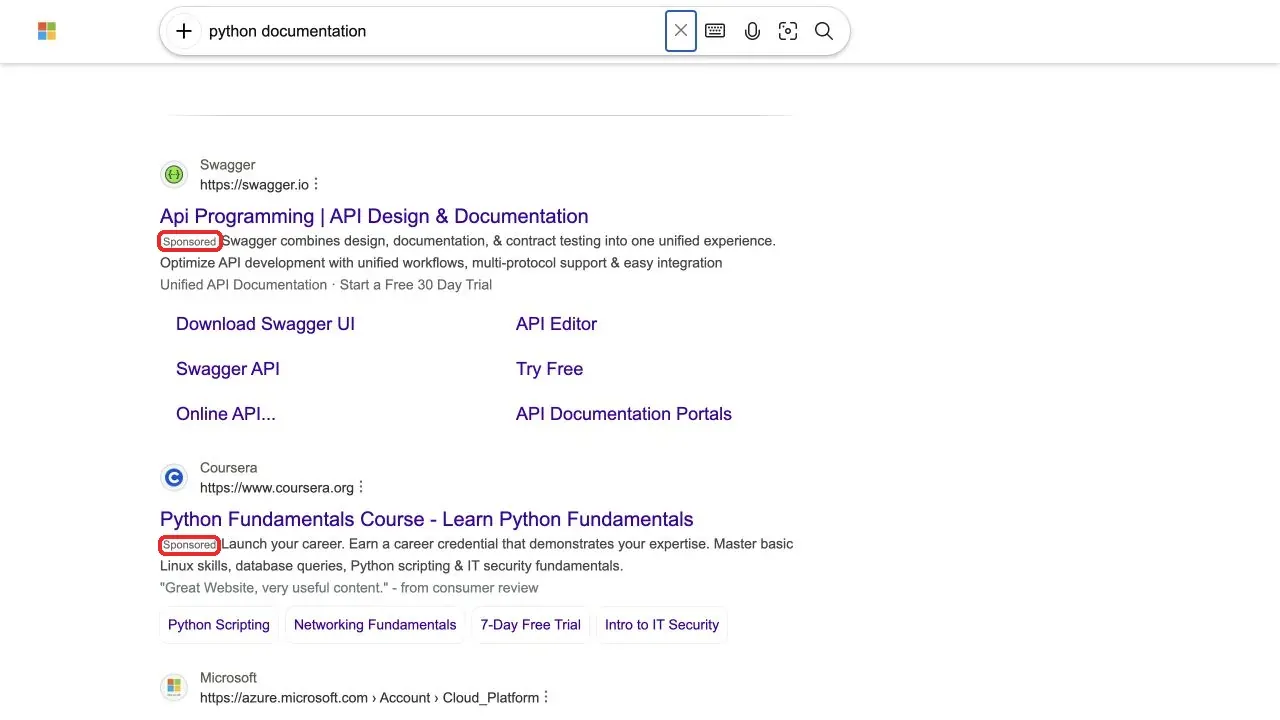
В коде используется запрос документация Python и русскоязычный интерфейс Bing. Скриншоты показывают те же элементы на выдаче по английскому запросу python documentation: структура страницы помогает найти селекторы, но сами результаты будут другими.
Какие данные собирать при парсинге Bing
Для SEO-мониторинга важна сопоставимость запусков. Один заголовок не объясняет, почему результат изменился: на выдачу влияют время, язык, регион, cookies и сетевой выход. Минимальный набор полей:
| Поле | Значение | Практическое применение |
|---|---|---|
query |
Поисковый запрос | Одинаковый запрос внутри одной серии измерений |
page, position_on_page |
Номер страницы и позиция среди извлечённой органики | Не выдавайте позицию на странице за глобальный ранг |
title, url |
Заголовок и конечный адрес | Сравнение найденных страниц |
snippet |
Сниппет Bing | Может отсутствовать и не является полным текстом страницы |
raw_href |
Исходная ссылка из Bing | Проверка редиректа и разбор ошибок |
source_url, fetched_at_utc |
URL ответа и время UTC | Воспроизводимость запуска |
Основные результаты, быстрые ссылки под заголовком и блок связанных запросов — разные типы данных. Быстрые ссылки не следует считать отдельными результатами, а число «примерно найденных результатов» нельзя использовать как точный объём выгрузки.
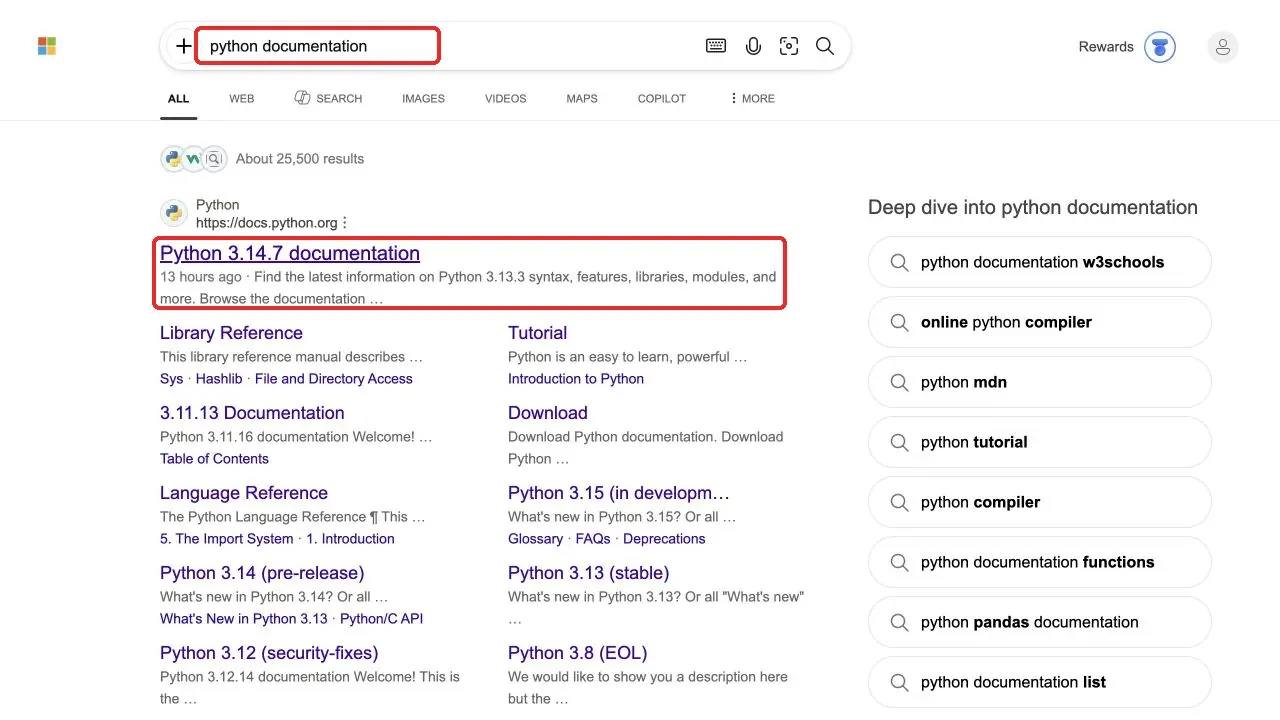
Пометка Sponsored обозначает рекламу. Поэтому парсер ищет контейнер органического результата, а не каждый h2 и каждый a на странице.
Учитывайте правила использования Microsoft и допустимый объём запросов.
Подготовка окружения Python
Виртуальное окружение и зависимости
Подойдёт Python 3.10 или новее. В терминале:
mkdir bing-scraper
cd bing-scraper
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requests beautifulsoup4
В Windows замените python3 на py, а для CMD используйте .venv\Scripts\activate.bat. Для PowerShell команда активации — .venv\Scripts\Activate.ps1. JupyterLab нужен только для пошаговой проверки:
python -m pip install jupyterlab
python -m jupyterlab
Проверьте, что ноутбук использует то же окружение:
import sys
import requests
import bs4
print("Python:", sys.version.split()[0])
print("Requests:", requests.__version__)
print("Beautiful Soup:", bs4.__version__)
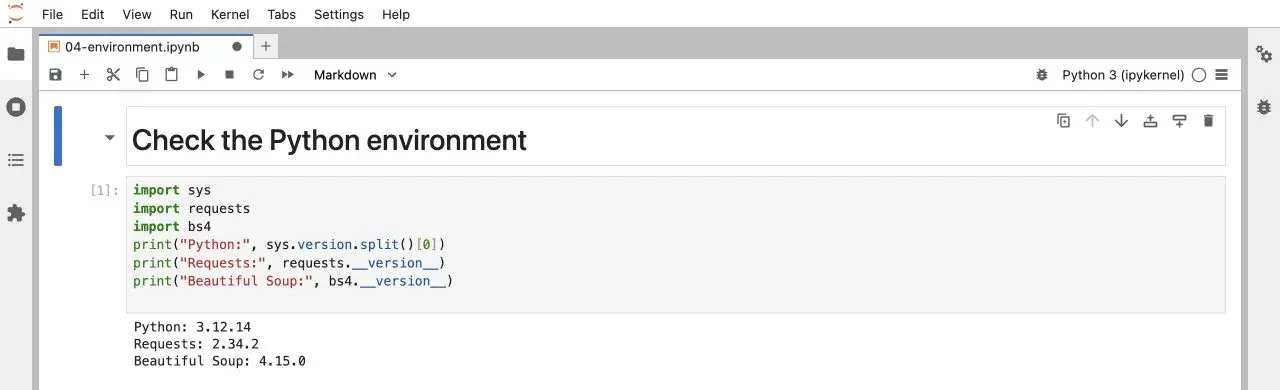
Создайте файл bing_scraper.py и добавьте в него все блоки Python ниже в порядке публикации. Терминальные команды в этот файл не включаются.
Как найти поля выдачи Bing в HTML
Проверка страницы и DOM
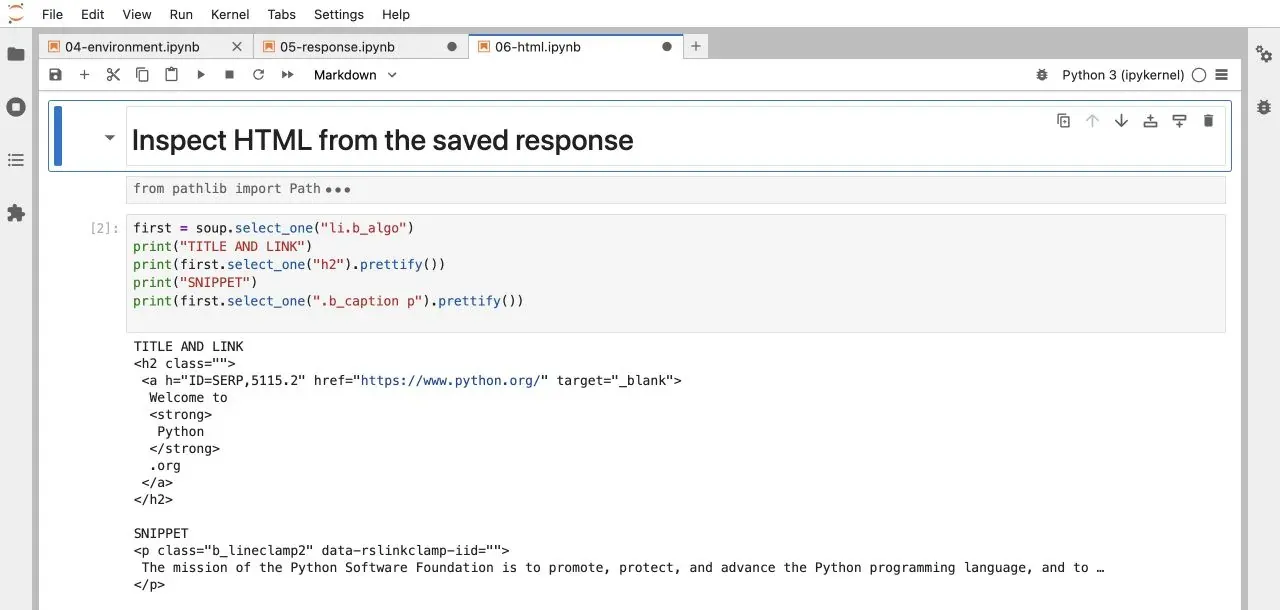
Откройте поиск Bing по запросу «документация Python». Параметр setlang задаёт язык интерфейса; регион выдачи зависит и от сетевого выхода. Зафиксируйте заголовок, адрес и сниппет первого органического результата.
В Chrome нажмите правой кнопкой по заголовку и выберите «Просмотреть код» либо откройте DevTools через Ctrl+Shift+I. Во вкладке Elements найдите ссылку внутри h2, а затем внешний контейнер li. Для органических результатов скрипт ниже использует li.b_algo и вложенную ссылку h2 a.
На скриншоте выбран рекламный заголовок: рядом видна пометка Sponsored, а в DOM — контейнер с классом b_ad. Это показывает, почему одного селектора h2 a недостаточно: сначала нужно выбрать контейнер органического результата.
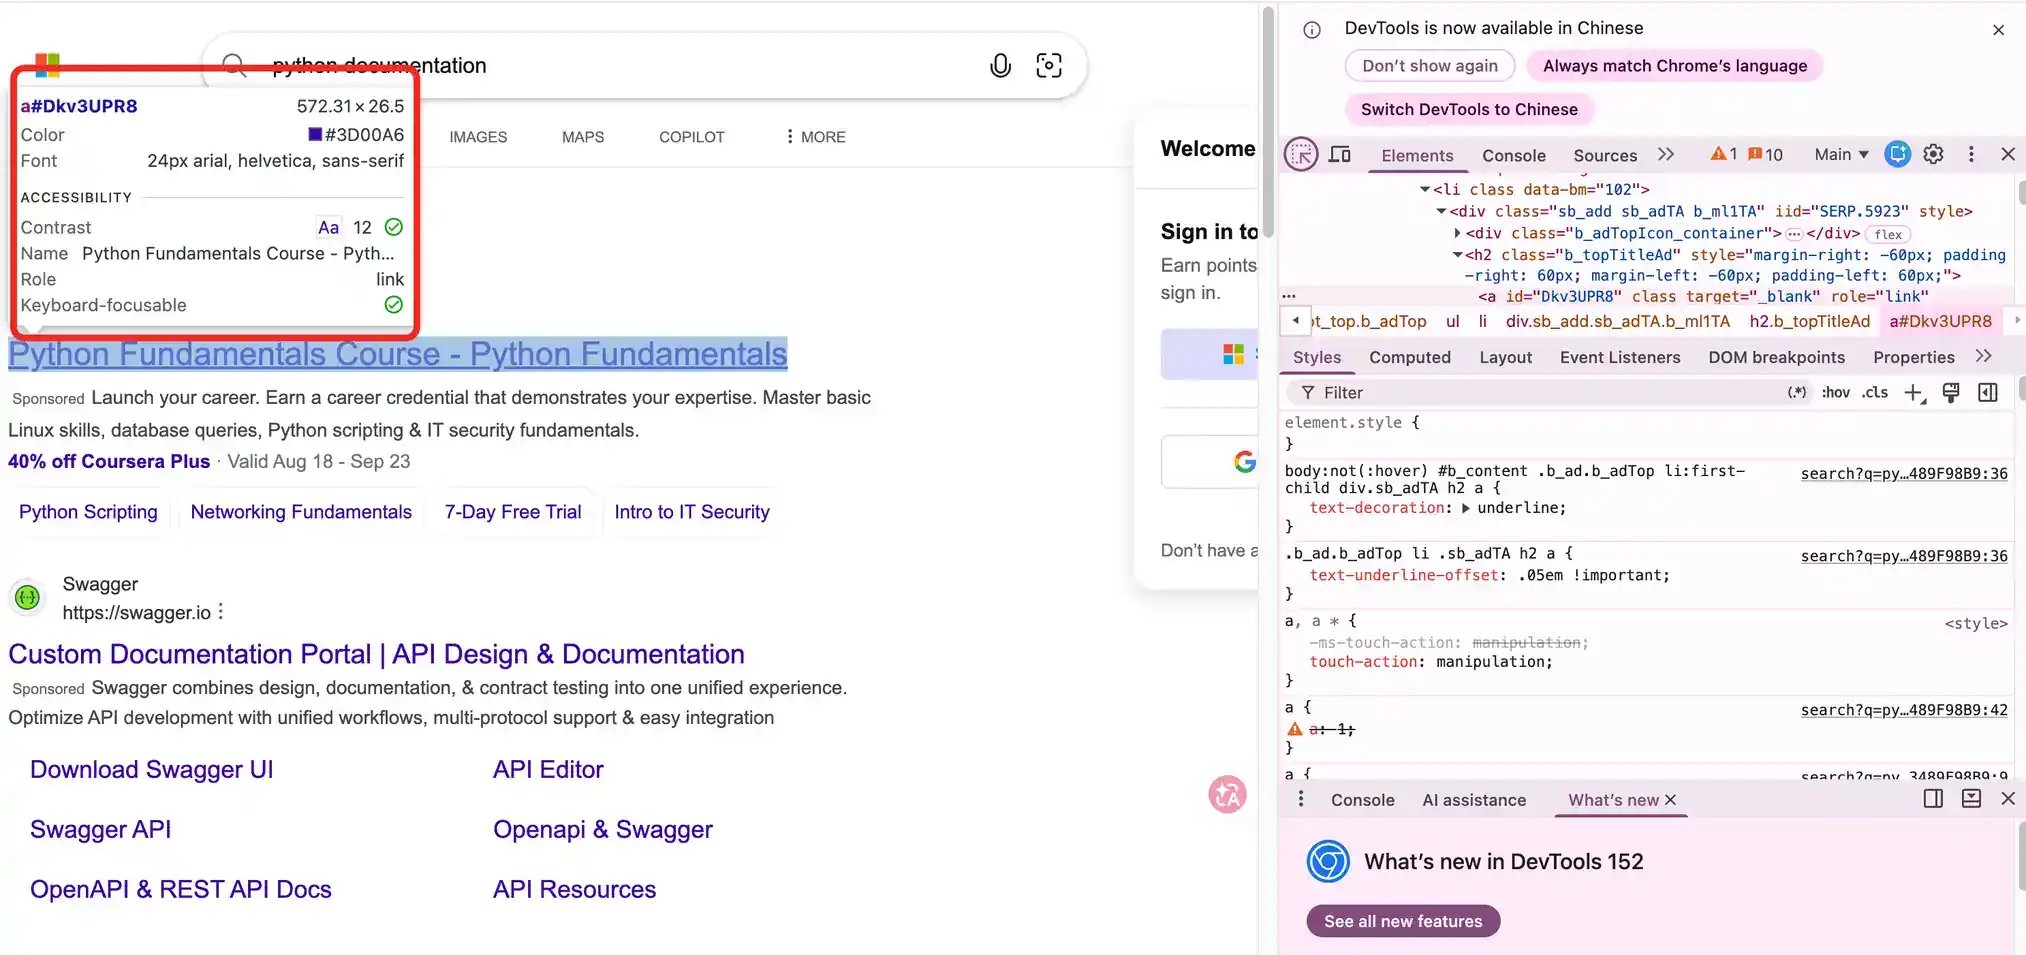
Во вкладке Network выберите Doc, обновите страницу и откройте запрос search. Поиск по b_algo или по записанному заголовку показывает, есть ли данные в HTML ответа. Elements отображает текущий DOM браузера, а Response — тело ответа сервера. Парсер нужно проверять именно на том HTML, который получает Python.
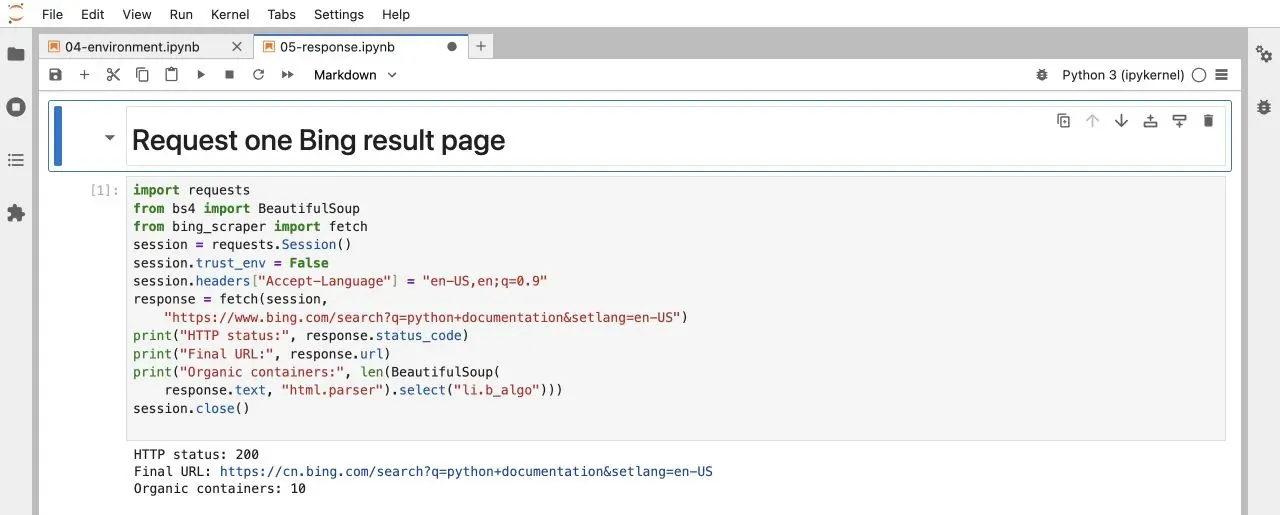
Загрузка ответа
Заголовок Accept-Language в примере задаёт предпочтительный язык ответа. Если вы хотите отдельно настроить User-Agent и другие заголовки Requests, пригодится руководство по заголовкам запросов в Python Requests.
Первая часть скрипта проверяет URL поиска, каждый редирект, тип содержимого и коды 403/429:
import argparse
import base64
import binascii
import csv
import getpass
import json
import time
from datetime import datetime, timezone
from pathlib import Path
from urllib.parse import parse_qs, quote, urlencode, urljoin, urlsplit

import requests
from bs4 import BeautifulSoup


def bing_url(url):
    p = urlsplit(url)
    return (p.scheme == "https" and p.hostname in
            {"www.bing.com", "cn.bing.com", "bing.com"}
            and p.path == "/search" and not p.username
            and p.port in (None, 443))

def fetch(session, url):
    for _ in range(5):
        if not bing_url(url):
            raise RuntimeError("Unexpected search URL; stopped.")
        r = session.get(url, timeout=(10, 30), allow_redirects=False)
        if r.is_redirect:
            url = urljoin(r.url, r.headers["Location"])
            continue
        if r.status_code == 429:
            retry_after = r.headers.get("Retry-After", "not provided")
            raise RuntimeError(f"HTTP 429; stopped. Retry-After: {retry_after}")
        if r.status_code == 403:
            raise RuntimeError("HTTP 403; stopped.")
        r.raise_for_status()
        if "text/html" not in r.headers.get("Content-Type", ""):
            raise RuntimeError("Expected HTML; stopped.")
        r.encoding = "utf-8"
        return r
    raise RuntimeError("Too many redirects; stopped.")
Если Requests получает ответ с cn.bing.com, а браузер показывает другую страницу, сравните регион, язык, cookies и фактический URL ответа.
Извлечение заголовков, ссылок и сниппетов
Конечный URL результата
Заголовок берётся из текста h2 a, ссылка — из href. Отображаемый cite может быть сокращённым. Некоторые ссылки имеют формат редиректа Bing /ck/a; ниже декодируется только распознаваемый параметр u с префиксом a1. При неизвестном формате сохраняется исходная ссылка, а сайт результата не открывается.
def destination(href, base_url):
    url = urljoin(base_url, href)
    p = urlsplit(url)
    if p.hostname in {"www.bing.com", "cn.bing.com", "bing.com"} and p.path == "/ck/a":
        value = parse_qs(p.query).get("u", [""])[0]
        if value.startswith("a1"):
            try:
                payload = value[2:]
                decoded = base64.urlsafe_b64decode(payload + "=" * (-len(payload) % 4)).decode("utf-8")
                if urlsplit(decoded).scheme in {"http", "https"}:
                    return decoded
            except (binascii.Error, ValueError, UnicodeError):
                pass
    return url if p.scheme in {"http", "https"} else ""
Разбор органических карточек
Для каждой li.b_algo найдите h2 a[href], затем .b_caption p. Если сниппета нет, запишите пустую строку и не удаляйте результат. Позиции нумеруются только среди реально извлечённых органических карточек.
def parse_page(html, page_url, query, page_number):
    soup = BeautifulSoup(html, "html.parser")
    if soup.select_one('#b_captcha, iframe[src*="captcha"]'):
        raise RuntimeError("Verification page; stopped.")
    rows = []
    stamp = datetime.now(timezone.utc).isoformat(timespec="seconds")
    for item in soup.select("li.b_algo"):
        a = item.select_one("h2 a[href]")
        if a is None or not a.get_text(strip=True):
            continue
        url = destination(a["href"], page_url)
        if not url:
            continue
        snippet = item.select_one(".b_caption p") or item.select_one("p.b_lineclamp2, p.b_lineclamp3")
        rows.append({
            "query": query, "page": page_number,
            "position_on_page": len(rows) + 1,
            "title": a.get_text(" ", strip=True), "url": url,
            "snippet": snippet.get_text(" ", strip=True) if snippet else "",
            "raw_href": a["href"],
            "source_url": page_url, "fetched_at_utc": stamp,
        })
    if not rows:
        raise RuntimeError("No organic rows; inspect HTML, do not assume end.")
    link = soup.select_one("a.sb_pagN[href]")
    next_url = urljoin(page_url, link["href"]) if link else None
    if next_url and not bing_url(next_url):
        raise RuntimeError("Unexpected next-page URL; stopped.")
    return rows, next_url
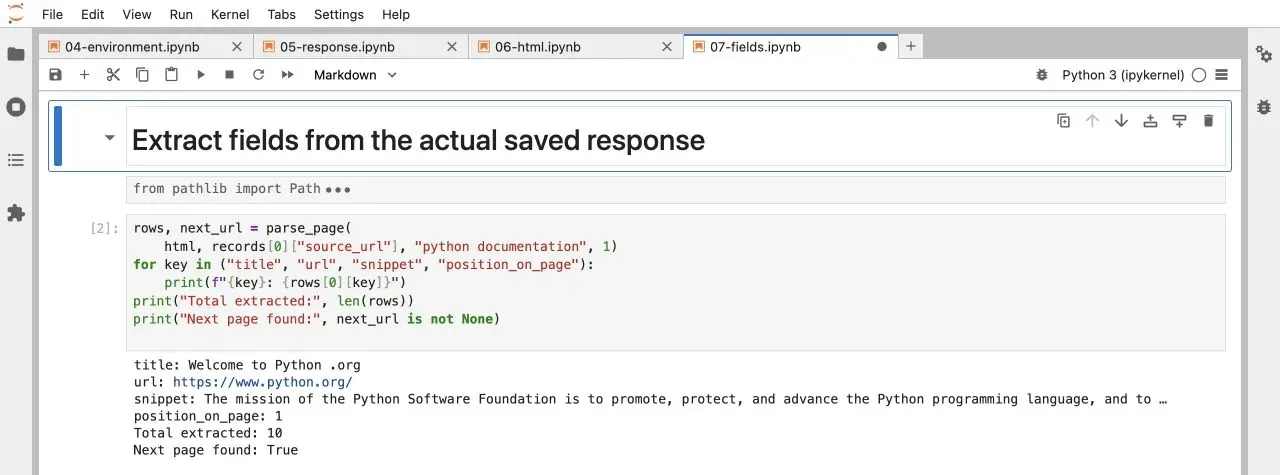
Сниппет — текст Bing, а не описание целевой страницы. Сохраняйте исходное значение и делайте отдельное очищенное поле для анализа. Селекторы могут измениться, поэтому их нужно периодически проверять.
Пагинация и экспорт CSV
Следующая страница
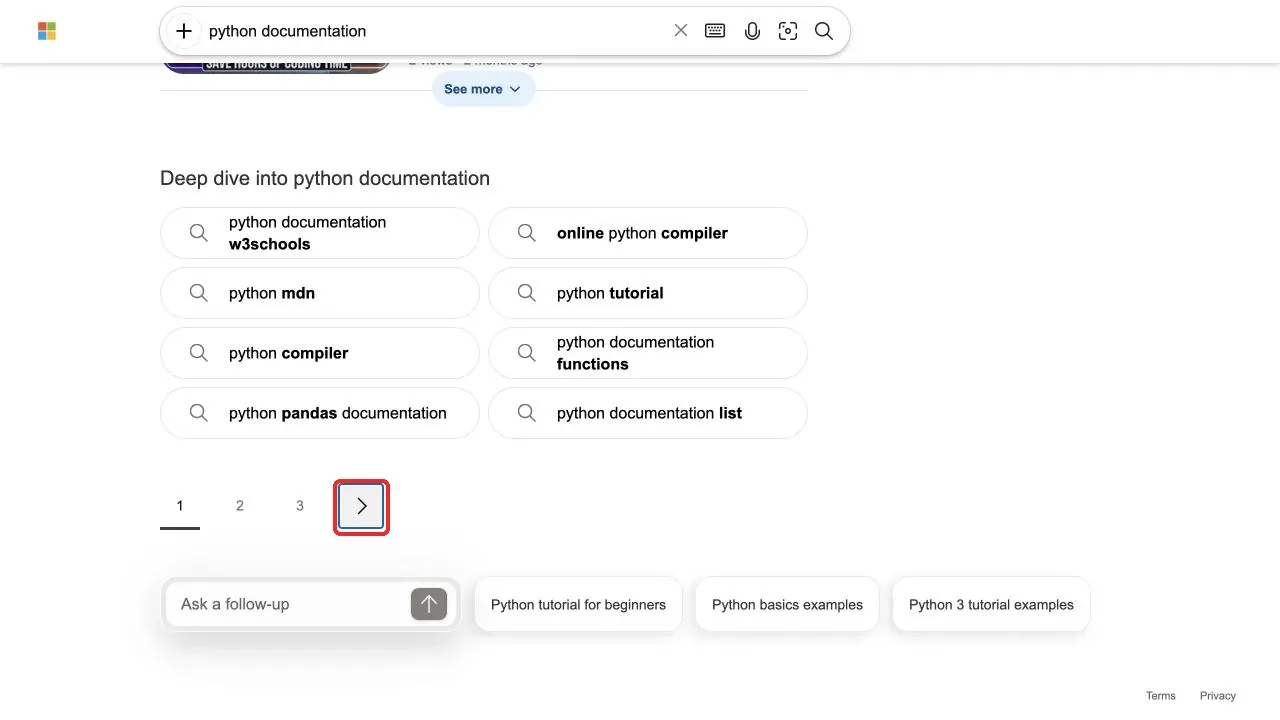
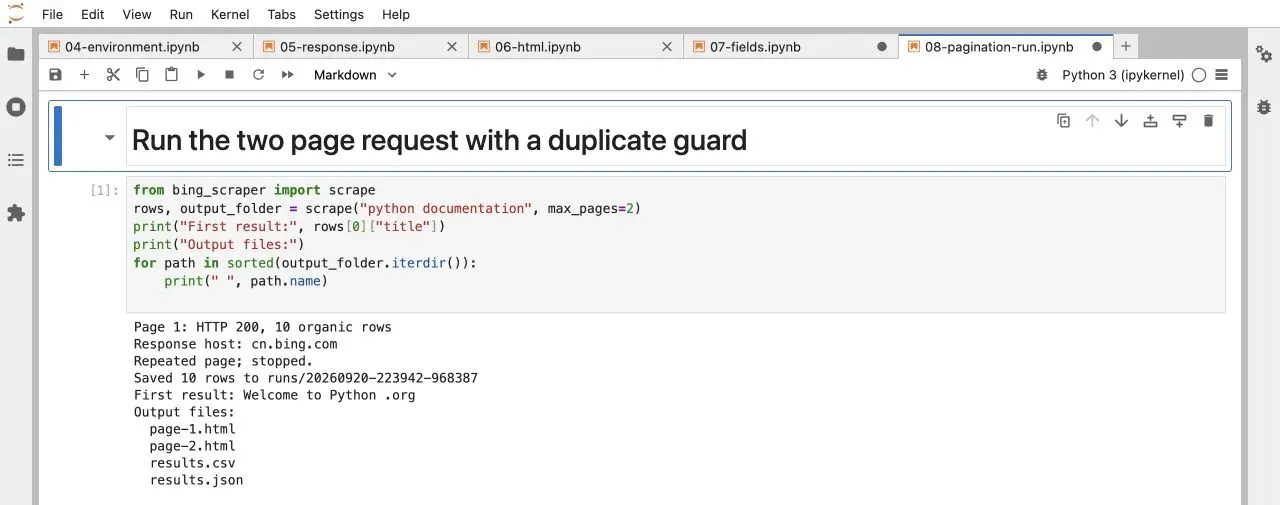
Внизу выдачи найдите стрелку вправо и проверьте её href. Надёжнее читать a.sb_pagN, чем вручную строить параметры first=11, 21 и т. д. Страница с HTTP 200 может повторять предыдущую, поэтому сравнивайте сигнатуры URL и сохраняйте HTML для диагностики.
Сохранение данных
def excel_safe(value):
    if isinstance(value, str):
        if value.lstrip().startswith(("=", "+", "-", "@")) or value.startswith(("\t", "\r", "\n")):
            return "'" + value
    return value

def save_rows(rows, folder):
    if not rows:
        raise RuntimeError("No data to export.")
    folder = Path(folder)
    folder.mkdir(parents=True, exist_ok=True)
    (folder / "results.json").write_text(json.dumps(rows, ensure_ascii=False, indent=2), encoding="utf-8")
    with (folder / "results.csv").open("w", encoding="utf-8-sig", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=list(rows[0]))
        writer.writeheader()
        writer.writerows({k: excel_safe(v) for k, v in r.items()} for r in rows)
UTF-8 с BOM помогает Excel правильно распознать кириллицу. Не переименовывайте CSV в .xlsx: импортируйте файл в Excel и сохраните как книгу.
Подключение прокси Rola IP
Выбор сетевого выхода
Для регулярного сравнения одних и тех же запросов в фиксированном регионе удобно использовать статические резидентские прокси Rola IP: постоянный сетевой выход убирает одну переменную из анализа.
Если нужно сравнивать выдачу в разных странах, изучите резидентские прокси. Если этот тип подключения вам незнаком, начните с объяснения, как работает residential proxy. Ротация и длительность сессии должны соответствовать настройкам в кабинете и актуальным условиям тарифа.
Прокси задаёт сетевой маршрут; выбор селекторов и контроль качества выполняет скрипт. Другие сценарии применения описаны на странице прокси для веб-скрапинга.
Параметры подключения
В кабинете Rola IP выберите продукт, регион и режим сессии, затем возьмите адрес сервера, порт и реквизиты авторизации. В документации по параметрам прокси описаны страна, город и сессия. Если используется белый список, добавьте публичный IP машины; подробности настройки есть в руководстве по подключению Python.
Добавьте в скрипт интерактивную настройку:
def configure_proxy(session):
    scheme = input("Proxy scheme (http/socks5h): ").strip()
    host = input("Proxy host only: ").strip()
    port = int(input("Proxy port: "))
    if scheme not in {"http", "socks5h"}:
        raise ValueError("Unsupported scheme.")
    if not host or any(c.isspace() or c in "/@?#:[]" for c in host):
        raise ValueError("Enter only the proxy hostname or IPv4 address.")
    if not 1 <= port <= 65535:
        raise ValueError("Invalid port.")
    user = getpass.getpass("Proxy username (hidden): ")
    password = getpass.getpass("Proxy password (hidden): ")
    if not user or not password:
        raise ValueError("This example requires username/password authentication.")
    auth = quote(user, safe="") + ":" + quote(password, safe="")
    proxy = f"{scheme}://{auth}@{host}:{port}"
    session.proxies.update({"http": proxy, "https": proxy})
Для порта SOCKS5 установите requests[socks] и выберите socks5h. Если выдан HTTP-порт, выберите http:
python -m pip install "requests[socks]"
python bing_scraper.py "документация Python" --pages 1 --proxy
Схема http описывает подключение к прокси: через такой эндпоинт можно обращаться и к HTTPS-сайту, используя туннель CONNECT. Поэтому адрес Bing с https:// не требует схемы https в адресе прокси. Вариант socks5h передаёт разрешение имени целевого сайта прокси-серверу; сам протокол SOCKS5 не обеспечивает шифрование соединения.
session.trust_env = False не даёт переменным окружения незаметно переопределить прокси. Если корпоративная сеть требует собственный сертификат, укажите файл CA явно и не отключайте проверку TLS.
Последний блок связывает функции в один скрипт. Он сохраняет HTML каждой страницы, ограничивает запуск тремя страницами, ждёт пять секунд между запросами и останавливается при повторении страницы:
def scrape(query, max_pages=2, proxy=False):
    if not 1 <= max_pages <= 3:
        raise ValueError("This example supports 1 to 3 pages.")
    folder = Path("runs") / datetime.now().strftime("%Y%m%d-%H%M%S-%f")
    folder.mkdir(parents=True)
    session = requests.Session()
    session.trust_env = False
    session.headers["Accept-Language"] = "ru-RU,ru;q=0.9"
    if proxy:
        configure_proxy(session)
    url = "https://www.bing.com/search?" + urlencode({"q": query, "setlang": "ru-RU"})
    all_rows, seen_pages, seen_signatures = [], set(), set()
    try:
        for page in range(1, max_pages + 1):
            if url in seen_pages:
                break
            seen_pages.add(url)
            response = fetch(session, url)
            (folder / f"page-{page}.html").write_text(response.text, encoding="utf-8")
            rows, next_url = parse_page(response.text, response.url, query, page)
            signature = tuple(row["url"] for row in rows)
            if signature in seen_signatures:
                print("Repeated page; stopped.")
                break
            seen_signatures.add(signature)
            all_rows.extend(rows)
            print(f"Page {page}: HTTP {response.status_code}, {len(rows)} organic rows")
            print("Response host:", urlsplit(response.url).hostname)
            if not next_url or page == max_pages:
                break
            url = next_url
            time.sleep(5)
    finally:
        session.close()
        if all_rows:
            save_rows(all_rows, folder)
            print(f"Saved {len(all_rows)} rows to {folder}")
    return all_rows, folder

if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("query")
    parser.add_argument("--pages", type=int, default=2)
    parser.add_argument("--proxy", action="store_true")
    args = parser.parse_args()
    try:
        scrape(args.query, args.pages, args.proxy)
    except (requests.RequestException, RuntimeError, ValueError) as error:
        message = str(error) if not isinstance(error, requests.RequestException) else type(error).__name__
        raise SystemExit("Stopped: " + message)
Полный запуск и контроль качества
Основной цикл должен ограничивать число страниц, делать паузу и прекращать повторяющиеся URL. Пример запуска:
python bing_scraper.py "документация Python" --pages 2
Результаты появятся в отдельной папке runs/ГГГГММДД-ЧЧММСС-...: там будут исходные HTML, results.json и results.csv. Для сравнения запусков фиксируйте время UTC, версии библиотек, регион сетевого выхода и фактический URL ответа.
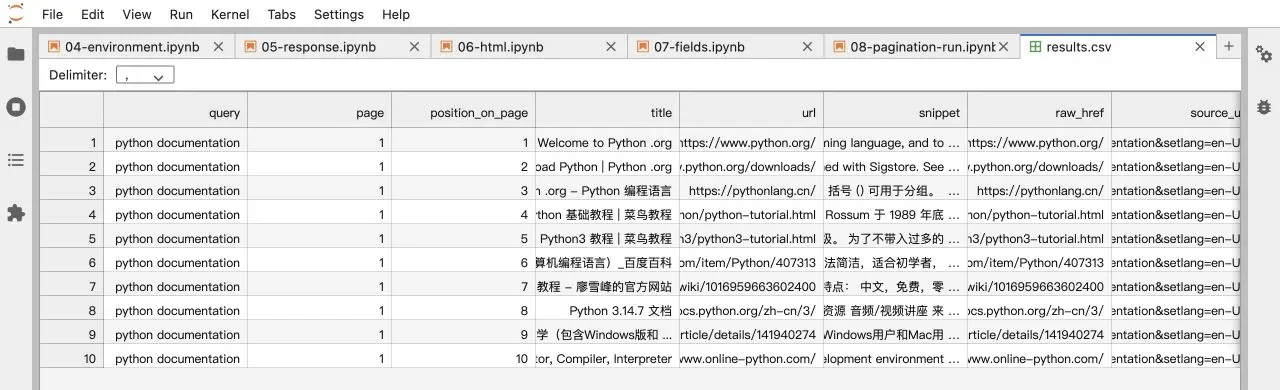
Откройте CSV в JupyterLab или Excel и сопоставьте первую запись с HTML той же папки. Если один URL встретился на нескольких страницах, решение о дедупликации зависит от задачи: для покрытия сайтов URL можно объединять, для анализа позиций лучше сохранить каждое появление.
Если исследуете другую языковую выдачу, меняйте запрос, setlang и Accept-Language вместе. Языковые настройки не определяют географию сетевого выхода.
Типичные ошибки
| Симптом | Проверка | Действие |
|---|---|---|
| HTTP 200, но органики нет | CAPTCHA или новая разметка в сохранённом HTML | Остановиться и изучить ответ |
| 403 или 429 | Частота запросов и разрешение на сбор | Не продолжать перебор прокси |
407 или ProxyError |
Схема, порт, авторизация, whitelist | Сверить настройки с кабинетом |
Редирект на cn.bing.com |
Регион и условия запроса | Записать фактический домен |
| Вторая страница повторяет первую | Цепочка href и сигнатура результатов |
Остановить цикл |
| Браузер и Python показывают разное | Cookies, язык, регион, время, клиент | Не смешивать разные запуски |
| В Excel нечитаемый текст | Кодировка импорта | Выбрать UTF-8 и сохранить JSON |
При новом запросе сначала скачайте одну страницу и сравните HTML с первыми тремя строками CSV.
Когда лучше использовать SERP API
HTML-парсер подходит для небольших проверок и изучения структуры. Для большого числа запросов, нескольких устройств, рекламных блоков и стабильной схемы данных сравните SERP API по покрытию, цене, условиям использования и обработке ошибок.
Прежние Bing Search APIs Microsoft были закрыты 11 августа 2025 года — см. объявление Microsoft. Среди сторонних вариантов документация DataForSEO Bing SERP API различает немедленный Live-режим и Standard-режим с очередью. При использовании API проверяйте статус задачи и выбирайте записи типа organic.
Итоги
Надёжный сбор выдачи Bing начинается с чёткого определения записи. Найдите контейнер органики, извлекайте заголовок, конечную ссылку и сниппет по отдельности, сохраняйте исходный HTML и время. При пагинации отслеживайте повторения, а сетевой выход Rola IP подключайте только как часть общей схемы измерений. Так вы получите проверяемый набор данных, а не просто скрипт, который иногда завершается без ошибки.