
Парсинг изображений Naver с Python: API, ссылки и экспорт в CSV
9 окт. 2026 г. · Руководства · 6 мин. чтения
Для парсинга изображений Naver в виде структурированных метаданных используйте официальный Image Search API. Для него понадобятся Client ID и Client Secret приложения Naver Developers. Пример ниже сохраняет названия, ссылки на изображения, URL миниатюр и размеры в CSV. За один запуск скрипт запрашивает до 1000 записей, сохраняет дубликаты URL и не скачивает сами файлы. Если нужно изучить карточки и предпросмотр именно в браузере, используйте браузерную автоматизацию.
Что находится на странице поиска изображений Naver
Откройте результаты поиска Naver по запросу seoul skyline. В верхней части находится строка поиска, а ниже — вкладка изображений. В каждой карточке отображаются миниатюра, заголовок и домен источника. Нажатие на карточку открывает увеличенный просмотр и сведения об источнике справа.
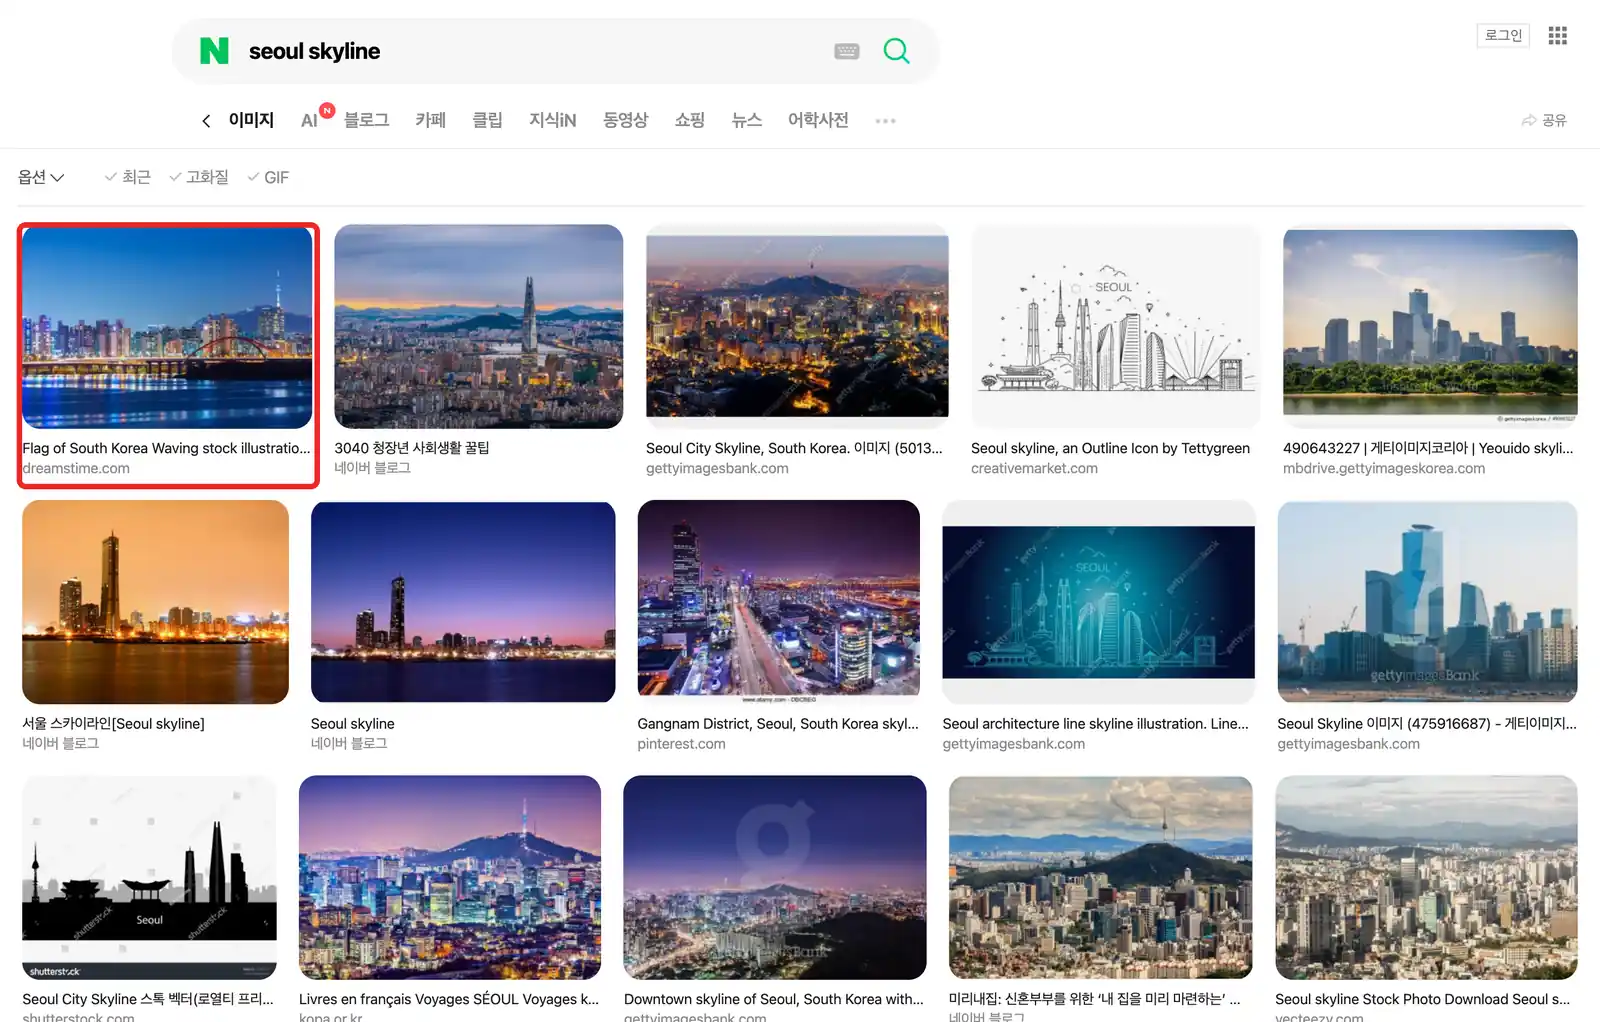
Рисунок 1. Страница результатов поиска изображений Naver.
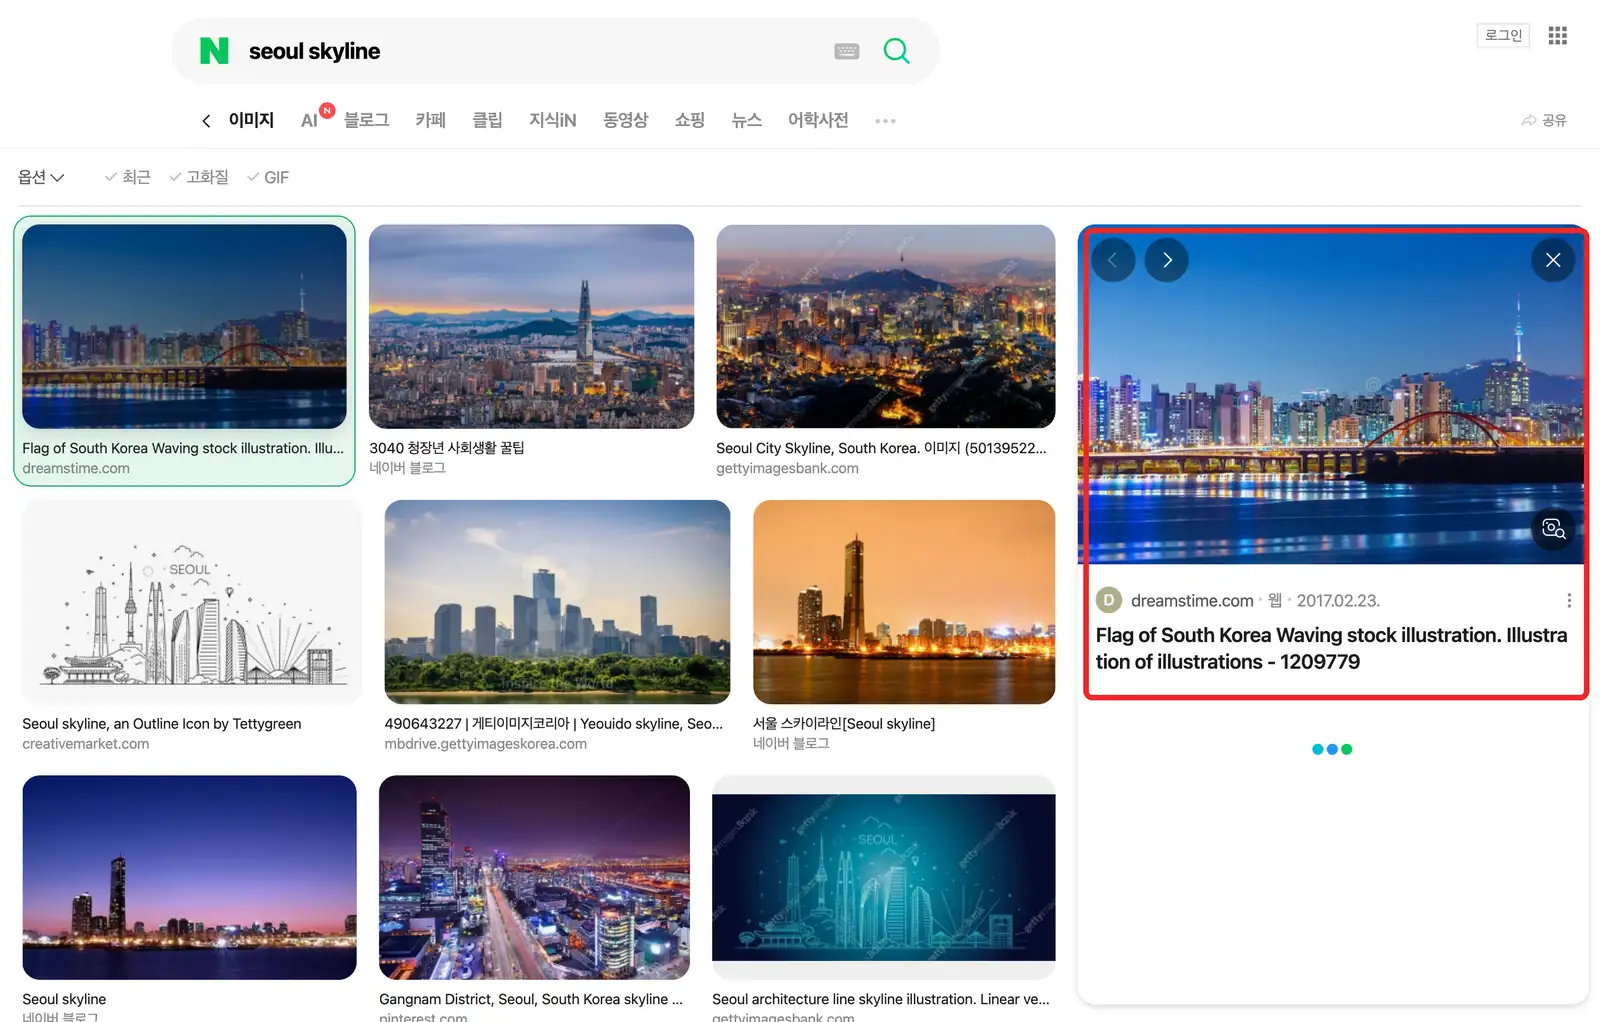
Рисунок 2. Предпросмотр после выбора результата.
Порядок и количество карточек на странице могут отличаться от ответа API. Для повторной проверки записывайте поисковую фразу, время запуска и параметры запроса.
API Naver или парсинг страницы: что выбрать
Официальная документация Naver Image Search API описывает GET-эндпоинт https://openapi.naver.com/v1/search/image. Запрос требует Client ID и Client Secret в HTTP-заголовках и возвращает массив items. В каждой записи могут быть поля title, link, thumbnail, sizewidth и sizeheight.
| Способ | Когда подходит | Что учитывать |
|---|---|---|
| Официальный Image Search API | Массовый сбор метаданных с пагинацией | Нужны ключи, действует квота и ограничения полей |
| Чтение страницы в браузере | Анализ карточек, предпросмотра и поведения интерфейса | HTML меняется, ленивую загрузку нельзя считать полной выдачей |
| Скачивание файлов | Получение файлов изображений | Условия использования зависят от источника и лицензии |
Если нужно собрать обычную поисковую выдачу, обратитесь к руководству по парсингу результатов поиска Bing, где показано извлечение заголовков, ссылок и сниппетов из HTML.
Image Search, Maps и Shopping — разные сервисы. Ответ /v1/search/image нельзя использовать как данные о товарах или координатах.
Шаг 1. Зарегистрируйте приложение и проверьте параметры API
Создайте приложение в Naver Developers, включите Search API и получите Client ID и Client Secret. Храните ключи в переменных окружения. По документации, параметр query обязателен, display задаёт от 1 до 100 результатов на страницу, start — позицию от 1 до 1000, а sort принимает sim или date. В этом примере один запуск ограничен 1000 запрошенными записями.
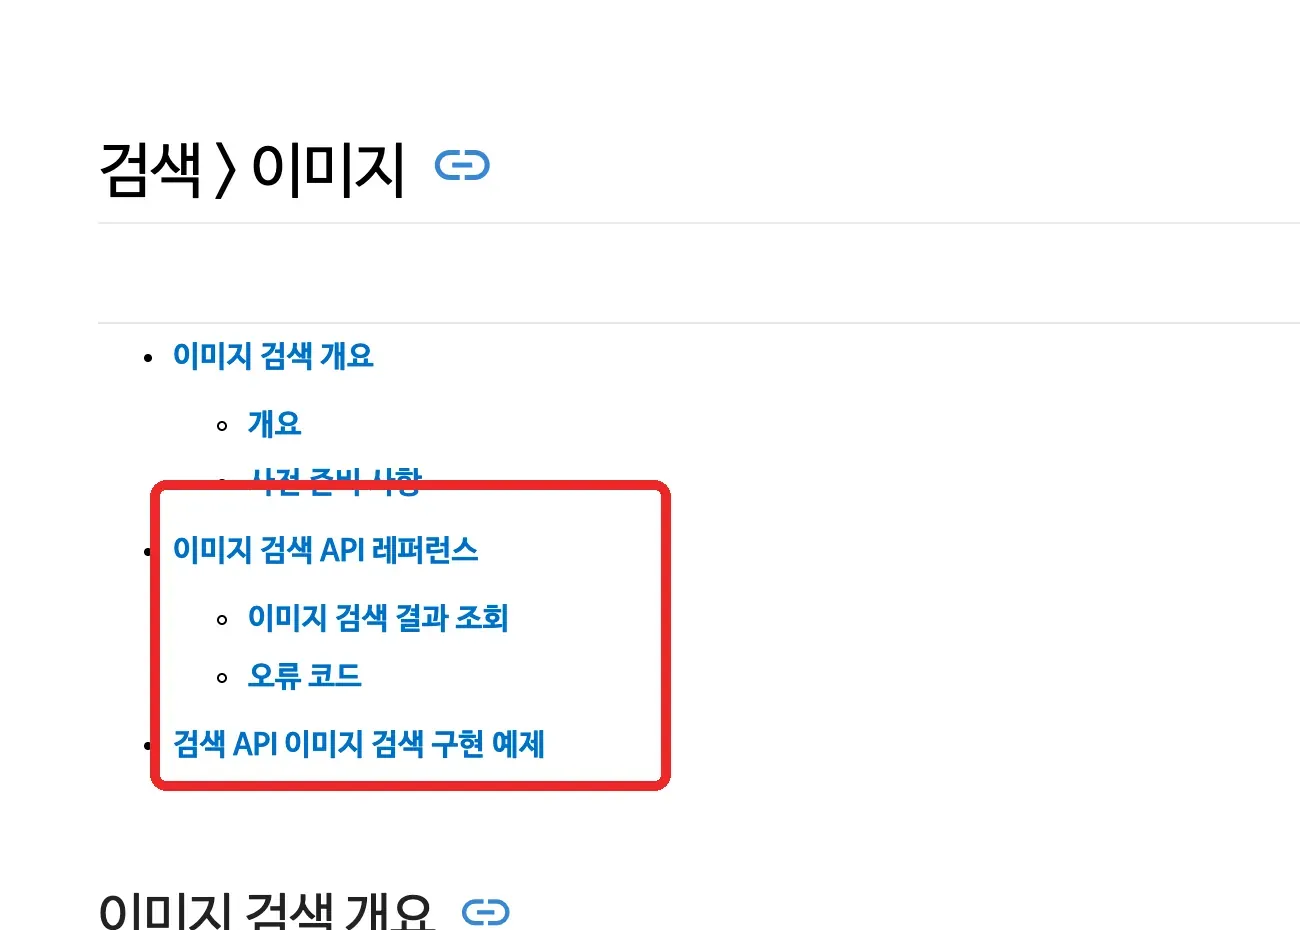
Рисунок 3. Документация API Naver Developers.
В таблице полей link — URL изображения, thumbnail — URL миниатюры, sizewidth и sizeheight — размеры в пикселях. title — заголовок документа, на котором найдено изображение, а не обязательно его официальное название. API передаёт размеры строками, поэтому экспорт сохраняет исходные значения.
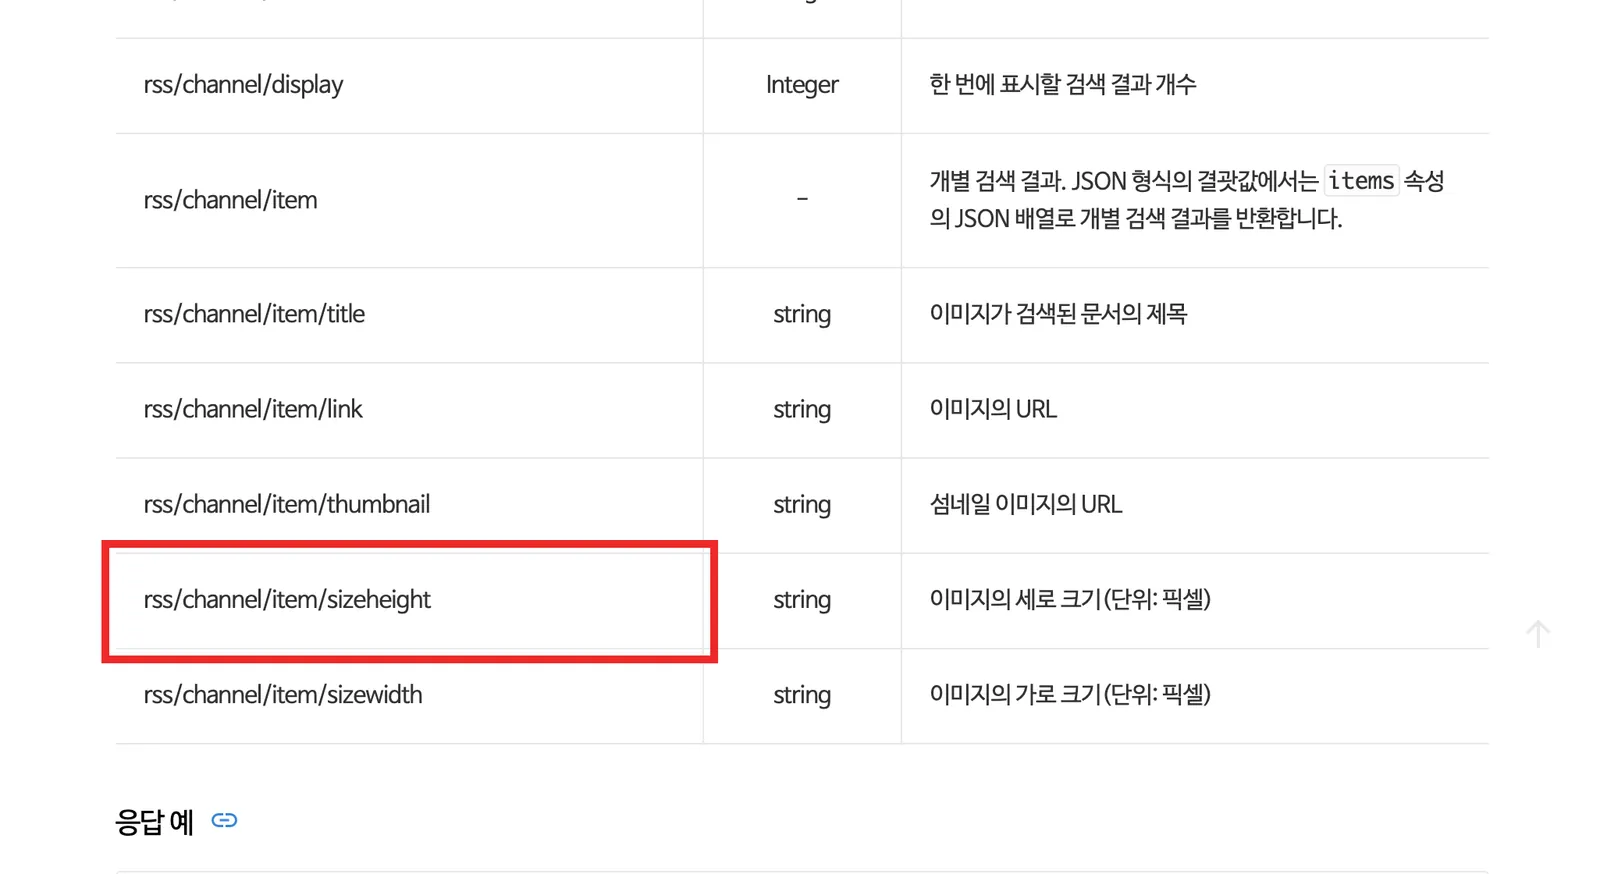
Рисунок 4. Описание полей ответа API.
Шаг 2. Подготовьте Python и переменные окружения
Создайте виртуальное окружение, установите requests и задайте ключи только в текущей сессии терминала.
macOS/Linux:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requests
export NAVER_CLIENT_ID='ваш Client ID'
export NAVER_CLIENT_SECRET='ваш Client Secret'
Windows PowerShell:
py -m venv .venv
.\.venv\Scripts\python.exe -m pip install requests
$env:NAVER_CLIENT_ID = 'ВАШ_CLIENT_ID'
$env:NAVER_CLIENT_SECRET = 'ВАШ_CLIENT_SECRET'
Переменные действуют только в открытом окне терминала. Перед запуском убедитесь, что Search API включён в настройках приложения.
Шаг 3. Соберите заголовки, URL и размеры через Python
Сохраните код в naver_image_api.py. Скрипт читает ключи из переменных окружения и передаёт их в HTTP-заголовках; подробнее о настройке заголовков в Python Requests рассказано в отдельном руководстве. Он отправляет страницы с start=1,101,201..., проверяет каждый ответ через raise_for_status() и завершает работу с ненулевым кодом при ошибке. Частичный CSV не записывается, а существующий файл остаётся без изменений. HTML-теги в заголовках удаляются, а кодировка utf-8-sig помогает Excel корректно показать корейские и китайские символы.
"""Экспорт метаданных Naver Image Search API в CSV."""
import argparse
import csv
import os
import re
from html import unescape

import requests

API_URL = "https://openapi.naver.com/v1/search/image"
FIELDNAMES = ["query", "title", "image_url", "thumbnail_url", "width", "height"]


def clean_title(value):
    return unescape(re.sub(r"<[^>]+>", "", value or ""))


def fetch_images(query, limit, client_id, client_secret, session=None):
    if not 1 <= limit <= 1000:
        raise ValueError("limit должен быть от 1 до 1000")
    http = session or requests.Session()
    headers = {
        "X-Naver-Client-Id": client_id,
        "X-Naver-Client-Secret": client_secret,
    }
    rows = []
    for start in range(1, limit + 1, 100):
        display = min(100, limit - len(rows))
        response = http.get(
            API_URL,
            headers=headers,
            params={"query": query, "display": display, "start": start, "sort": "sim"},
            timeout=20,
        )
        response.raise_for_status()
        payload = response.json()
        items = payload.get("items", [])
        for item in items:
            rows.append({
                "query": query,
                "title": clean_title(item.get("title")),
                "image_url": item.get("link", ""),
                "thumbnail_url": item.get("thumbnail", ""),
                "width": item.get("sizewidth", ""),
                "height": item.get("sizeheight", ""),
            })
        if len(items) < display:
            break
    return rows


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("query", help="поисковая фраза, например: seoul skyline")
    parser.add_argument("--limit", type=int, default=100)
    parser.add_argument("--output", default="naver_images.csv")
    args = parser.parse_args()
    client_id = os.environ.get("NAVER_CLIENT_ID")
    client_secret = os.environ.get("NAVER_CLIENT_SECRET")
    if not client_id or not client_secret:
        parser.error("сначала задайте NAVER_CLIENT_ID и NAVER_CLIENT_SECRET")
    if not args.query.strip():
        parser.error("query не должен быть пустым")
    if not 1 <= args.limit <= 1000:
        parser.error("limit должен быть от 1 до 1000")
    try:
        rows = fetch_images(args.query, args.limit, client_id, client_secret)
    except requests.HTTPError as exc:
        response = exc.response
        status = response.status_code if response is not None else None
        advice = {
            400: "проверьте query, display, start и sort",
            401: "проверьте Client ID и Client Secret",
            403: "проверьте разрешения приложения и включение Search API",
            429: "проверьте квоту и частоту запросов; прокси квоту не увеличивает",
        }.get(status, "проверьте статус API и документацию")
        if status == 429 and response is not None:
            retry_after = response.headers.get("Retry-After")
            if retry_after:
                advice += f" Retry-After: {retry_after}."
        parser.exit(1, f"Ошибка API (HTTP {status}): {advice}\nCSV не записан.\n")
    except requests.Timeout:
        parser.exit(1, "Истекло время ожидания. CSV не записан.\n")
    except requests.RequestException:
        parser.exit(1, "Ошибка запроса или обработки ответа. CSV не записан.\n")
    with open(args.output, "w", encoding="utf-8-sig", newline="") as file:
        writer = csv.DictWriter(file, fieldnames=FIELDNAMES)
        writer.writeheader()
        writer.writerows(rows)
    print(f"Сохранено строк: {len(rows)}; файл: {args.output}")


if __name__ == "__main__":
    main()
Пример запуска:
python naver_image_api.py 'seoul skyline' --limit 120 --output naver_images.csv
В PowerShell:
.\.venv\Scripts\python.exe naver_image_api.py 'seoul skyline' --limit 120 --output naver_images.csv
В терминале появится сообщение с фактическим числом строк. Оно может быть меньше 120, если API вернул меньше результатов.
Как рассчитывается пагинация
При limit=250 выполняется максимум три запроса: start=1, display=100, затем start=101, display=100 и start=201, display=50. Если вторая страница содержит только 30 записей, третий запрос не выполняется.
Удаляет ли скрипт дубликаты URL
Нет. Экспортируются все записи API, включая повторяющиеся image_url. Если нужен один ряд на изображение, удалите дубликаты в CSV по этому столбцу. При объединении нескольких запросов сохраняйте исходные поисковые фразы.
Шаг 4. Проверьте CSV по ответу API
Сопоставьте столбцы: title соответствует title, image_url — link, thumbnail_url — thumbnail, width и height — sizewidth и sizeheight. Проверьте несколько заголовков, непустые URL и размеры.
Для Excel можно открыть CSV двойным щелчком или импортировать через «Данные → Из текста/CSV» с кодировкой UTF-8. utf-8-sig обычно снижает риск искажённых корейских символов.
Когда браузерная автоматизация лучше API
Если нужно изучить реально показанные карточки, боковую панель предпросмотра или загрузку после прокрутки, используйте Playwright или Selenium: дождитесь появления карточек, после каждой прокрутки ждите стабилизации их количества, затем сохраняйте заголовки, миниатюры и источники. Селекторы Naver со временем меняются, поэтому их нужно проверять на актуальной странице.
Как Rola IP помогает при исследовании Naver
Для официального API начните с прямого подключения: прокси не заменяет Client ID и Client Secret и не расширяет квоту. Rola IP пригодится, если вы сравниваете результаты страницы изображений в браузере из разных регионов. Подробнее — в руководстве по региональному тестированию Naver.
Инструкции по настройке хоста, порта, логина и пароля приведены в быстром старте Rola IP. Руководство по динамическим резидентным прокси описывает выбор страны, штата и города; доступность локаций зависит от текущего пула.
Для одного сравнения используйте одинаковый ID сессии и задайте sessiontime на время измерения. Согласно документации по параметрам прокси, поддерживается диапазон от 1 до 120 минут; в примере документации указано sessiontime-10. В течение заданного времени сервис пытается сохранять тот же IP, но не гарантирует его неизменность. Для независимых тестов используйте разные ID сессии; -f-1 меняет IP на каждый запрос и не подходит для сравнения с постоянным выходом.
Записывайте запрос, регион, фактический IP и локацию, ID сессии, время, браузер, язык, статус входа и URL. Расширение прокси в браузере не настраивает отдельный процесс Python requests.
Частые ошибки
| Симптом | Что проверить | Действие |
|---|---|---|
| Нет ключей | Переменные окружения в текущем терминале | Задайте их заново, не встраивайте в код |
| HTTP 401/403 | Client ID, Secret и разрешения Search API | Проверьте приложение в кабинете разработчика |
| HTTP 400 | query, display, start, sort |
Сверьте значения с документацией |
| HTTP 429 | Суточную квоту и частоту запросов | Учитывайте Retry-After и снизьте частоту запросов |
Строк меньше limit |
Фактическое число items |
Проверьте запрос и ответ этого запуска |
| URL не открывается | Изменение ссылки или ограничения источника | Сохраните метаданные и отдельно проверьте источник |
Naver разделяет суточные ограничения и лимиты запросов в секунду в справочнике ошибок API. Пример не выполняет автоматические повторы после ошибки.
Итоги
Для структурированного экспорта используйте Image Search API: скрипт сохраняет заголовки, ссылки, миниатюры и размеры в CSV с пагинацией до 1000 запрошенных записей. Для анализа карточек, предпросмотра и региональных различий открывайте страницу в браузере. При сравнении выдачи из разных регионов Rola IP помогает управлять сетевой локацией браузера.